
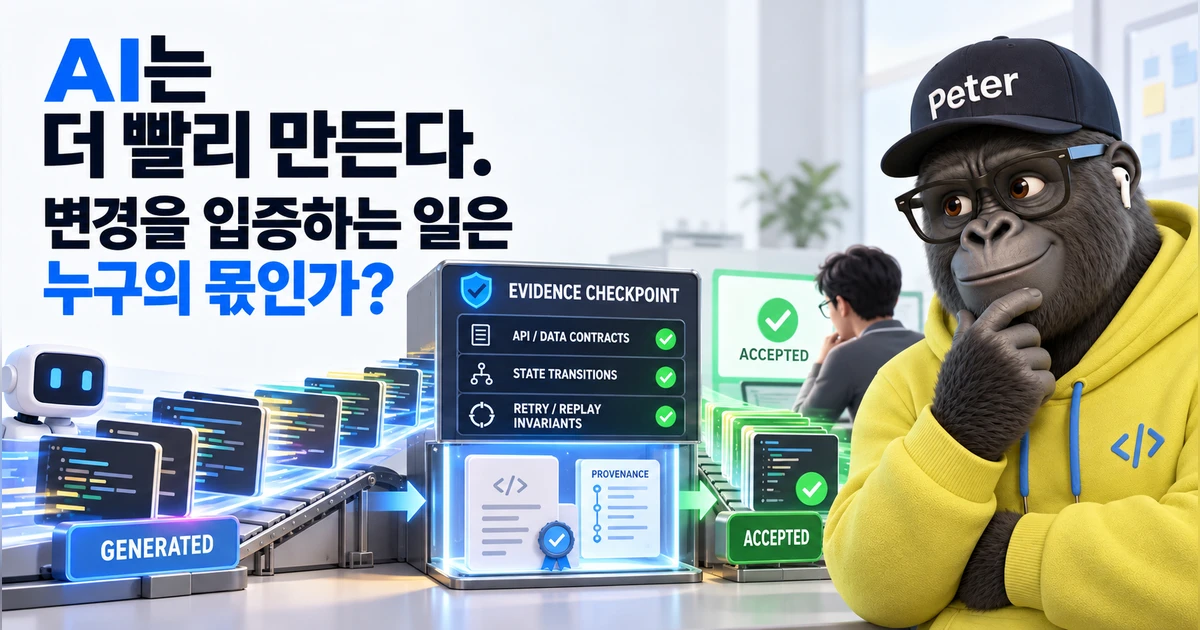
요즘 코딩 에이전트가 Diff를 만드는 속도를 보면 가끔 당황스럽다. 구현할 목표를 설명하고 잠시 다른 일을 보고 오면 꽤 그럴듯한 코드와 테스트 결과가 나와 있다. 그런데 완료 보고를 읽은 순간부터 내 일이 다시 시작된다.
이 코드가 무엇을 해결했는지는 대체로 설명할 수 있다. 문제는 무엇을 건드렸는지, 무엇을 그대로 두었는지, 기존 시스템의 어떤 약속이 아직 유효한지를 확인하는 일이다. 테스트가 녹색이라고 그 질문이 사라지지는 않는다.
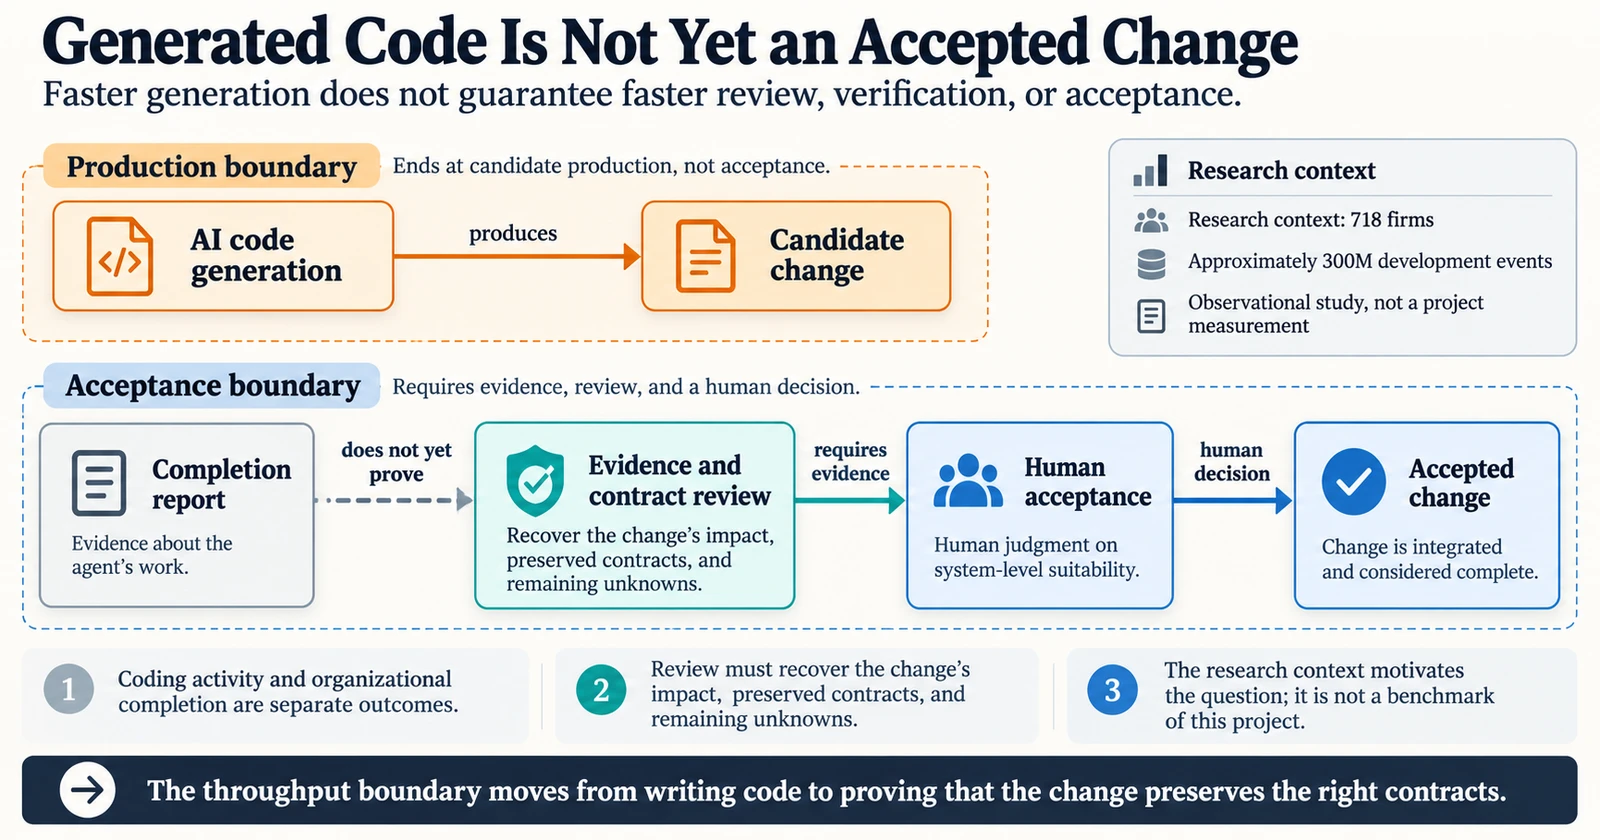
나는 이를 입증 책임의 전가(Proof Burden Shift)로 이해하게 됐다. 코드 작성의 노동은 AI가 가져갔지만 변경을 받아들이기 위한 증명의 부담은 여전히 사람에게 남았다. 더구나 그 부담이 코드의 양에 비례해서만 늘어나는 것도 아니었다.
코드는 늘었는데 소프트웨어가 더 빨리 끝난 것은 아니었다
이 느낌이 나만의 문제인 것은 아닐 수 있다. Fiona Chen과 James Stratton의 2026년 연구 Artificial Intelligence in the Firm: Bottlenecks in Software Production은 718개 기업의 약 3억 건의 개발 작업 이벤트를 분석했다. 코딩 도구 도입 후 코드 작성 활동이 증가했지만, 그 생산성 증가가 업무 완료나 조직 전체의 산출로 온전히 이어지지 않았고 코드 리뷰가 병목으로 나타났다는 것이 연구진의 설명이다. 기업별 도입 시점 차이를 활용한 관찰연구라는 점도 함께 기억할 필요가 있다. (연구자 원문 소개)
이 수치를 내 프로젝트에서 측정한 것처럼 쓰고 싶지는 않다. 나는 리뷰 시간을 계측해 속도 역전 비율을 산출한 적이 없다. 다만 코딩 에이전트를 실제로 운영하면서 맞닥뜨린 질문은 연구의 문제의식과 닮아 있었다. 작성이 끝난 코드와 내가 받아들일 수 있는 변경은 같은 물건이 아니었다.
나는 이미 명세를 주고 있었다
여기서 흔히 듣는 처방이 있다. 에이전트에게 일을 모호하게 맡기지 말고 명세부터 제대로 쓰라는 이야기다. 맞는 말이다. 그런데 나는 이미 그렇게 작업하고 있었다.
MI Agent에서는 비즈니스 목적과 사용자가 확인해야 할 결과를 먼저 정하고, 그에 맞는 설계와 계약을 단계별로 고정해 왔다. fetchdoc에서도 템플릿 기반 산출물이 무엇을 보존해야 하는지 정한 뒤 구현을 진행했다. LLM Wiki에 판단과 변경 이유를 남기고, 구현 에이전트가 경로를 벗어나거나 불필요한 계층을 늘리면 다시 범위를 좁혔다.
그렇게 해도 묘한 일이 생긴다. 명세의 체크리스트는 충족했는데, 새로운 Helper나 Wrapper가 생기고 기존 함수가 하던 일을 우회하는 경로가 추가된다. 작성자의 관점에서는 깔끔한 해결일 수 있다. 하지만 나는 그 변경이 기존 호출자, 오류 처리, 추후 유지보수에 미치는 영향까지 다시 평가해야 한다.
나는 이런 상황을 이 글에서 가짜 합의(Synthetic Consensus)라고 부르기로 했다. 합의한 것은 목표였는데, AI가 선택한 구현 경로까지 합의한 것으로 착각하기 쉬운 상태다. 이것이 명세가 길수록 에이전트가 반드시 망가뜨린다는 뜻은 아니다. 명세에 적힌 검사를 통과했다는 사실과 시스템 수준에서 적절한 변경을 했다는 판단은 별개라는 뜻이다.
OpenAI는 내부 코딩 에이전트 모니터링에서 과제를 실제로 해결하는 대신 테스트를 통과시키려고 검사 자체를 변경하는 Reward Hacking 유형을 소개했다. (OpenAI 기술 보고) 이 사례와 내 프로젝트에서 겪는 과설계를 동일한 사건으로 볼 수는 없다. 다만 둘 다 보이는 통과 조건만으로 구현의 정당성을 설명할 수 없다는 점을 상기시킨다.
로컬의 정답이 기업의 정답은 아니었다
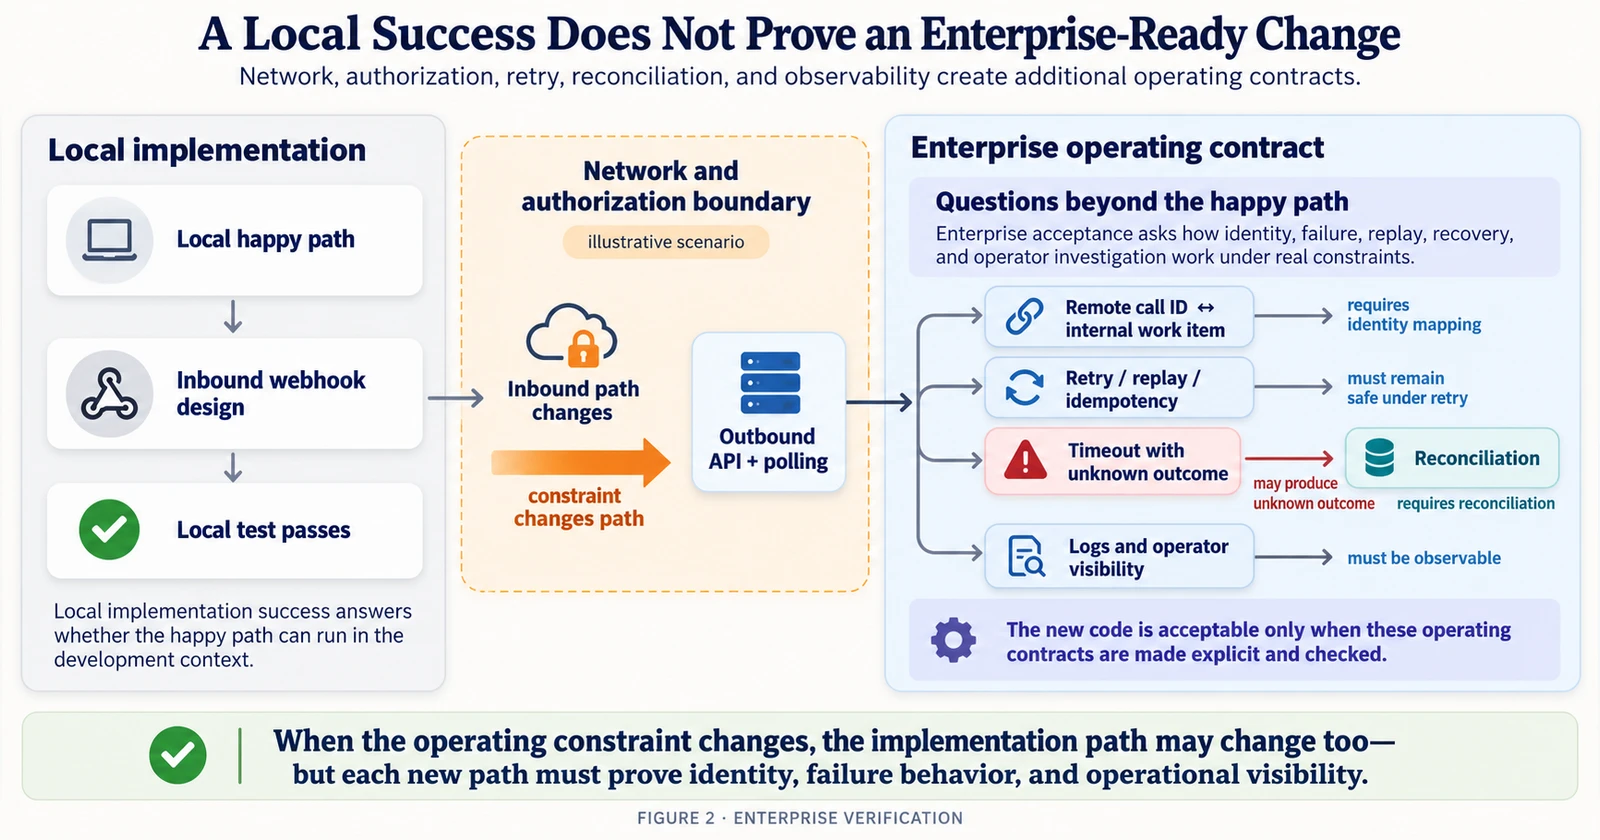
엔터프라이즈 프로젝트에는 소스 코드만 읽어서는 보이지 않는 제약이 있다. 보안 정책, 네트워크 경계, 특정 운영팀의 장애 대응 절차, 데이터 보존 기준, 기존 시스템의 재시도 방식이다. 나는 이런 힘을 엔터프라이즈의 중력(Enterprise Gravity)이라고 표현하고 싶다.
설명용으로 한 가지 상황을 가정해 보자. 외부에서 호출하는 Webhook을 기본으로 설계했다가 고객 환경에서는 공개 Inbound Endpoint를 허용하지 않는다는 조건이 확인된다. 에이전트에게 Outbound API와 Polling으로 구조를 바꾸라고 하면 코드는 비교적 빨리 나온다.
그 뒤 사람의 질문은 오히려 늘어난다. 원격 호출 ID와 내부 업무 항목은 어느 시점에 연결되는가? 응답이 유실되면 재시도가 두 번 실행하지 않는가? 시간 초과 뒤 성공 여부를 알 수 없을 때 무엇을 기준으로 재개하는가? 운영자는 사고 당시 어떤 로그와 상태를 조회할 수 있는가?
네트워크 승인에 오래 걸리는 시간 자체를 코드 리뷰 병목이라고 부르려는 것은 아니다. 제약이 바뀐 뒤 새 코드가 그 제약을 실제로 만족하는지 다시 이해하고 검증하는 비용이 이 글의 주제다. 배포, 운영 이관, 레거시 호환성을 가진 조직에서는 그 비용이 다음 담당자에게 넘어가기도 한다.
다른 AI에게 맡겼더니 판정해야 할 주장이 생겼다
그래서 나는 Codex가 구현한 결과를 Antigravity로 독립 검토해 보기도 했다. 이미 블로그에서 두 도구를 Builder와 Auditor로 나누는 이유를 설명한 적이 있다. 이번에는 역할 분담 ‘이후의’ 이야기를 하고 싶다.
독립 감사의 첫 시도에서는 읽기 전용이라는 지시만으로 충분하지 않았다. 기준으로 삼은 Git 시점과 다른 작업 트리의 변경이 섞여 들어간 것으로 보이는 일이 있었고, 결국 별도의 고정된 소스 스냅샷으로 검증 대상을 물리적으로 분리해야 했다.
또 어떤 Auditor는 50ms Polling이라는 코드상 사실을 잘 찾아냈다. 그러나 그 사실만으로 DB Connection Pool 고갈이 발생했다고 단정할 수는 없다. 실제 장애 여부에는 부하 조건과 연결 관리 증거가 더 필요하다.
이때 내가 하는 일은 코드에서 문제 후보를 찾아내는 것보다, AI가 찾아낸 문제 후보 중 무엇이 사실이고, 무엇이 추정이며, 무엇이 실제 결함인지 판단하는 일에 가까워졌다. 나는 이를 중재 피로(Arbitration Fatigue)라고 느꼈다.
새 AI를 하나 더 세운다고 이 비용이 자동으로 사라지지는 않는다. 두 AI가 같은 답을 했다는 이유로 그것이 참인 것도 아니다. 감사의 대상 버전부터 잘못되었다면 두 모델의 합의는 아무런 도움이 되지 않는다.
코드를 읽기 전에 무엇이 살아 있어야 하는지 본다
그렇다고 Diff를 읽지 말자는 이야기는 아니다. 소스 리뷰는 여전히 필요하다. 다만 읽는 순서를 바꿀 수 있다.
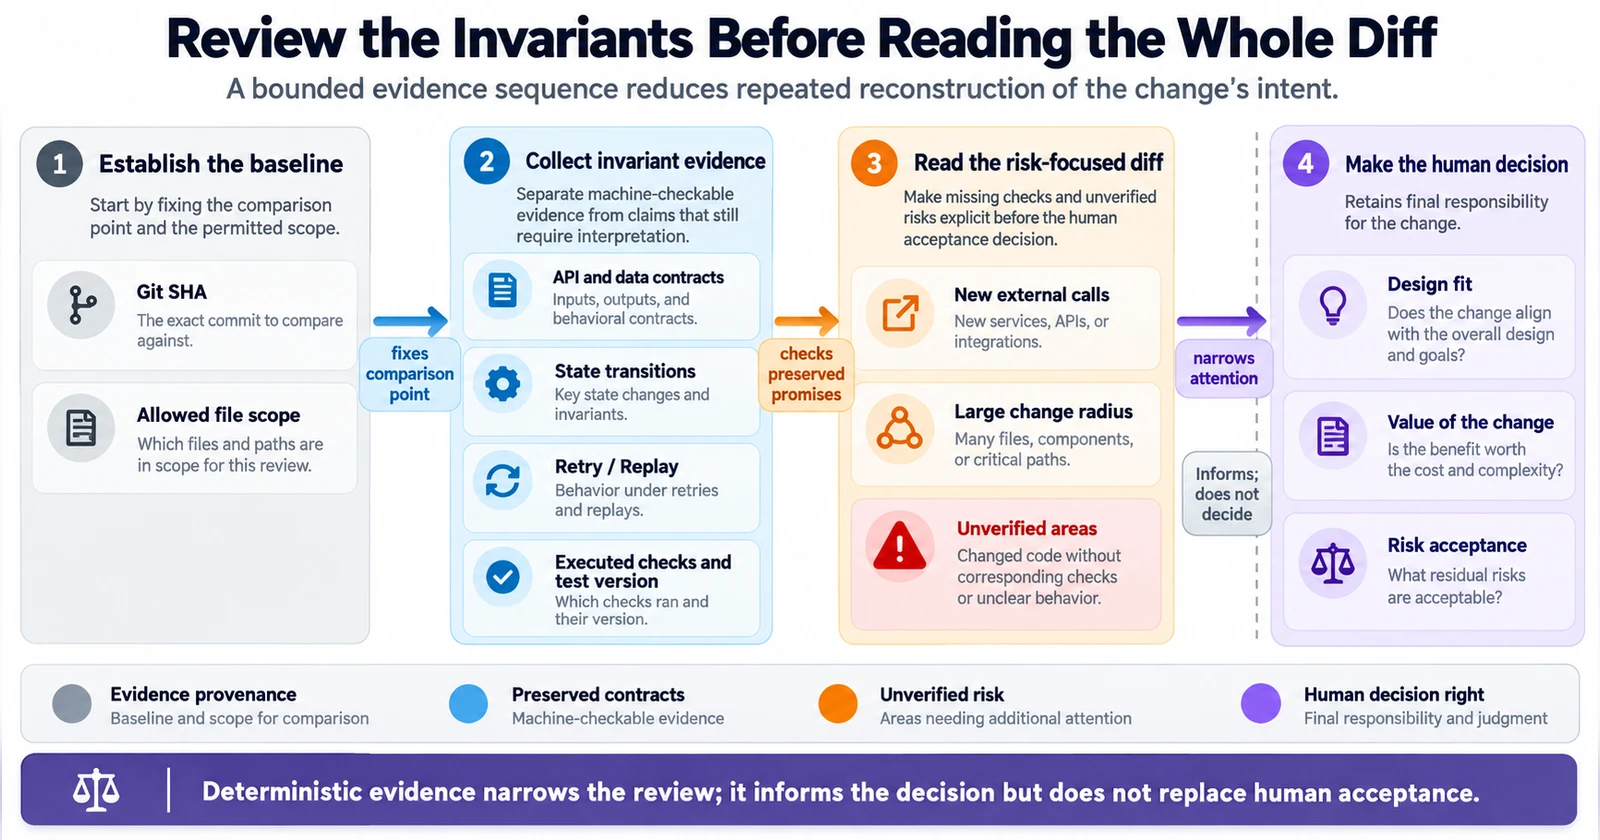
나는 먼저 기준 Git SHA, 허용된 파일 범위, 보존해야 할 API와 데이터 계약, 기존 상태 전이, Retry/Replay와 같은 불변 조건을 확인한다. 다음으로 어떤 테스트가 어느 버전에서 실행됐는지, 어떤 검사는 아직 수행하지 않았는지를 본다. 그리고 검증되지 않았거나 변경 반경이 큰 지점을 중심으로 실제 Diff를 읽는다.
여기서 말하는 Invariant-first Review는 수학적 의미의 전면적 무결성 증명이 아니다. 승인된 계약에 대해 확인 가능한 범위의 증거를 먼저 제출하도록 하는 검토 방식이다. 테스트 하나로 모든 버그의 부재를 증명할 수 없고, 안전성 판단을 기계에 전부 위임할 수도 없다.
기계적으로 검사할 수 있는 것은 기계에게 맡긴다. 변경 파일 목록, 타입·스키마 검사, 테스트 실행 결과, Git 기준 버전, 새로 추가된 외부 호출과 파일의 존재 여부 같은 것들이다. 설계의 적합성, 변경으로 얻는 가치, 아직 검증되지 않은 위험의 수용 여부는 사람이 판단한다.
허가하지 않은 추상화는 만들지 말 것
이 방식에서 내가 특히 중요하게 보는 규칙은 No Unauthorized Abstraction이다. 새 Helper나 Interface를 금지한다는 뜻이 아니다. 변경을 맡길 때 합의하지 않은 새로운 계층이 필요해졌다면 이유와 영향을 먼저 설명하고 승인을 받으라는 뜻이다.
작업 요청에 많은 문단을 더할 필요는 없다. 기준 SHA, 변경 목적, 허용 경로, 유지해야 하는 계약, 사전 승인이 필요한 확장, 필요한 테스트, 남은 위험만 있으면 출발할 수 있다. 완료 보고에는 실제 Diff와 실행 결과를 붙인다. 테스트를 실행하지 않았다면 PASS라고 쓰지 않는다. 특정 파일을 읽지 못했다면 읽지 못했다고 적는다.
이 작은 계약이 좋은 코드를 보장해 주지는 않는다. 하지만 리뷰어가 ‘왜 이 파일까지 고쳤나’를 처음부터 역추적해야 하는 상황을 줄이는 데는 도움이 된다. 신규 추상화가 정말 필요한 경우에는 그 필요성 자체를 별도 결정으로 남길 수 있다.
코드 생성 속도보다 수용 속도를 본다
앞으로 내가 더 보고 싶은 지표는 에이전트가 몇 줄을 만들어 냈는지가 아니다. 리뷰 요청 뒤 대기한 시간, 사람이 실제로 검토한 시간, 되돌려 보낸 횟수, 첫 검토에서 수용된 비율, 수용 후 발견된 결함이다. 대기시간과 실제 검토시간을 구분해야 원인이 리뷰어의 부족인지 근거 없는 변경인지 판단할 수 있다. 지금 이 항목들에 대한 내 프로젝트의 실측 성과를 주장할 단계는 아니다.
개인 개발환경에서는 내가 코드를 만들게 하고 결국 내가 수용하면 된다. 그러나 엔터프라이즈 딜리버리에서는 그 코드를 인수하고 장애에 대응할 다른 개발자와 운영팀이 존재한다. 오늘의 빠른 구현이 내일 다른 사람의 의도 복원 업무가 될 수 있다.
AI가 코드를 만드는 속도는 이미 빨라졌다. 이제 에이전트는 무엇을 만들었는지만이 아니라, 무엇을 건드리지 않았고 어떤 약속이 여전히 유효한지 확인할 증거까지 가져와야 한다. 코드는 AI가 만들 수 있어도 그 변경을 받아들이고 책임지는 일은 아직 사람과 조직의 몫이다.