
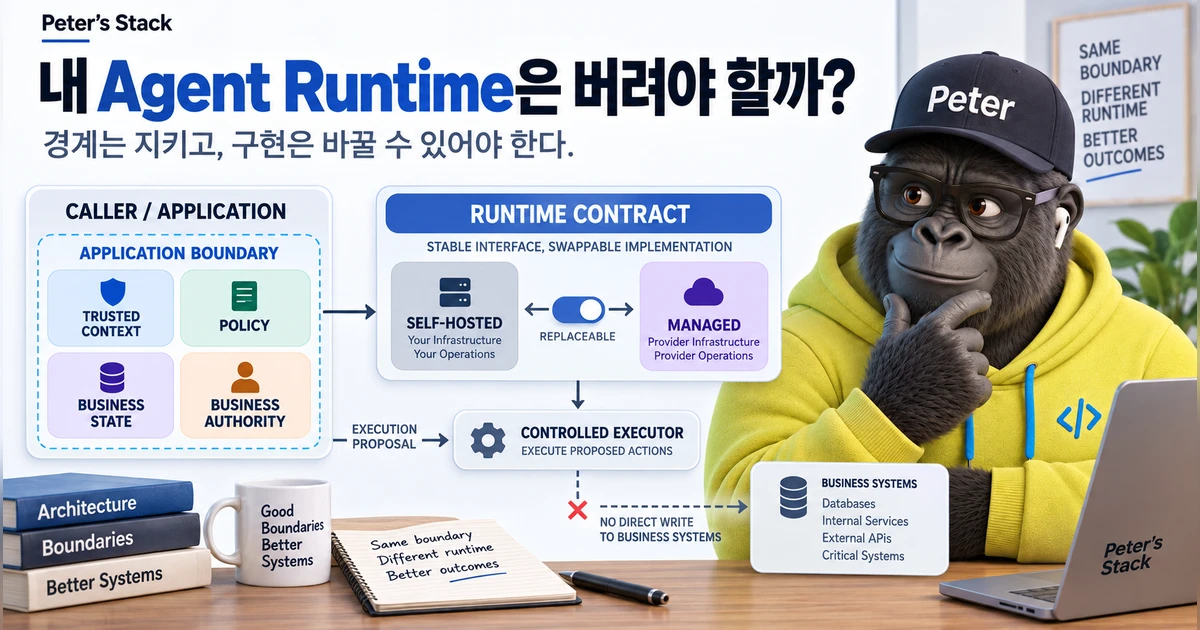
얼마 전까지만 해도 나는 Codex CLI를 서버 뒤에 두고 API처럼 호출하는 공통 Agent Runtime을 직접 만들고 있었다. Web UI든 n8n이든 Salesforce든 호출부가 무엇이든 같은 실행 엔진을 사용할 수 있게 만들고, Use Case마다 달라지는 것은 instruction과 runtime context, output contract 정도로 제한하려는 구조였다.
그런데 2026년 9월 10일 OpenAI가 Agents API를 public beta로 공개했다. Codex를 움직이던 managed harness와 장기 실행 인프라를 API로 제공하고, session과 orchestration, context management, recovery 같은 부분을 OpenAI가 맡는 구조다.
처음 든 생각은 단순했다.
“그러면 내가 만든 Agent Runtime은 이제 필요 없는 걸까?”
결론부터 말하면, 일부는 기꺼이 버릴 수 있어야 한다. 오히려 그래야 잘 만든 구조다.
내가 직접 만든 runtime의 가치가 “Codex CLI 프로세스를 서버에서 실행했다”는 구현 자체에 있었다면 managed API가 그 부분을 대체하는 것은 자연스럽다. 하지만 그동안 중요하게 잡아온 것이 Caller와 Agent를 분리하는 경계, trusted context, execution authority, deterministic state와 policy였다면 이야기가 달라진다.
이번 글에서 다루고 싶은 것은 Agents API의 기능 목록이 아니다. Agent Runtime이 managed service로 바뀌어도 어떤 책임은 교체할 수 있고, 어떤 책임은 Application에 끝까지 남겨야 하는가에 대한 이야기다.
Agent Runtime을 직접 만든 이유부터 다시 봐야 한다
내가 Codex CLI를 API 뒤에 둔 이유는 “내 서버에서 Agent를 돌리는 것” 자체가 목적이 아니었다.
현업에서 새로운 AI PoC를 시작할 때마다 모델 호출 방식, 인증, 파일 처리, tool 연결, session 관리, response formatting을 다시 붙이는 비용이 반복됐다. 실제로 줄이고 싶었던 것은 코딩 시간이 아니라 현업의 질문이 실제 동작으로 돌아오기까지의 Feedback Latency였다.
그래서 구조를 세 부분으로 나눴다.
- Stable Runtime — Agent를 호출하고 실행 상태를 관리하는 공통 기반
- Variable Agent Definition — Use Case별 instruction, tool, output contract
- Runtime Context — caller가 알고 있는 identity, record, scope, permission 같은 확정 정보
이 구조에서 중요한 점은 Codex CLI가 아니다. 중요한 것은 호출하는 애플리케이션과 실행하는 Agent 사이에 명시적인 contract를 만들었다는 것이다.
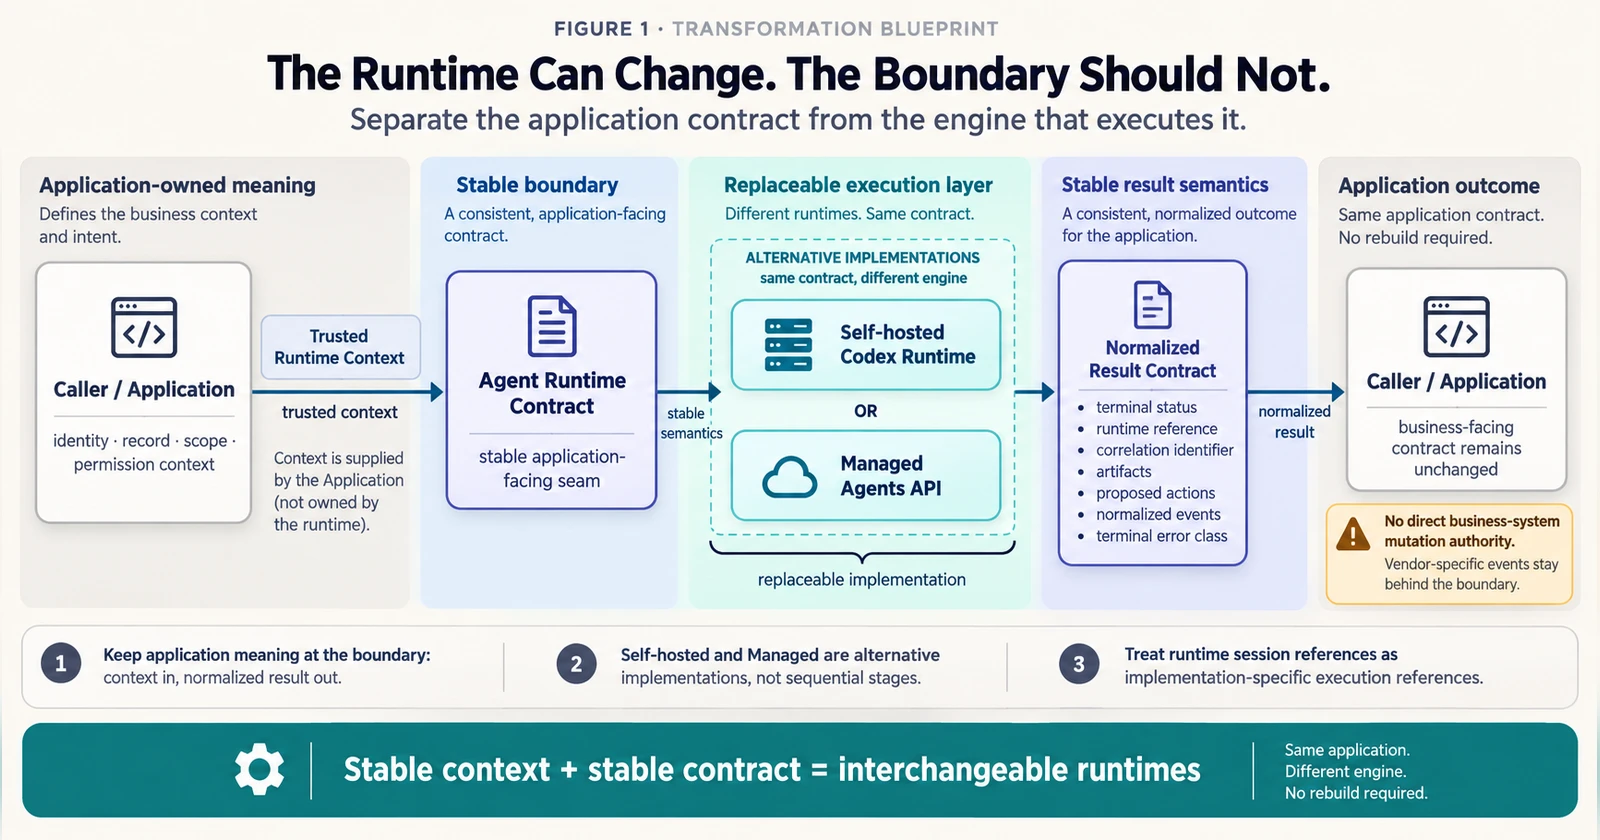
Agent 엔진은 바뀔 수 있다. GPT 계열 모델도 바뀔 수 있고, CLI가 SDK가 될 수도 있고, self-hosted process가 managed API가 될 수도 있다. 반대로 business application이 알고 있는 고객, 사용자, 레코드, 권한과 상태는 그렇게 쉽게 옮겨 다녀서는 안 된다.
Agents API가 실제로 가져가는 영역은 생각보다 크다
OpenAI의 공식 설명을 보면 Agents API는 단순히 기존 model API 위에 session ID 하나를 붙인 수준이 아니다.
OpenAI는 Agents API architecture 문서에서 managed Codex harness가 model과 tool 실행 loop를 수행하고 session을 유지한다고 설명한다. 애플리케이션은 작업을 제출하고 event를 받으며, 필요하면 function tool handler나 self-hosted environment의 lifecycle을 관리한다.
또한 Agents API overview에서는 OpenAI가 session, orchestration, context compaction, recovery를 관리하고 애플리케이션이 tool과 execution environment를 구성한다고 명시한다.
내가 self-hosted runtime에서 직접 고민했던 항목과 겹쳐보면 꽤 많은 부분이 managed layer로 이동할 수 있다.
- Agent session lifecycle
- long-running turn orchestration
- context continuation과 compaction
- execution recovery
- tool invocation coordination
- subagent orchestration
- sandbox provisioning
- file과 artifact 작업
- streaming과 webhook 기반 progress observation
이 정도면 “새로운 API endpoint가 하나 생겼다”기보다 Agent harness 자체를 직접 운영해야 하는 범위가 줄어들었다고 보는 편이 맞다.
특히 장시간 실행되는 Agent에서는 이 차이가 크다. process가 살아 있는지, session을 어떻게 이어갈지, context가 커졌을 때 무엇을 압축할지, 중간 산출물을 어떻게 보존할지, subagent를 어떻게 조율할지 같은 것은 모두 구현보다 운영에서 더 귀찮아지는 문제다.
Managed harness가 이 부분을 안정적으로 가져간다면 굳이 직접 소유할 이유가 없는 영역은 분명히 존재한다.
하지만 여기서 한 가지 착각하기 쉽다.
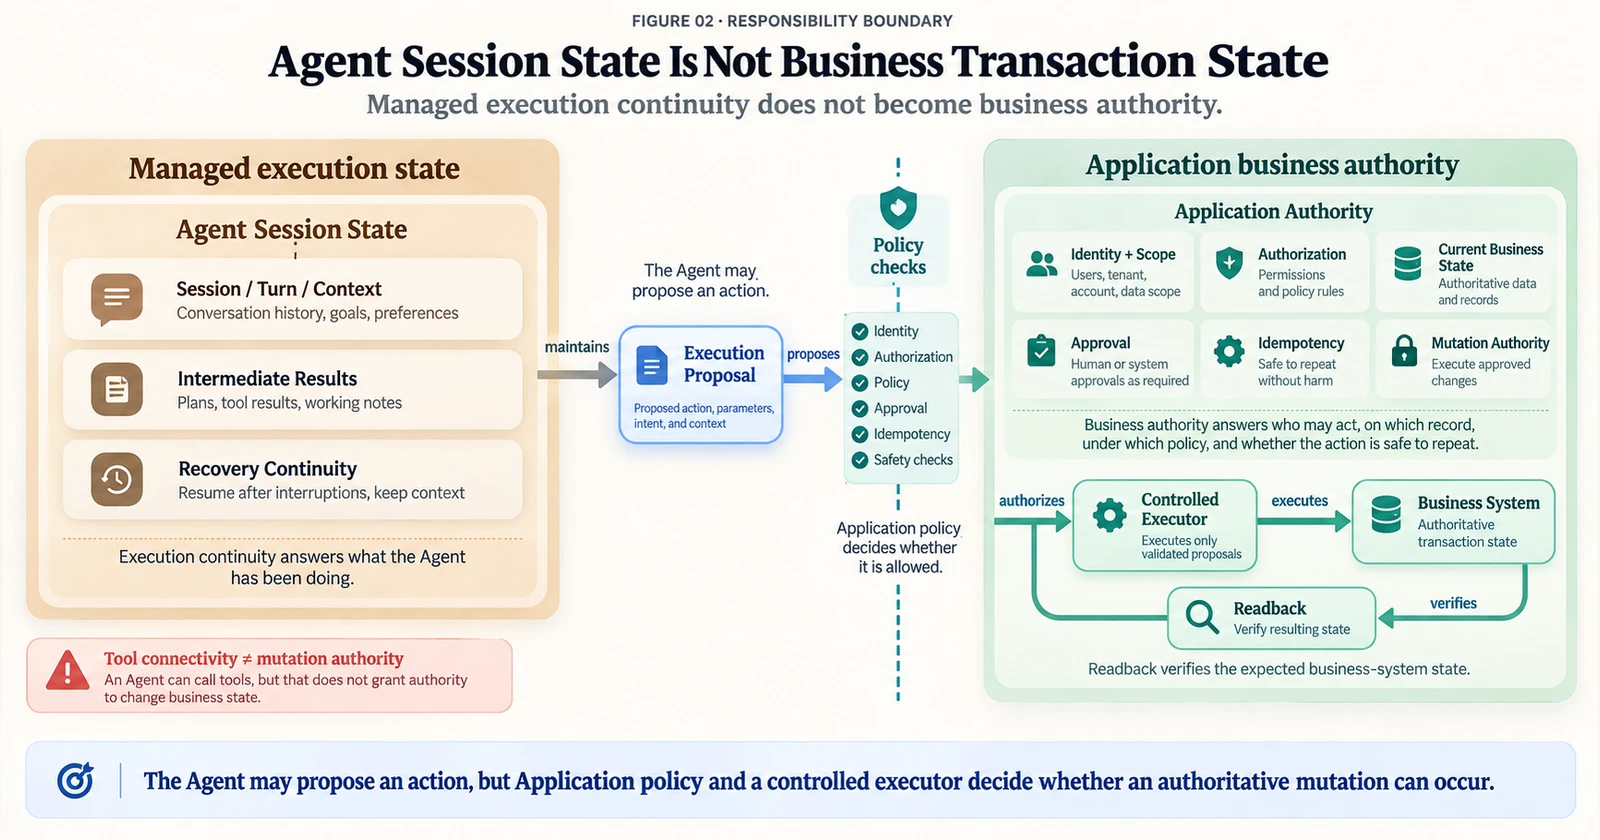
Agent의 실행 상태를 관리해 준다는 것과, 내 업무 시스템의 상태까지 안전하게 관리해 준다는 것은 전혀 다른 이야기다.
Agent Session State와 Business Transaction State는 다르다
Agents API의 session은 여러 turn에 걸쳐 대화와 작업 상태를 유지한다. stream이나 webhook으로 진행 상황을 받을 수도 있고, 완료·실패·취소 같은 turn 상태를 확인할 수도 있다.
Agent를 만드는 입장에서는 매우 편리하다.
하지만 Enterprise Application에서 더 중요한 질문은 따로 있다.
- 이 요청을 누가 시작했는가?
- 어느 tenant와 account의 데이터인가?
- 사용자가 접근할 수 있는 record 범위는 어디까지인가?
- Agent가 제안한 action을 실제로 실행해도 되는가?
- 사람의 approval이 필요한가?
- 이미 같은 mutation이 수행된 적이 있는가?
- timeout 이후 retry했을 때 side effect가 중복되지 않는가?
- 최종 authoritative state는 어느 시스템에 기록되는가?
이것은 conversation state가 아니다. Business Transaction State다.
예를 들어 Agent가 Salesforce Case를 분석해 “Category를 A로 변경하자”고 판단했다고 해보자.
Agent session에는 해당 판단 과정과 tool call, intermediate result가 잘 보존될 수 있다. 그렇다고 해서 Case가 실제로 이미 변경됐는지, 현재 사용자가 그 Case를 수정할 권한이 있는지, 동일 요청이 재시도됐을 때 다시 update해서는 안 되는지까지 Agent session이 business authority가 되는 것은 아니다.
내가 이전 글에서 MCP의 Tool Planning과 Execution Authority를 분리했던 이유도 여기에 있다.
Agent는 무엇을 해야 할지 판단할 수 있지만, 실제로 해도 되는지는 Application이 결정해야 한다.
Managed Agent Runtime이 등장해도 이 원칙은 변하지 않는다.
그래서 필요한 것은 Runtime Adapter다
이 지점에서 architecture의 목표가 조금 달라진다.
기존에는 “Agent Runtime을 어떻게 잘 만들까?”를 고민했다면, 이제는 “Agent Runtime을 어떻게 교체 가능하게 만들까?”를 고민해야 한다.
내가 그리고 있는 구조는 다음과 가깝다.
Caller / Application
→ Trusted Runtime Context
→ Agent Runtime Contract
→ Self-hosted Codex Runtime 또는 Managed Agents API
→ Controlled Executor
→ Business Systems
여기서 핵심은 가운데의 Agent Runtime Contract다.
이 contract가 특정 OpenAI API의 request schema를 그대로 복사하면 안 된다. 그러면 API가 바뀔 때 Application 전체가 함께 흔들린다.
Application이 실제로 필요로 하는 최소 semantics를 정의하는 편이 낫다.
입력에서는 다음처럼 의미를 정규화할 수 있다.
- input / instruction
- trusted context reference
- correlation identifier
- allowed capability declaration
- expected output contract
- execution policy
- resume semantics
결과에서는 다음처럼 정규화할 수 있다.
- terminal status
- runtime session reference
- correlation identifier
- artifacts
- proposed actions
- normalized execution events
- terminal error class
실제 field 이름은 중요하지 않다.
중요한 것은 Application이 특정 vendor의 session ID나 event type을 business identifier로 사용하지 않는 것이다. 내부 job ID나 correlation ID는 별도로 유지하고, managed runtime의 session ID는 implementation-specific execution reference로 취급하는 편이 안전하다.
이렇게 해야 self-hosted Codex Runtime을 사용하다가 Agents API로 바꾸더라도 Caller는 같은 의미의 contract를 유지할 수 있다.
Controlled Executor는 여전히 별도여야 한다
여기서 Agent Runtime Contract가 곧바로 Business System에 쓰기 권한을 갖는 구조로 가면 다시 경계가 무너진다.
내가 선호하는 흐름은 Agent의 결과를 Execution Proposal로 보고, 실제 side effect는 deterministic executor가 처리하는 것이다.
Agent
→ Opportunity stage 변경 제안

Application / Policy
→ user scope 확인
→ current state 확인
→ approval requirement 확인
→ idempotency key 확인

Controlled Executor
→ Salesforce mutation

Readback
→ expected state 확인
Agents API가 tool call을 잘 수행할 수 있다는 사실과 이 경계를 없애도 된다는 것은 같은 말이 아니다.
Tool connectivity와 execution authority는 여전히 다르다.
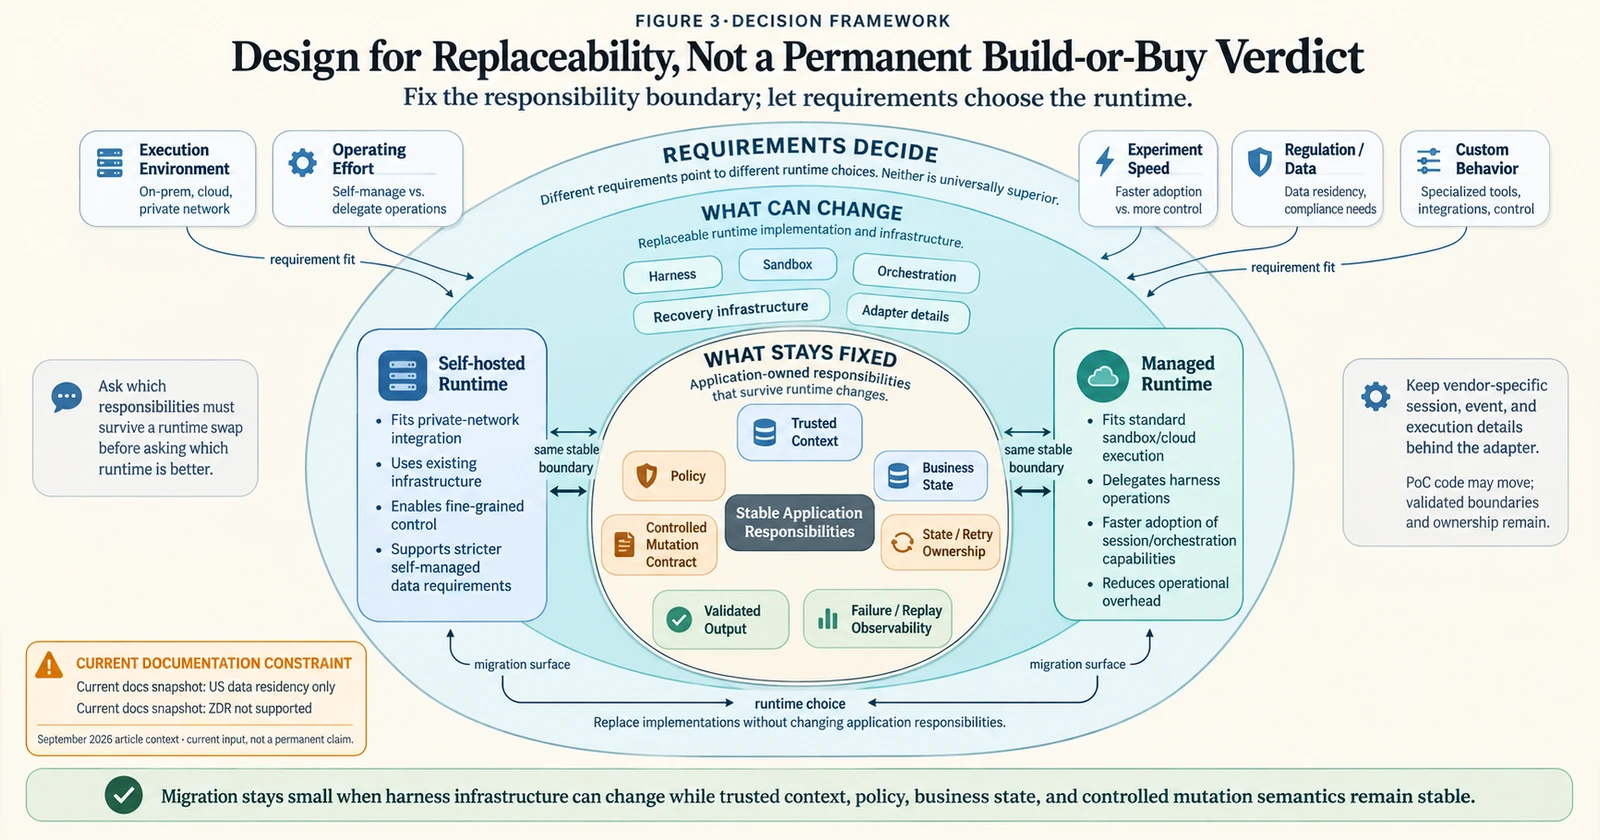
Build vs Buy보다 중요한 것은 Replaceability다
Self-hosted와 Managed 중 무엇이 더 좋은지를 하나의 표로 결정하려고 하면 쉽게 잘못된 결론에 도달한다.
Self-hosted runtime은 빠른 PoC나 세밀한 실행 제어, 기존 인프라와의 밀접한 통합에서 여전히 유용할 수 있다. 반대로 managed harness는 session과 orchestration, recovery 같은 범용 Agent infrastructure를 직접 운영하는 부담을 크게 줄일 수 있다.
둘은 반드시 경쟁 관계일 필요가 없다.
오히려 좋은 구조라면 요구사항에 따라 implementation을 바꿀 수 있어야 한다.
| 질문 | Self-hosted가 유리할 수 있는 경우 | Managed가 유리할 수 있는 경우 |
|---|---|---|
| 실행 환경 | 사설망·기존 시스템에 매우 밀접함 | 표준 sandbox와 cloud execution으로 충분함 |
| 운영 공수 | 직접 제어할 이유가 큼 | harness 운영을 서비스에 위임하고 싶음 |
| 실험 속도 | 내부 runtime을 이미 갖고 있음 | session/orchestration을 새로 만들고 싶지 않음 |
| 규제·데이터 | 자체 통제가 핵심 요구사항 | provider의 현재 data control이 요구사항을 충족함 |
| 변경 대응 | custom behavior가 중요함 | managed capability를 빠르게 흡수하고 싶음 |
여기서 마지막 조건은 특히 중요하다.
2026년 9월 현재 OpenAI 문서상 Agents API는 미국 데이터 레지던시만 지원하고 ZDR은 지원하지 않는다. self-hosted sandbox를 선택한다고 해서 Agents API 자체가 ZDR이 되는 것도 아니다.
이런 조건은 시간이 지나면서 바뀔 수 있다. 하지만 바로 그렇기 때문에 특정 runtime의 현재 capability를 architecture의 영구 전제로 삼는 것은 위험하다.
오늘은 compliance 때문에 self-hosted가 필요할 수 있고, 내일은 managed option이 요구사항을 만족할 수도 있다. 반대로 특정 workload만 다시 내부 환경으로 가져와야 할 수도 있다.
교체 가능한 경계가 있으면 이것은 migration 문제다. 경계가 없으면 재개발 문제가 된다.
PoC에서 Production으로 가져가야 할 것은 코드가 아니라 경계다
이 결론은 이전에 n8n을 사용해 Agent PoC를 만든 경험과도 이어진다.
나는 Enterprise AX를 n8n으로 모두 만들자는 이야기를 하고 있는 것이 아니다.
n8n은 빠른 PoC에서 workflow를 눈에 보이게 만들고, Python과 JavaScript로 state, validation, branching, retry 같은 책임을 실제로 검증하기 좋은 도구였다. Production에서는 같은 책임이 Step Functions, Lambda, Kubernetes workload, Application Backend 등으로 옮겨갈 수 있다.
Agent Runtime도 마찬가지다.
PoC에서 사용한 self-hosted Codex CLI가 Production에서도 반드시 남아야 하는 것은 아니다. Agents API가 더 적절하다면 바꾸면 된다.
대신 PoC에서 검증한 다음 경계는 남겨야 한다.
- 누가 authoritative context를 제공하는가
- Agent가 판단할 수 있는 범위는 어디까지인가
- 어떤 tool을 사용할 수 있는가
- 실제 mutation authority는 누구에게 있는가
- state와 retry의 ownership은 어디인가
- output을 어떤 contract로 검증하는가
- failure와 replay를 어떻게 관찰하는가
이것들이 명확하다면 runtime implementation은 생각보다 쉽게 바꿀 수 있다.
반대로 self-hosted runtime 안에 authentication, business policy, record state, tool execution, retry, persistence를 모두 섞어 놓았다면 managed API가 좋아져도 쉽게 옮길 수 없다.
Agent가 발전할수록 경계가 더 중요해진다
Agents API를 보면서 내가 만든 runtime이 무의미해졌다는 생각은 들지 않았다.
오히려 반대였다.
직접 만들어 보니 어떤 복잡성은 기꺼이 managed service에 넘겨야 하고, 어떤 책임은 넘기면 안 되는지가 더 잘 보였다.
Agent 기술은 앞으로도 빠르게 바뀔 것이다. 더 좋은 model이 나오고, 더 강력한 harness가 나오고, tool과 sandbox와 multi-agent 기능도 계속 발전할 것이다.
그때마다 architecture를 다시 만들 수는 없다.
그래서 지금 내가 더 중요하게 보는 것은 특정 Agent Runtime을 얼마나 잘 구축했느냐가 아니다.
Agent Runtime을 잘 만드는 것보다, 필요할 때 Agent Runtime을 바꿀 수 있게 만드는 것이 더 오래가는 Architecture일 수 있다.
Managed Agent가 좋아질수록 Application이 사라지는 것이 아니다.
오히려 무엇을 Agent에게 맡길지, 무엇을 Application이 끝까지 소유할지 더 정확히 정의해야 한다.
그리고 그 경계가 명확할수록 새로운 Agent 기술은 위협이 아니라, 정말 필요할 때 갈아 끼울 수 있는 또 하나의 구현 옵션이 된다.