
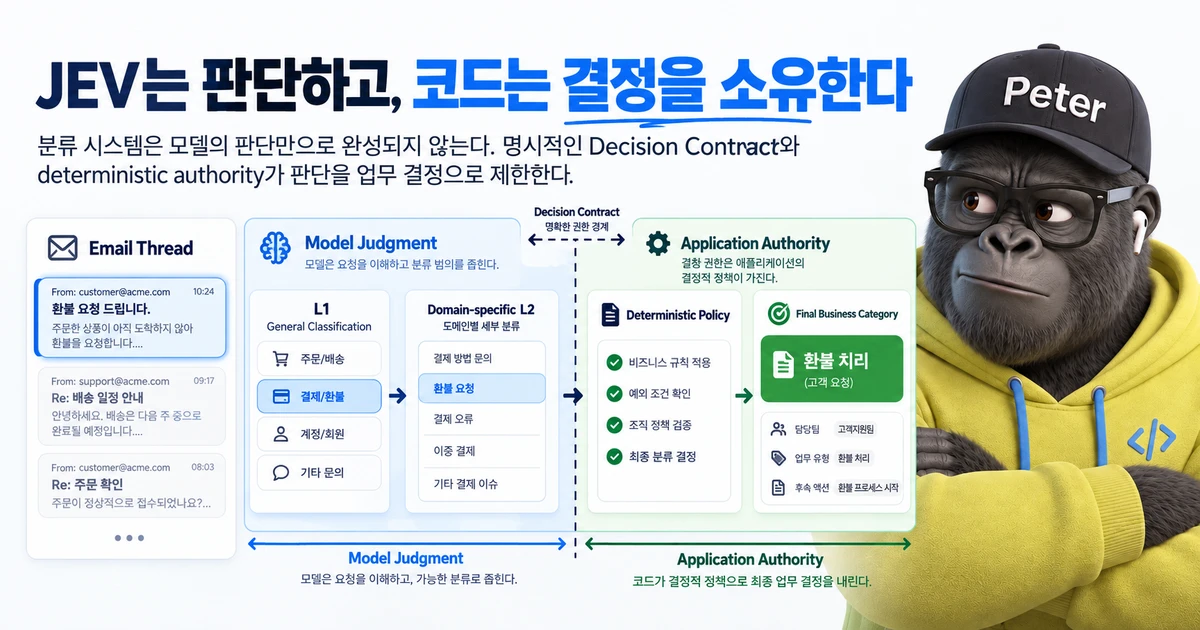
JEV를 처음 봤을 때 가장 먼저 떠오른 것은 예전에 다뤘던 Salesforce Email-to-Case였다. 고객이 보내온 이메일을 읽고 적절한 Level 1과 Level 2 Category로 분류하는 문제다. 생성형 답변이 필요한 것도 아니고, 정해진 업무 taxonomy 안에서 하나의 판단을 내려야 한다. 그래서 처음에는 꽤 단순하게 생각했다.
“이런 문제라면 일반 LLM보다 분류에 특화된 모델이 더 잘 맞지 않을까?”
n8n에 Google Sheets 샘플을 읽는 노드를 붙이고 JEV API를 호출하는 데까지는 오래 걸리지 않았다. 오히려 시간이 걸린 곳은 그다음이었다. 분류 결과가 마음에 들지 않을 때마다 모델 설정을 만진 것이 아니라, 내가 쓴 질문과 업무 경계를 다시 읽게 됐다.
어느 순간 문제 자체가 바뀌어 보였다.
“이 이메일은 무엇에 관한 것인가?”가 아니었다.
“지금 이 사람이 우리에게 무엇을 해달라고 요구하고 있는가?”
이 차이가 이번 PoC에서 가장 큰 수확이었다.
분류기를 붙이려 했는데, Taxonomy부터 다시 쓰게 됐다
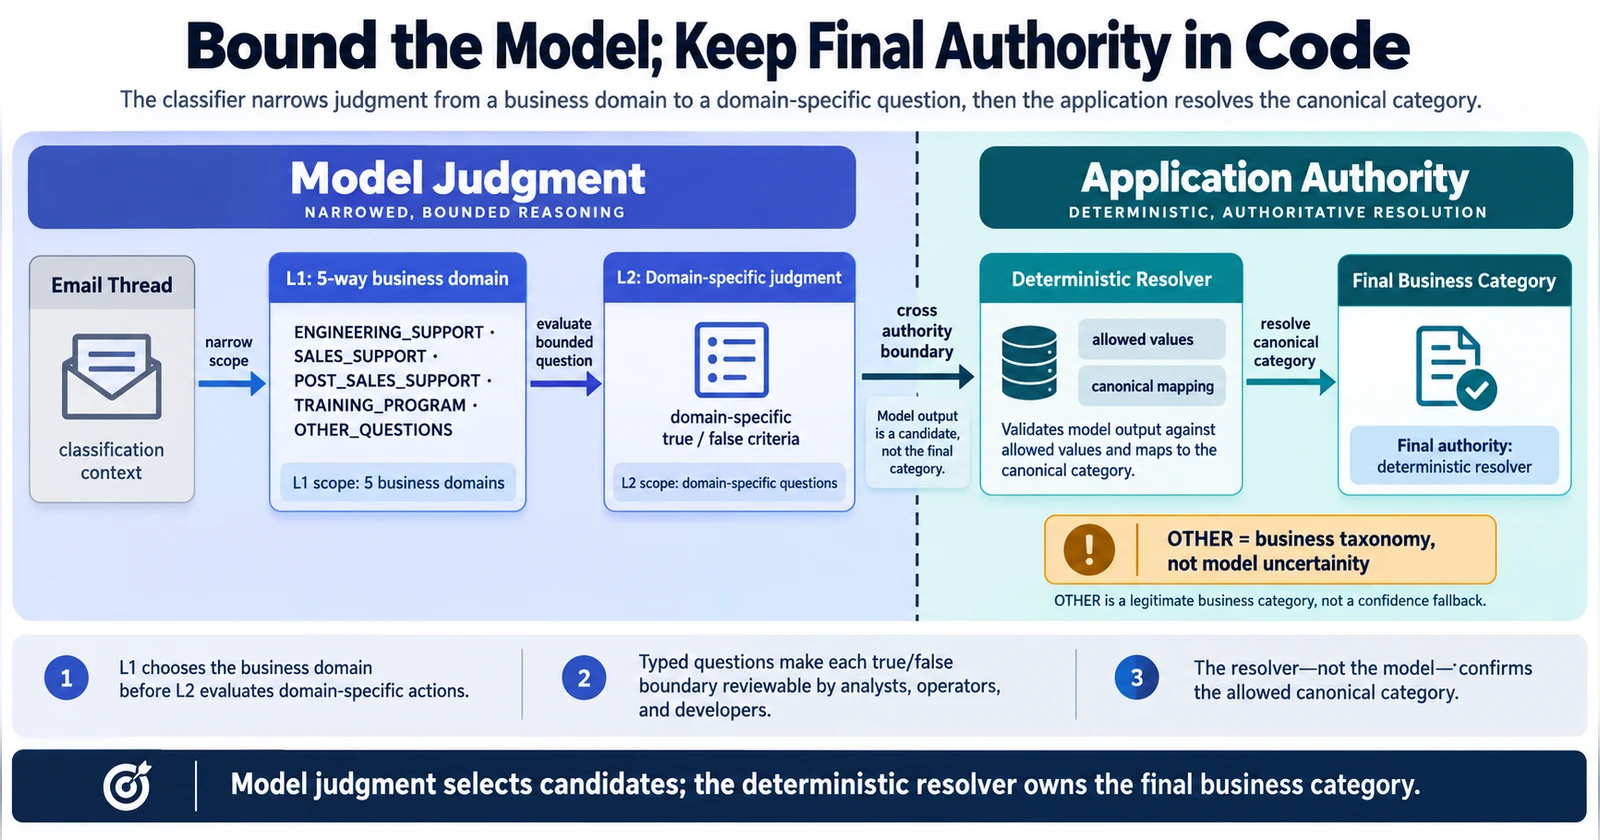
처음 L1은 다섯 개 업무 domain으로 좁혔다.
ENGINEERING_SUPPORTSALES_SUPPORTPOST_SALES_SUPPORTTRAINING_PROGRAMOTHER_QUESTIONS
여기까지만 보면 평범한 hierarchical classification처럼 보인다. 실제로 어려웠던 것은 다섯 개 이름을 정하는 일이 아니라, 어떤 경우에 그 이름을 선택해야 하고 어떤 경우에는 선택하면 안 되는지를 적는 일이었다.
실제 L1 request에는 이런 decision rule이 들어갔다.
decision_rule:
  'Classify the action that the sender currently expects the recipient to perform, not merely products, symptoms, technical words, historical events, or possible solutions mentioned in the email.'
이 한 문장을 얻는 데 생각보다 많은 시행착오가 있었다.
현업 이메일은 교과서처럼 한 가지 의도만 적혀 있지 않는다. 제품명도 나오고, 고장 증상도 나오고, 예전에 교체한 부품도 나오고, 고객이 생각하는 원인도 나온다. 문장에 seal이라는 단어가 있다고 Spare Parts가 되는 것도 아니고, replacement가 등장했다고 Repair가 되는 것도 아니다.
그래서 category마다 definition만 두지 않고 include와 exclude를 함께 적었다. 특히 OTHER_QUESTIONS에는 “애매하니까 OTHER”로 보내지 못하게 명시했다. OTHER는 모델의 불확실성 쓰레기통이 아니라 실제 업무 taxonomy이기 때문이다.
이때부터 내가 만들고 있는 것이 단순한 classifier prompt가 아니라 작은 Decision Contract라는 느낌이 들기 시작했다.
Enterprise 이메일에서는 Noun보다 Verb가 중요했다
분류를 여러 번 돌리면서 가장 자주 부딪힌 경계는 Post Sales였다.
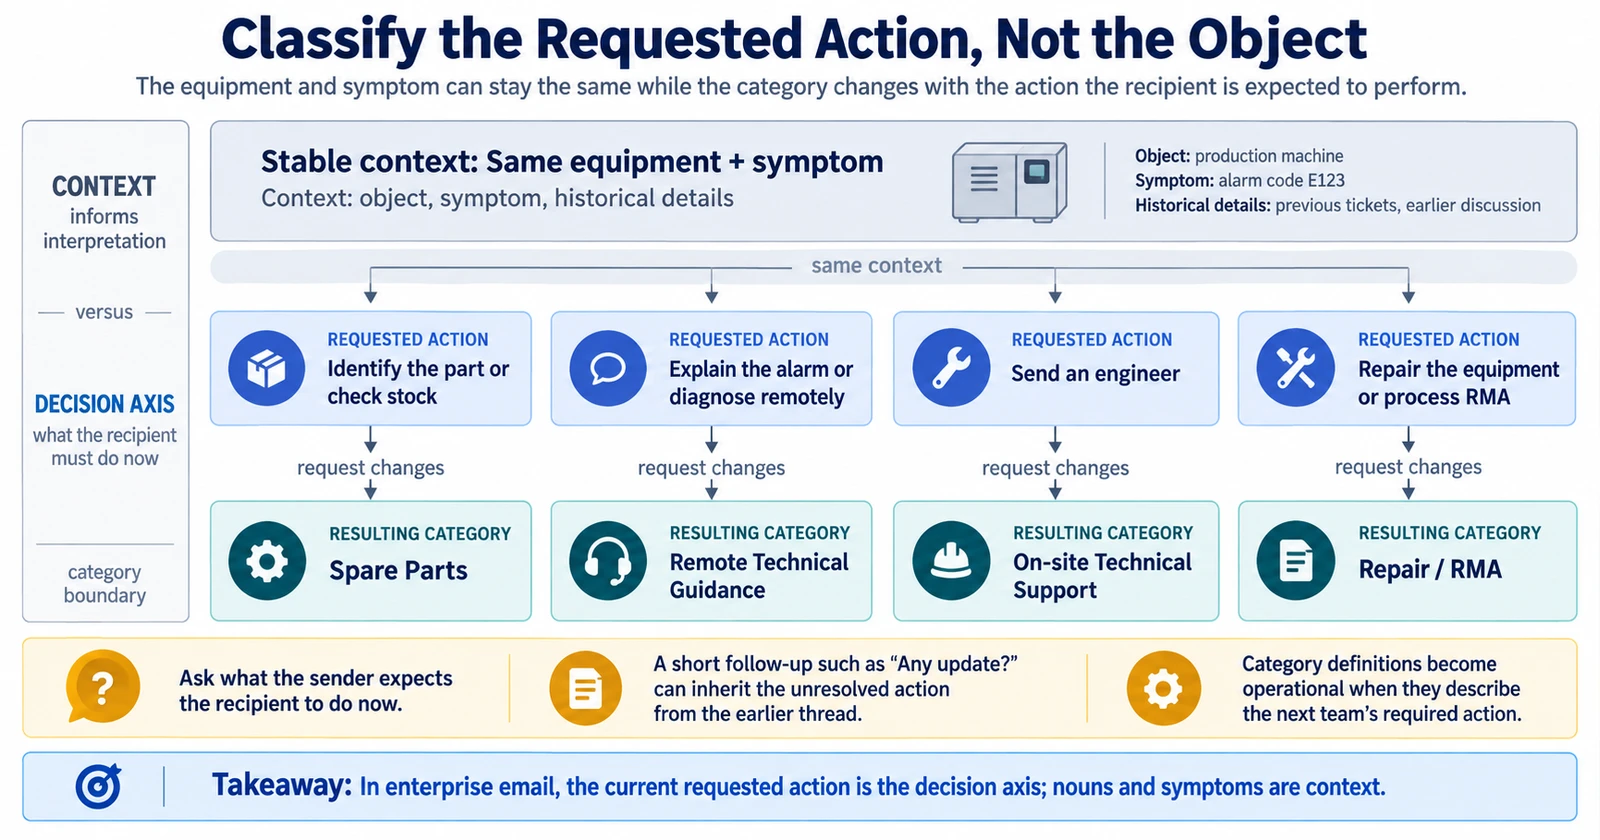
같은 고장 난 장비를 두고도 고객이 원하는 행동은 전혀 다를 수 있다.
“이 부품 번호가 무엇이고 재고가 있습니까?”라면 Spare Parts에 가깝다.
“이 alarm의 원인이 무엇인지 봐주세요”라면 Remote Technical Guidance다.
“엔지니어를 현장에 보내주세요”라면 On-site Technical Support다.
“이 장비를 수리하거나 RMA 처리해주세요”라면 Repair Request다.
장비도 같고 증상도 같을 수 있다. 달라지는 것은 현재 고객이 기대하는 action이다.
이 관점은 이메일 thread를 다룰 때 더 중요했다. 최신 메일이 “Any update?” 한 줄일 수도 있다. 이 한 줄만 보면 분류할 수 없지만, 이전 thread에 아직 해결되지 않은 엔지니어 방문 요청이 있다면 현재 action은 여전히 On-site Support다.
그래서 workflow에는 다음 원칙을 넣었다.
- newest sender-authored message를 우선한다.
- 최신 메시지가 follow-up, reminder, scheduling, escalation이면 이전 unresolved request를 복원한다.
- 이미 끝난 과거 action은 현재 요청을 덮지 않는다.
- 최신 문장이 짧아도 이전 thread의 unresolved request를 명확히 가리키면 구체 category를 선택할 수 있다.
실제 엔터프라이즈 프로젝트에서 taxonomy를 인터뷰할 때도 비슷하다. “이 Category는 무슨 뜻입니까?”라고 물으면 대개 추상적인 설명이 돌아온다.
대신 나는 점점 이런 질문을 더 중요하게 보게 됐다.
“이 Category로 들어오면 다음 담당자는 실제로 무엇을 해야 합니까?”
업무를 AI가 판단할 수 있는 형태로 바꾸려면 명사 정의보다 행동 경계가 먼저다.
20개 가까운 Category를 한 번에 고르게 하지 않았다
최종 category를 flat하게 한 번에 선택하게 하는 대신 두 단계로 나눴다.
Email Thread
  ↓
L1 — 5-way business domain
  ↓
Domain-specific L2
  ↓
Deterministic Resolver
  ↓
Final Classification
L1이 POST_SALES_SUPPORT로 좁혀지면 L2에서는 Spare Parts, Remote Technical Guidance, On-site Technical Support, Commissioning, Repair/RMA, Maintenance 계열처럼 그 domain 안에서만 의미가 있는 질문을 평가한다.
여기서 JEV의 noul을 category마다 독립적인 작은 질문으로 만들었다.
function q(task, trueCriteria, falseCriteria, extra) {
  const instructions = { task: task };

  return {
    type: 'noul',
    instructions: instructions,
    criteria: {
      true: trueCriteria,
      false: falseCriteria
    }
  };
}
이 방식은 꽤 마음에 들었다.
큰 prompt 하나 안에 taxonomy 전체를 집어넣고 “잘 판단해줘”라고 하는 것보다, 각 업무 판단의 true와 false가 무엇인지 독립적으로 읽을 수 있었다. Spare Parts와 Repair의 경계를 고치고 싶으면 그 두 질문을 보면 됐다. On-site와 Remote의 경계가 애매하면 해당 criteria를 다시 보면 됐다.
그리고 이건 모델만을 위한 문서가 아니었다.
Business Analyst가 읽어도 되고, 운영 담당자가 읽어도 되고, 개발자가 code review를 해도 된다. 암묵적으로 알고 있던 업무 기준이 조금씩 검토 가능한 application asset으로 바뀐다.
다만 hierarchy는 공짜가 아니다.
L1이 틀리면 정답 L2는 candidate set에서 아예 사라진다. ENGINEERING_SUPPORT로 잘못 들어간 이메일은 아무리 L2를 잘 돌려도 POST_SALES_SUPPORT__REPAIR_REQUEST에 도달할 수 없다.
그래서 hierarchical classifier의 다음 개선은 단순히 L2 질문을 더 정교하게 만드는 것이 아니다. L1 low-margin, cross-domain confusion pair, known boundary case를 별도로 다룰 수 있어야 한다.
JEV의 매력은 Answer보다 Question에 있었다
처음에는 JEV의 답이 얼마나 잘 맞는지에 관심이 있었다.
그런데 workflow가 v3까지 가면서 더 흥미로웠던 것은 질문을 작성하는 방식이었다.
일반적인 생성형 LLM 분류에서는 흔히 이런 prompt를 만든다.
“아래 이메일을 읽고 20개 Category 중 하나를 고르고 이유를 설명하라.”
물론 이 방식도 충분히 구현할 수 있다. 하지만 이번 실험에서는 문제를 더 작게 쪼갰다.
- 이것은 Spare Parts handling 자체가 현재 primary request인가?
- 이것은 remote technical support가 현재 primary request인가?
- 이것은 engineer site visit 자체가 현재 primary request인가?
- repair 또는 RMA가 명시적인 requested outcome인가?
그리고 각 질문마다 true와 false의 경계를 따로 적었다.
내 입장에서는 이것이 단순한 Prompt Engineering보다 Decision Specification Engineering에 가까웠다.
AI를 도입한다고 해서 기존 현업 taxonomy를 그대로 prompt에 붙여넣으면 되는 것이 아니다. 오히려 기존 taxonomy에 숨어 있던 모호함을 드러내고, “이 경우에는 맞고 저 경우에는 아니다”를 합의 가능한 언어로 다시 써야 한다.
엔터프라이즈 AX 프로젝트에서 모델 선택보다 이 작업이 더 오래 남는 자산일 수 있다.
모델은 바뀐다. API도 바뀐다.
하지만 우리 조직이 어떤 상황을 어떤 업무 요청으로 인정하는가라는 정책은 애플리케이션이 소유해야 한다.
모든 판단을 AI에 맡기지 않은 것이 오히려 중요했다
이번 workflow에서 내가 좋아하는 작은 부분이 하나 있다.
L1이 TRAINING_PROGRAM이면 더 이상 L2에서 고를 것이 없다. 그래서 JEV를 한 번 더 호출하지 않고 바로 deterministic path로 내렸다.
if (domain === 'TRAINING_PROGRAM') {
  return {
    json: {
      ...input,
      l2_execution: 'DIRECT',
      direct_l2_action: 'TRAINING_PROGRAM',
      direct_classification:
        'TRAINING_PROGRAM__TRAINING_PROGRAM'
    }
  };
}
아주 작은 최적화처럼 보이지만 나는 이 부분이 중요하다고 생각한다.
판단이 끝난 지점에서 AI를 계속 호출할 이유는 없다.
AI 프로젝트를 하다 보면 모델을 붙인 뒤 모든 판단을 다시 모델에게 묻고 싶어지는 유혹이 있다. 하지만 확정적인 rule이 생긴 순간에는 code로 내려오는 편이 낫다.
호출 한 번이 줄어들면 latency도 줄고 비용도 줄고 실패할 표면도 줄어든다. 더 중요한 것은 동작 이유가 명확해진다는 점이다.
최근 Peter’s Stack에서 계속 이야기했던 “Uncertainty는 AI가, Certainty는 Deterministic Workflow가”라는 원칙이 이번에는 실제 코드 한 조각으로 나타났다.
Score는 모델이 만들고, Authority는 Code에 남겼다
L1 response를 받은 뒤에도 그대로 다음 단계로 넘기지 않았다.
허용된 domain인지 확인하고, answer type이 choice인지 검사한다. 선택된 probability와 runner-up probability를 따로 남기고 margin을 계산한다.
L2도 마찬가지다.
각 noul의 score를 읽어서 candidate list를 만든 뒤 JavaScript가 deterministic하게 정렬한다.
candidates.sort(function(a, b) {
  if (b.score !== a.score) {
    return b.score - a.score;
  }
  return a.action.localeCompare(b.action);
});

const winner = candidates[0];
const runnerUp = candidates[1];
그리고 최종 category는 별도의 categoryMap을 통해 canonical business code로 확정한다.
여기서 내가 가져간 원칙은 간단하다.
Model은 score를 만든다. Application이 그 score를 업무의 결정으로 바꾼다.
JEV가 예상하지 못한 type을 반환하거나 허용하지 않은 domain을 반환하면 오류를 낸다. L2 execution route도 JEV나 DIRECT가 아니면 별도 fail-closed path로 보낸다.
이런 코드는 demo에서는 귀찮아 보인다.
하지만 Enterprise AX에서는 AI가 “대충 비슷한 값”을 반환했을 때 application이 알아서 의미를 추측하는 순간부터 운영 리스크가 생긴다.
모델의 유연성은 모델 안에 두고, 업무 시스템의 허용 범위는 코드가 소유하는 편이 낫다.
Margin을 기록한다고 운영 안전성이 생기는 것은 아니었다
이번 PoC는 생각보다 많은 signal을 남긴다.
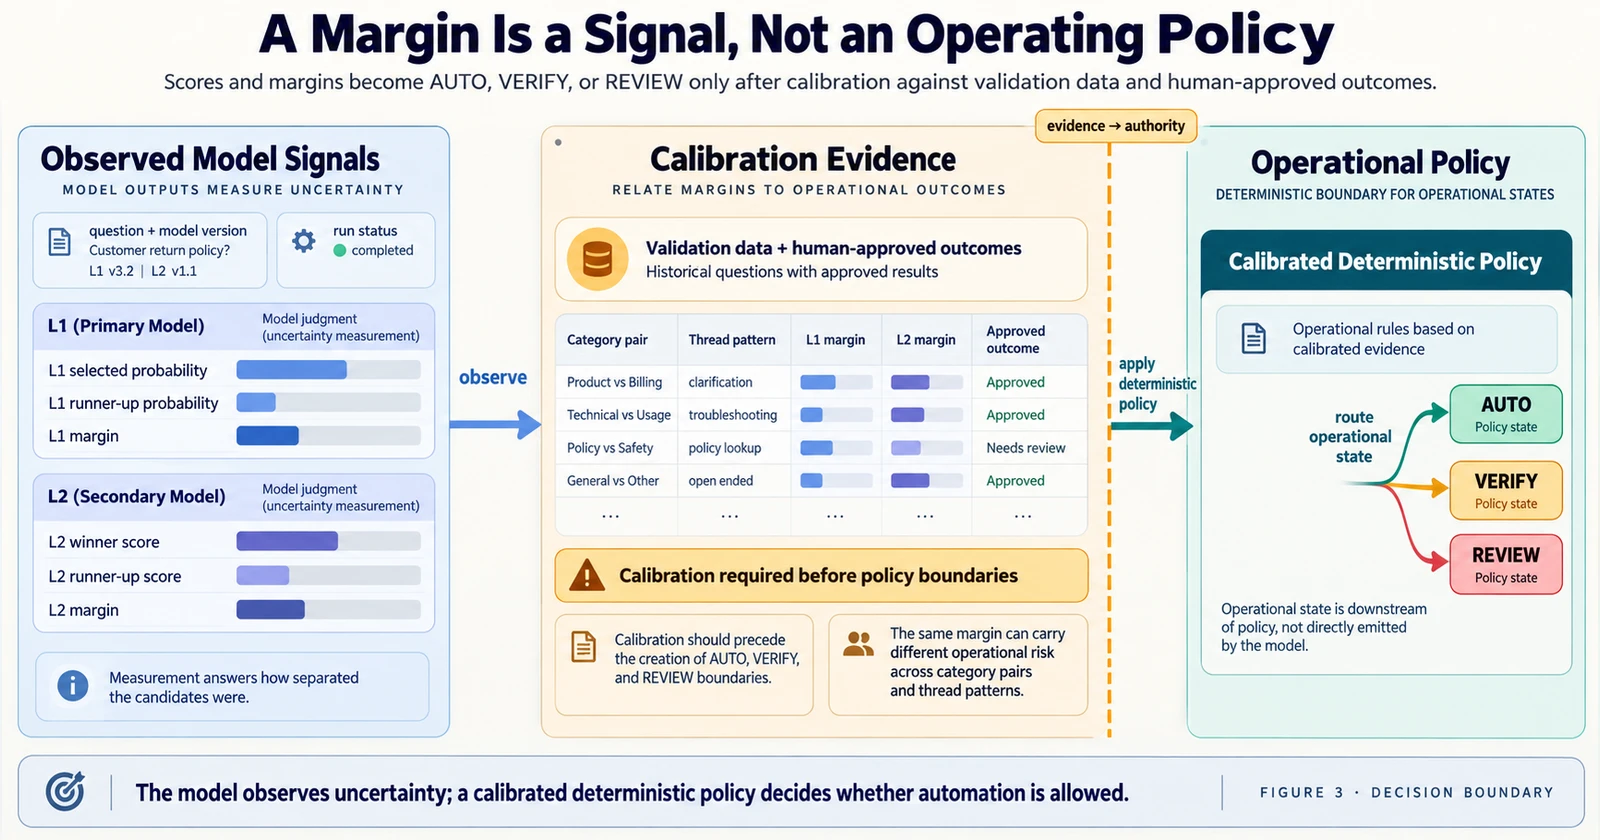
L1에서는 selected probability, runner-up probability, confidence, margin을 기록한다. L2에서도 winner score, runner-up score, margin을 남긴다. 여기에 question version, model version, token usage, run status까지 저장한다.
처음에는 이 정도면 uncertainty를 꽤 잘 보고 있다고 생각했다.
그런데 다시 보면 한 단계가 비어 있다.
측정은 하고 있지만 아직 그 측정을 운영 정책으로 사용하고 있지 않다.
현재 v3.0.1은 margin이 좁아도 winner를 final classification으로 확정한다.
uncertainty measurement
        ≠
uncertainty policy
Production으로 간다면 다음 단계는 threshold 숫자를 감으로 정하는 일이 아니다.
Human-approved 결과를 쌓고 실제로 확인해야 한다.
P(correct |
  L1 margin,
  L2 margin,
  category pair,
  thread pattern,
  human-approved outcome)
예를 들어 특정 cross-domain pair에서만 낮은 margin이 위험할 수도 있고, 어떤 category는 상대적으로 작은 margin에서도 안정적일 수 있다.
따라서 margin < 0.2이면 REVIEW 같은 숫자를 먼저 만드는 것이 아니라, 운영 데이터로 calibration한 뒤 AUTO / VERIFY / REVIEW 정책을 만드는 것이 순서다.
OTHER와 REVIEW는 같은 것이 아니다
이 구분은 실제 운영에서 꽤 중요하다.
OTHER
= 실제 business taxonomy

REVIEW
= 현재 model decision을 자동 처리하지 않는 operational state
모델이 애매해하는 건 모두 OTHER로 보내면 구현은 쉽다.
하지만 시간이 지나면 OTHER가 무엇인지 알 수 없게 된다.
진짜 일반 문의도 들어가고, taxonomy에 없는 요청도 들어가고, 단지 모델이 확신하지 못한 이메일도 들어간다. 결국 OTHER가 garbage bucket이 되고 나면 taxonomy를 개선할 데이터마저 오염된다.
반대로 REVIEW를 operational state로 별도 관리하면 질문이 달라진다.
“이 요청은 업무상 OTHER인가?”
와
“이 모델 결과를 자동으로 받아들여도 되는가?”
를 독립적으로 판단할 수 있다.
이 두 질문을 분리하는 것은 JEV를 쓰든 일반 LLM을 쓰든 그대로 유지해야 한다.
그럼 일반 LLM으로 만들면 안 되는가?
당연히 아니다.
이번 실험을 통해 내린 결론은 “JEV가 LLM보다 우월하다”가 아니다.
오히려 같은 taxonomy를 general LLM으로 구현한다면 JEV에서 명시적으로 드러난 경계를 잃지 않는 것이 중요하다고 본다.
나는 대략 이런 구조로 가져갈 것이다.
Email Thread
  ↓
Active Request Extraction
  ↓
Constrained L1 Classification
  ↓
Domain-specific L2
  ↓
Boundary Verifier when needed
  ↓
Deterministic Policy
  ↓
AUTO / REVIEW
LLM의 장점은 분명하다. 긴 문맥을 다루고, 예상하지 못한 표현을 해석하고, evidence를 설명하고, 새로운 edge case를 추론하는 데 훨씬 유연하다.
대신 confidence: 0.93 같은 값을 모델 스스로 생성하게 한 뒤 JEV의 probability와 같은 신호라고 생각하면 안 된다.
LLM에서는 차라리 다음과 같은 system-level signal을 보는 편이 낫다.
- structured output schema가 유효한가
- 선택을 뒷받침하는 direct evidence가 있는가
- alternative candidate가 무엇인가
- known boundary case인가
- classifier와 verifier가 합의하는가
- 과거 human-approved 결과에서 calibration이 되었는가
즉 모델만 바뀌고 Decision Harness는 남아야 한다.
내가 Enterprise AX에서 가져갈 패턴
이번 실험을 하면서 JEV를 어디에 쓰면 좋을지보다 더 분명해진 것은, AI classification을 어떻게 설계해야 하는가였다.
첫째, 현업 taxonomy를 그대로 prompt에 복사하지 않는다. 실제 action과 include/exclude boundary를 다시 정의한다.
둘째, 현재 요청과 과거 context를 분리한다. thread가 길수록 많이 언급된 내용보다 아직 해결되지 않은 요청이 중요하다.
셋째, category 이름보다 decision contract를 versioning한다. 이 workflow가 question_version: hierarchical-v3.0을 남기는 이유도 여기에 있다. 모델 버전만 기록해서는 어느 판단 기준으로 나온 결과인지 재현하기 어렵다.
넷째, score를 SLA로 착각하지 않는다. probability와 margin은 useful signal이지 business guarantee가 아니다.
다섯째, classifier가 바로 business state를 mutate하지 않게 한다. assignment, case update, customer notification 같은 side effect는 deterministic policy 뒤에 두는 편이 안전하다.
여섯째, human correction을 실패 기록으로만 버리지 않는다. 사람이 재분류한 결과가 충분히 쌓이면 category boundary, confusion pair, AUTO/REVIEW threshold를 다시 설계할 수 있다.
일곱째, 확정된 곳에서는 AI를 제거한다. AI를 많이 쓰는 architecture보다 어디서 AI가 필요 없어지는지 명확한 architecture가 운영하기 쉽다.
이 기준으로 보면 JEV가 특히 잘 맞는 문제도 선명하다.
- category set이 유한하고 비교적 안정적이다.
- 판단을 작은 constrained choice나 yes/no question으로 나눌 수 있다.
- 반복량이 많고 생성형 문장이 필요하지 않다.
- 업무 taxonomy와 decision boundary를 명시적으로 관리할 수 있다.
- 최종 side effect는 application이 소유한다.
반대로 taxonomy 자체가 매번 바뀌거나, 긴 multi-step reasoning과 external knowledge retrieval이 핵심이거나, 결과가 본질적으로 서술형이어야 한다면 general LLM이 더 자연스러울 수 있다.
결국 중요한 것은 모델 이름이 아니다.
문제의 모양에 맞는 decision engine을 고르고, 그 바깥의 authority contract를 유지하는 것이다.
결국 분류기도 하나의 Runtime Boundary 문제였다
처음에는 JEV라는 새 모델을 사용해보는 실험이었다.
끝나고 보니 내가 다시 확인한 것은 꽤 익숙한 원칙이었다.
Agent가 tool을 고를 수 있어도 실행 권한까지 가져야 하는 것은 아니듯, classifier가 category를 제안할 수 있어도 그 결과가 곧바로 업무 시스템의 결정이 될 필요는 없다.
JEV든 LLM이든 모델은 bounded judgment를 맡길 수 있다.
하지만 taxonomy, validation, retry, review policy, mutation authority는 application이 소유해야 한다.
그래서 이번 실험에서 가장 오래 남을 것은 JEV API 호출 코드가 아닐 것 같다.
업무 판단을 작은 contract로 쪼개고, 그 판단을 어디서부터 business decision으로 인정할지 설계했던 과정이다.
그리고 다음 실험은 자연스럽다.
동일한 canonical taxonomy와 validation set을 두고 JEV와 general LLM을 같은 Decision Harness 안에서 비교해보면 된다. 그때 비교할 것은 단순 accuracy 하나가 아니라 boundary case, margin 또는 verifier signal, human correction, latency, cost, 운영 복잡도까지 포함한 전체 decision system이어야 한다.
분류 시스템에서 중요한 것은 AI가 답을 내는가가 아니었다. 어떤 판단을 AI에게 맡기고, 그 판단을 어디서부터 업무의 결정으로 인정할지를 설계하는 일이었다.