
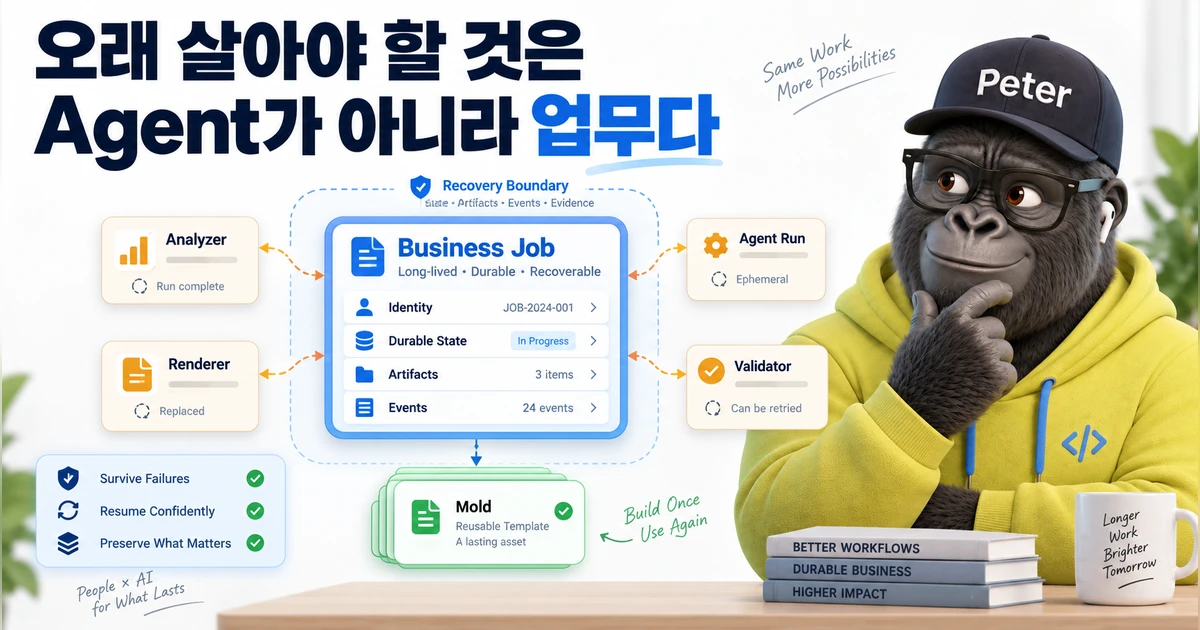
기업용 AI 서비스를 설계하다 보면 PoC에서는 잘 보이지 않던 문제가 갑자기 전면으로 나온다. Agent가 답을 못해서가 아니다. Agent가 일을 잘하더라도, 그 일이 오래 걸리고 중간에 실패할 수 있는 순간부터 “실행”과 “업무”를 같은 것으로 취급할 수 없게 된다.
최근 나는 기업 PowerPoint 템플릿을 재사용 가능한 구조로 만드는 작업을 Agent로 서비스하는 상황을 다시 생각하게 됐다. 처음에는 꽤 단순한 문제처럼 보였다. raw PPTX를 읽고 구조를 이해한 뒤, 이후 반복 생성에 쓸 수 있는 mold로 만들면 된다.
그런데 이 작업을 실제 서비스 경계 안으로 넣는 순간 질문이 달라졌다.
Agent가 10분 동안 살아 있느냐보다, 그 10분 동안 진행된 업무를 시스템이 잃어버리지 않느냐가 더 중요해졌다.
기업 PPT를 AI가 이해하게 해달라는 미션
기업에는 이미 오랫동안 사용해 온 PowerPoint 양식이 있다. 표지, 목차, 데이터 표현 방식, 표와 차트의 위치, 본문과 강조 영역의 관계처럼 반복되는 문서 구조도 있다.
Fetchdoc 사례에서는 관리자가 이런 raw PPTX를 최초 한 번 등록하고, 그것을 재사용 가능한 mold로 만드는 onboarding 단계를 거친다. 이후 일반 사용자는 매번 PPT 구조를 다시 분석시키는 것이 아니라, 이미 만들어진 mold에 최신 데이터를 적용해 문서를 생성한다.
비싼 작업을 앞단에서 한 번 수행하고, 반복 사용 구간은 빠르게 만든다.
따라서 이 글에서 다루는 “10분짜리 작업”은 일반 사용자가 문서를 한 번 만들 때마다 기다리는 시간이 아니다. 관리자가 새로운 기업 템플릿을 시스템에 등록할 때 수행하는 최초 mold 생성 작업이다.
10분이 걸리는 것은 문서 생성이 아니라 최초 Mold 생성이었다
이 구분을 먼저 하지 않으면 사례 자체를 잘못 이해하기 쉽다.
관리자 경로: raw PPTX → 구조 분석 → 의미 해석 → reusable mold 생성 → 검증 → ready
이 과정은 약 10분 수준의 시간이 걸릴 수 있고, 상대적으로 많은 compute와 resource를 사용한다. 하지만 한 번 mold가 완성되면 일반 사용자 경로는 다르다.
일반 사용자 경로: 새 데이터 수집 → 기존 mold 적용 → 문서 생성
반복 생성은 이미 준비된 mold를 재사용하므로 훨씬 빠르다. 내가 이번에 관심을 가진 것은 후자가 아니라 전자였다.
기업 서비스에서 “관리자가 가끔 수행하는 무거운 작업”은 흔하다. 데이터 import, 대량 문서 분석, knowledge indexing, report template onboarding, batch evaluation처럼 일반 사용자의 realtime request와는 다른 시간축을 가진다.
오래 걸리는 Agent 작업을 어떻게 서비스의 일부로 만들 것인가?
Agent는 일을 해냈다. 그런데 서비스가 되자 문제가 달라졌다
PoC에서는 단순하게 생각할 수 있다. 관리자가 PPTX를 올린다. Agent가 분석한다. mold를 만든다. 검증한다. 결과를 돌려준다.
한 번 실행해서 성공하면 꽤 만족스럽다. 하지만 서비스를 운영하는 입장에서는 성공한 데모보다 실패한 일곱 번째 실행이 더 중요하다.
- PPTX 분석은 끝났다.
- 구조를 표현하는 intermediate artifact도 만들어졌다.
- mold 생성이 거의 끝났다.
- 마지막 validation 단계에서 worker가 실패했다.
이때 “다시 실행” 버튼을 누르면 어디서부터 시작해야 할까? raw PPTX 분석부터 다시 해야 할까? 이미 만든 artifact는 믿어도 될까? 사용자가 브라우저를 닫았다가 다시 들어오면 이 작업을 찾을 수 있을까? worker process가 재시작되면 시스템은 어디까지 진행됐는지 알 수 있을까?
AI capability를 어떻게 호출할 것인가가 아니라, 업무의 생명주기를 누가 소유할 것인가의 문제가 된다.
Agent를 10분 동안 붙잡고 있으면 되는 줄 알았다
가장 직관적인 구현은 하나의 긴 request 안에서 모든 것을 끝내는 것이다. 클라이언트가 요청을 보내고, application이 Agent를 호출하고, Agent가 여러 작업을 끝낸 뒤 마지막 결과를 반환한다.
짧은 inference라면 이 구조가 단순하고 좋다. 하지만 실행 시간이 길어질수록 업무의 생명주기가 HTTP connection, application process, 외부 provider, worker 같은 임시 요소에 묶인다.
오래 걸리는 Agent를 안정적으로 서비스하려 했는데, 실제로 오래 붙잡고 있던 것은 Agent가 아니라 하나의 실행 세션이었다.
세션이 사라지면 업무까지 사라지는 구조라면, 그 업무는 아직 durable하지 않다.
질문을 바꿨다: Agent Run과 Business Job은 같은 것이 아니었다
그래서 질문을 바꿨다. “Agent를 어떻게 10분 동안 안정적으로 살려둘까?”가 아니라, “10분 동안 진행되는 업무를 어떻게 잃어버리지 않을까?”
이 질문으로 바꾸면 Agent Run과 Business Job이 분리된다.
Agent Run은 한 번의 execution attempt다. 실패할 수 있고, 다시 시작할 수 있고, 다른 worker나 다른 runtime으로 교체될 수도 있다.
반면 Business Job은 관리자가 시스템에 맡긴 업무다. 이 raw PPTX를 분석해서 reusable mold로 만들어라. 이 업무에는 identity가 있어야 한다. 어디까지 진행됐는지 알아야 하고, 이미 생성한 artifact를 찾을 수 있어야 하며, 무엇을 다시 실행해도 되는지 판단할 수 있어야 한다.
결국 중심이 Agent에서 Job으로 이동한다.
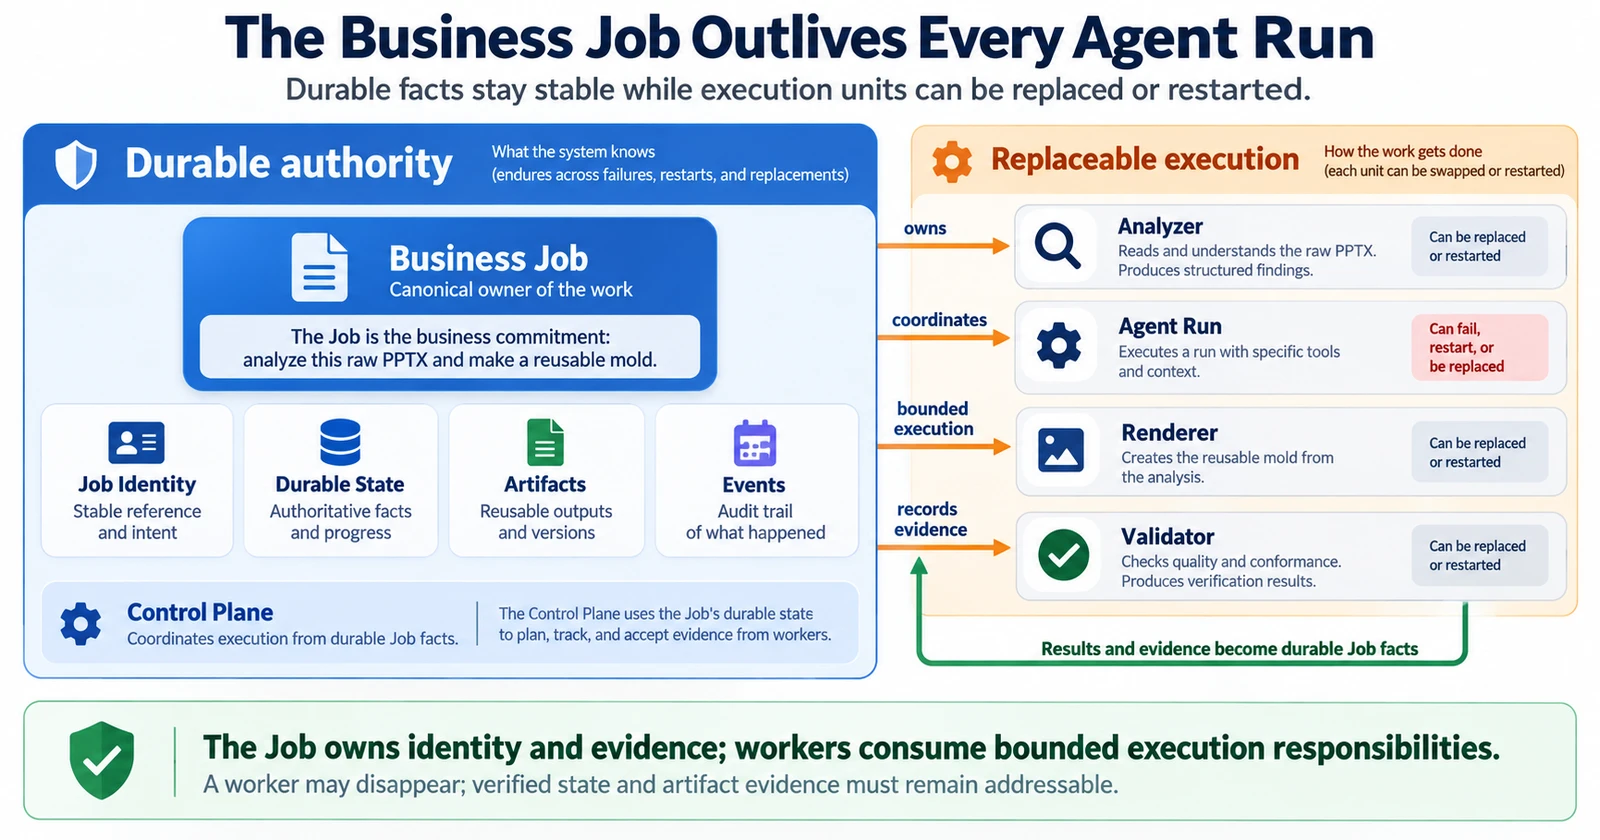
이 구조에서는 Analyzer, Agent, Renderer, Validator가 모두 실행 주체일 뿐이다. 이들이 바뀌거나 재시작되어도 Job은 남는다.
좋은 long-running Agent architecture는 Agent process 자체를 영속화하는 구조라기보다, Agent가 사라져도 업무를 복구할 수 있는 구조에 가깝다.
State는 Agent가 무엇을 생각하는지가 아니라 확보된 업무 사실이었다
Job을 중심에 놓으면 State의 의미도 달라진다.
RECEIVED → ANALYZING → STRUCTURE_READY → MOLD_BUILDING → VALIDATING → READY
여기서 State는 “Agent가 지금 어느 프롬프트를 처리 중인가”를 기록하는 것이 아니다. 업무적으로 어떤 durable fact가 이미 확보됐는가를 표현한다.
STRUCTURE_READY라면 raw PPTX에서 추출한 구조 정보가 이미 생성되고 검증됐다는 뜻이어야 한다. MOLD_BUILDING까지 갔다면 그 이전 작업을 반복하지 않고 이어갈 수 있어야 한다.
장시간 AI 작업에서는 가장 비싼 단계가 매번 마지막 단계인 것도 아니고, 모든 단계를 다시 수행해야 하는 것도 아니다. 이전에 검증된 artifact를 재사용할 수 있다면 실패는 “처음부터 다시”가 아니라 “현재 책임 단위만 다시”로 바뀐다.
Retry, Resume, Replay는 서로 다른 문제였다
처음에는 실패하면 전부 Retry라고 불렀다. 그런데 실제 운영에서는 세 가지가 달랐다.
- Retry — 실패한 동일 operation을 다시 시도한다.
- Resume — 이미 성공한 durable checkpoint를 보존하고 그 이후부터 계속한다.
- Replay — 저장된 current state, event, artifact evidence를 다시 읽고 지금 시점에서 다음으로 허용되는 action을 다시 결정한다.
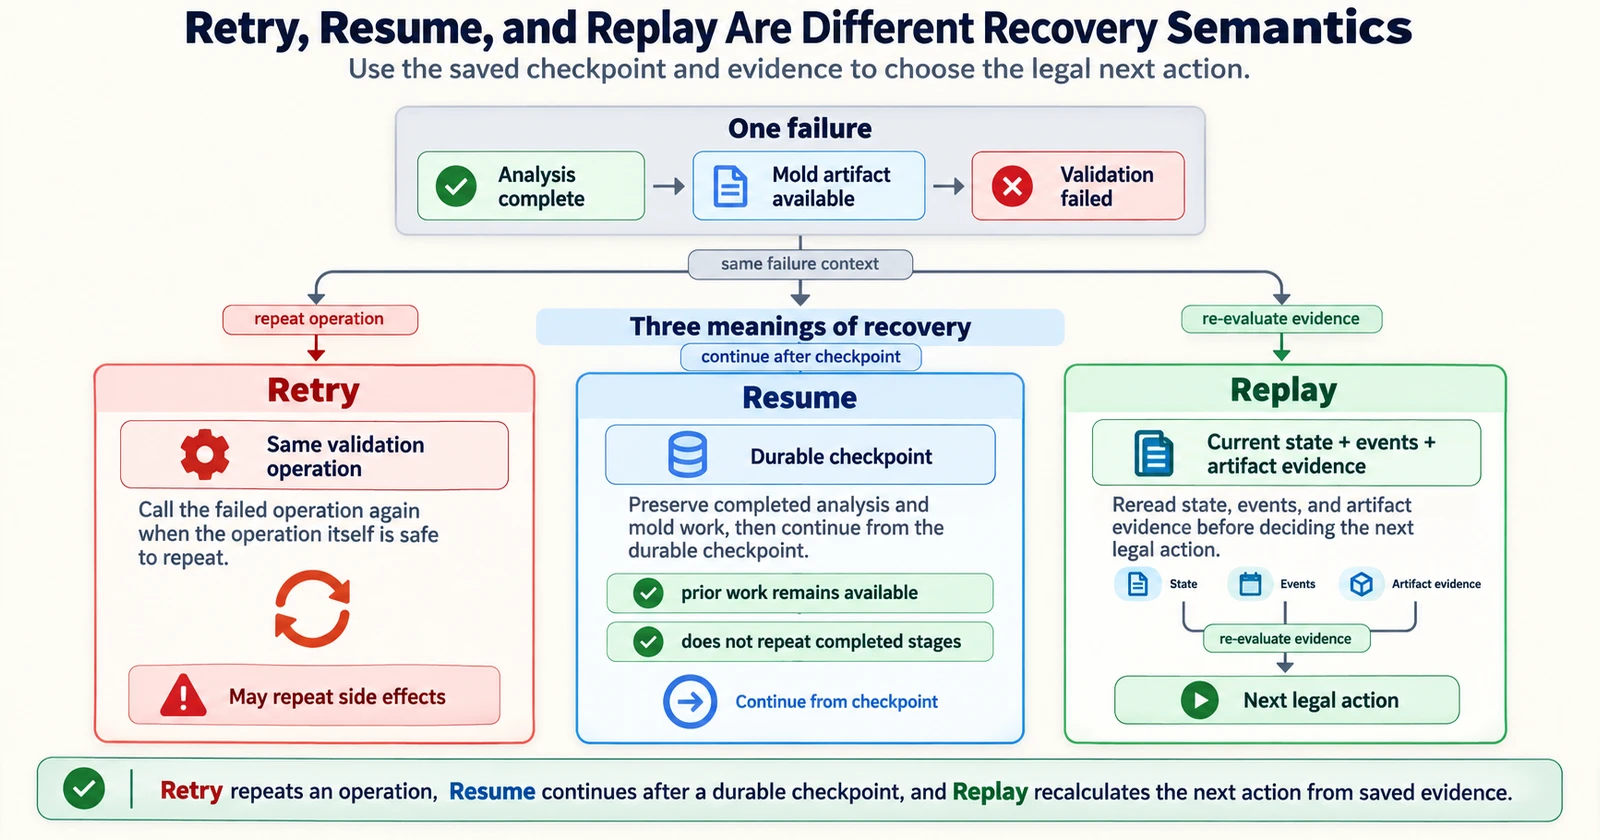
이 셋을 구분하면 recovery 설계가 훨씬 명확해진다. 무엇을 다시 호출해도 되는가? 무엇은 이미 완료됐는가? 어떤 state transition은 다시 평가해야 하는가?
이 질문을 Agent에게 매번 자연어로 판단시키기보다 deterministic application contract로 두는 편이 훨씬 안전하다.
WAITING은 실패가 아니다
Long-running 업무에서는 실행 중이지 않은 시간도 존재한다. 외부 provider가 결과를 준비하고 있을 수 있고, 특정 worker의 결과를 기다릴 수 있으며, resource가 확보될 때까지 pause해야 할 수도 있다.
이때 synchronous request 관점에서는 응답이 없다는 사실이 실패처럼 보이기 쉽다. 하지만 durable Job 관점에서는 WAITING이 정상 lifecycle일 수 있다.
RUNNING → WAITING → WAKE → RUNNING
중요한 것은 기다리는 동안 process를 억지로 붙잡는 것이 아니다. 무엇을 기다리고 있는지, 어떤 조건에서 다시 깨어날지, 깨어났을 때 어느 state에서 이어갈지를 durable하게 남기는 것이다.
“지금 CPU를 쓰고 있지 않다”와 “업무가 실패했다”는 전혀 다른 상태다.
가장 위험한 실패는 이미 성공했는데 실패처럼 보이는 경우다
실패보다 더 까다로운 상황도 있다. 예를 들어 mold artifact 저장은 성공했다. 그런데 성공 응답을 돌려주기 직전에 network timeout이 발생했다.
서버 입장에서는 성공이다. 호출자 입장에서는 실패다. 이 상태에서 단순히 Retry하면 같은 artifact를 다시 만들거나 downstream side effect를 중복 수행할 수 있다.
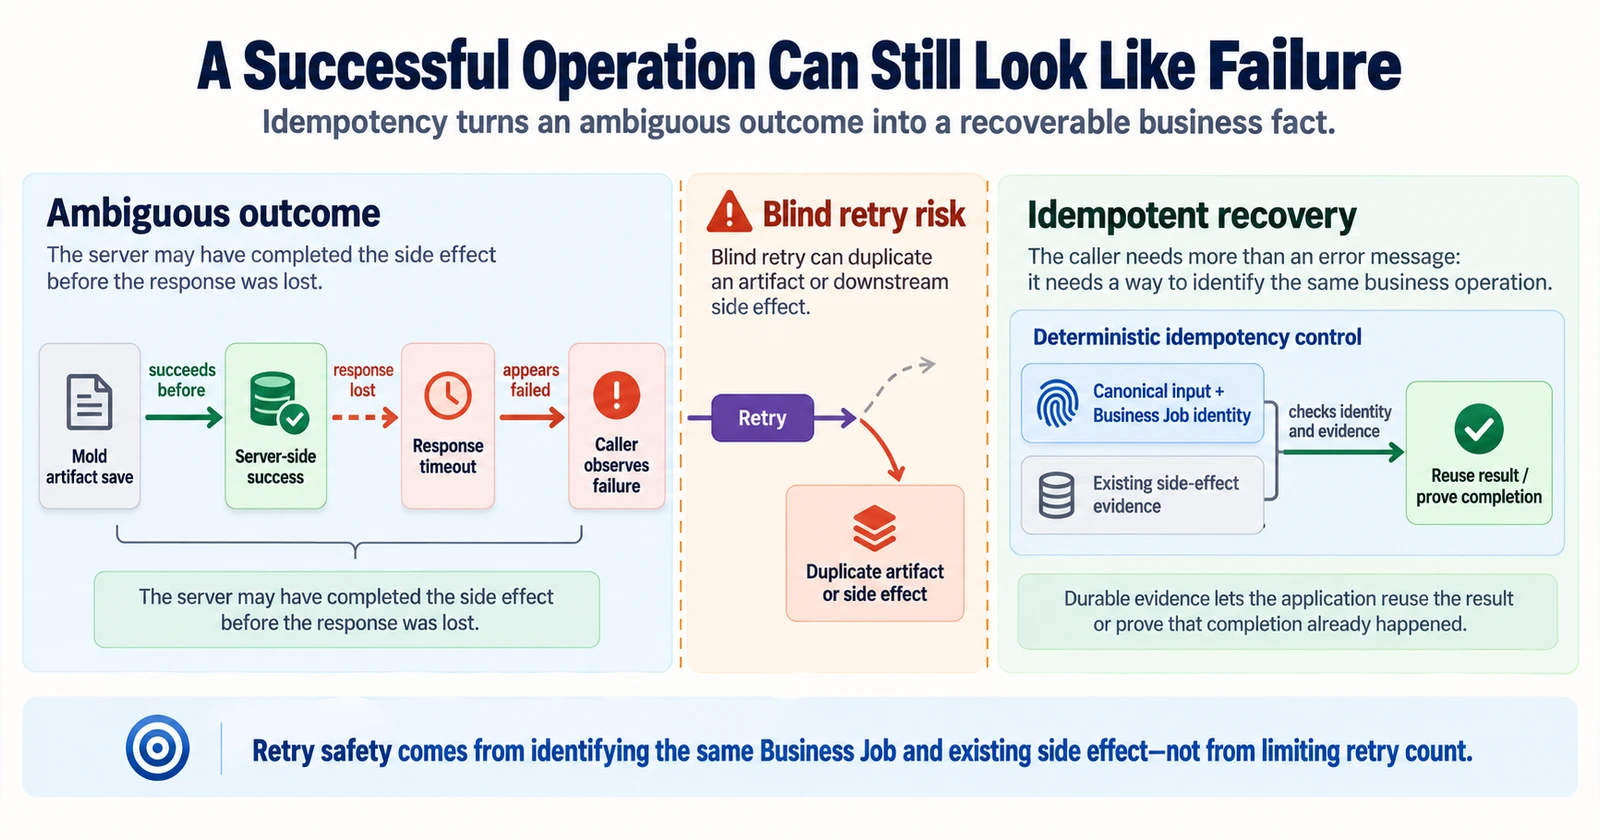
그래서 idempotency가 중요해진다. 같은 canonical input과 같은 업무 identity로 들어온 요청이라면, 이미 성공한 결과를 찾아 재사용하거나 동일 side effect가 수행됐음을 증명할 수 있어야 한다.
Retry safety는 “몇 번 다시 해볼까?”의 문제가 아니라 “다시 실행된 요청이 같은 업무라는 것을 어떻게 증명할까?”의 문제다.
이 지점부터 Agent Runtime은 LLM 호출 래퍼가 아니라 application architecture의 일부가 된다.
PoC 스택은 정답이 아니라 구조를 검증하는 장치였다
이 문제를 설명할 때 특정 도구를 Enterprise 정답처럼 이야기하고 싶지는 않다.
내 PoC에서는 orchestration, application API, durable database, Agent worker를 빠르게 조합해볼 수 있다. n8n, FastAPI, PostgreSQL 같은 도구는 이런 구조를 눈에 보이게 검증하기 좋다.
- Admission과 orchestration은 작업을 시작하고 이어갈 조건을 다룬다.
- Application boundary는 legal state transition과 business policy를 소유한다.
- Durable store는 Job, state, event, artifact evidence를 보존한다.
- Agent와 다른 worker는 bounded execution을 수행한다.
Enterprise 환경에서는 Step Functions, Temporal, Durable Functions, messaging infrastructure, domain service, RDB나 event store 등 전혀 다른 기술 조합으로도 같은 구조를 구현할 수 있다.
그래서 나는 n8n을 “Enterprise AX를 n8n으로 만든다”는 의미로 사용하지 않는다. 빠른 PoC에서 실행 가능한 architecture sketch를 만들고, 그 안에서 확인한 contract와 책임 경계를 실제 target architecture로 옮겨갈 수 있게 만드는 것이 더 중요하다.
PPTX를 만들다가 Long-running Enterprise AI 문제를 만났다
Fetchdoc의 mold onboarding은 이해하기 쉬운 사례지만, 이 문제는 PPTX에만 존재하지 않는다.
대용량 문서 research, 계약서 분석, batch classification, 복잡한 report generation, code generation과 validation, multi-system reconciliation, 비동기 media generation에도 같은 구조가 반복된다.
한 번의 요청 안에 여러 AI step과 deterministic step이 섞여 있다. 외부 dependency가 있다. intermediate artifact가 생긴다. 중간에 기다릴 수 있다. 일부 단계는 다시 실행할 수 있고 일부 side effect는 중복되면 안 된다.
즉 이 문제의 본질은 Long-running Enterprise AI Workload Serving이다.
이런 workload를 서비스하려면 Agent의 reasoning 능력만큼이나 Job의 identity, state, recovery, idempotency가 중요해진다.
직전 글에서 Model Judgment를 분리했다면, 이번에는 Agent Execution을 분리했다
직전 JEV 이메일 분류 글에서는 Model Judgment ≠ Business Decision이라는 결론에 도달했다. 모델이 score와 category 후보를 만들 수 있어도, 그 결과를 어떤 업무 상태로 인정할지는 application이 결정해야 했다.
이번 글에서는 같은 원칙이 execution 쪽에서 다시 나타난다. Agent Execution ≠ Business Job. Agent가 한 번의 작업을 수행할 수 있어도, 그 실행 자체가 업무의 identity와 lifecycle을 소유해서는 안 된다.
두 문제는 결국 같은 방향을 가리킨다. AI capability는 강해질 수 있다. 하지만 Enterprise 시스템에서 그 capability는 bounded contract 뒤에 놓이고, durable authority는 application에 남아야 한다.
오래 사는 Agent가 아니라 오래 사는 업무가 필요했다
처음 질문은 단순했다. “Agent가 기업 PPT template을 분석해서 reusable mold를 만들 수 있을까?” PoC에서는 이 질문에 답하는 것만으로도 충분했다.
하지만 실제 서비스로 옮겨가면 더 중요한 질문이 생긴다. 오래 걸리고 중간에 실패할 수 있는 AI 업무를 사용자가 믿고 맡길 수 있게 하려면, 누가 그 업무를 기억해야 할까?
Agent process가 아니다. 한 번의 HTTP connection도 아니다. 특정 worker도 아니다. 업무의 identity와 state, 이미 확보한 artifact, 실행 evidence, 다음 legal action을 기억하는 durable control plane이어야 한다.
AI 시스템에서 Agent는 앞으로 더 똑똑해지고 더 많은 일을 맡게 될 것이다. 오히려 그렇기 때문에 Agent와 업무 lifecycle을 분리하는 일은 더 중요해질 가능성이 크다.
Enterprise AI에서 중요한 것은 Agent가 오래 살아 있는 것이 아니다. 업무가 Agent보다 오래 살아남는 것이다.