
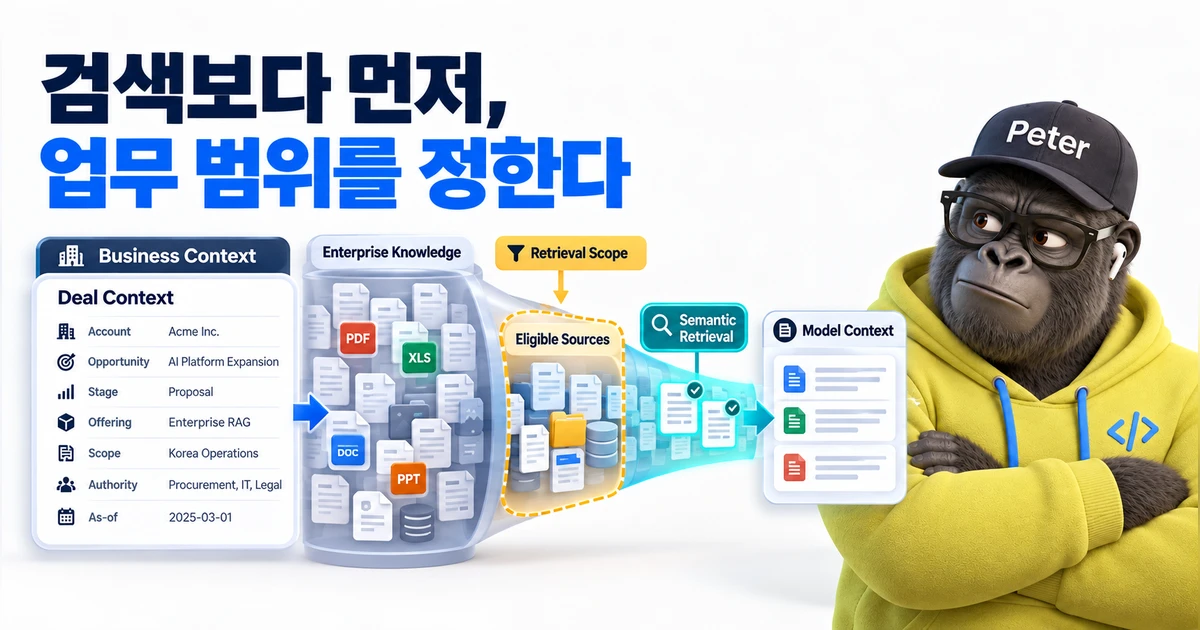
RAG를 설계한다고 하면 대화는 금방 Vector DB, embedding, chunk size, Top-K, reranker로 이동한다. 나도 처음에는 그 순서가 자연스럽다고 생각했다. 문서를 잘 쪼개고, 좋은 embedding을 쓰고, query와 가까운 문서를 잘 찾아오면 답변 품질도 따라올 것처럼 보인다.
그런데 Enterprise 업무를 실제로 들여다보면 그보다 앞선 질문이 하나 있다.
왜 이 문서가 이번 검색의 candidate corpus에 들어와 있는가?
이 질문에 답하지 않은 채 검색 알고리즘부터 개선하면, 시스템은 점점 더 정교하게 잘못된 범위 안에서 좋은 문서를 찾아오기 시작한다. 내가 최근 B2B Deal Intelligence와 RFP 기반 Market Intelligence 흐름을 설계하며 다시 확인한 것도 이 지점이었다.
검색 관련성과 업무 자격은 같은 것이 아니다
Enterprise 지식베이스에는 비슷해 보이는 자료가 많이 있다. 과거 제안서, 다른 고객의 Reference, 제품 소개서, Market Report, Win/Loss 기록, Delivery 자료, 파트너 문서, 현재 Account 자료가 한 조직 안에 함께 존재한다.
Semantic search 입장에서는 이들이 모두 높은 relevance를 가질 수 있다. 예를 들어 물류 자동화 Deal을 검색하는데 다른 고객의 유사한 자동화 제안서가 아주 높은 score로 올라올 수 있다. 기술적으로는 좋은 retrieval이다.
하지만 업무적으로도 좋은 retrieval인지는 별도 문제다. 다른 고객의 confidential context일 수 있고, 현재 Deal과 commercial condition이 다를 수 있으며, 이미 오래된 자료이거나 현재 scope와 관계없는 기능을 포함할 수도 있다.
즉 Enterprise RAG에서는 두 질문을 분리해야 한다.
- Relevant한가? — 현재 query와 의미적으로 관련 있는가
- Eligible한가? — 현재 업무, 권한, 시점, scope에서 evidence로 사용할 자격이 있는가
두 번째 질문이 먼저다.
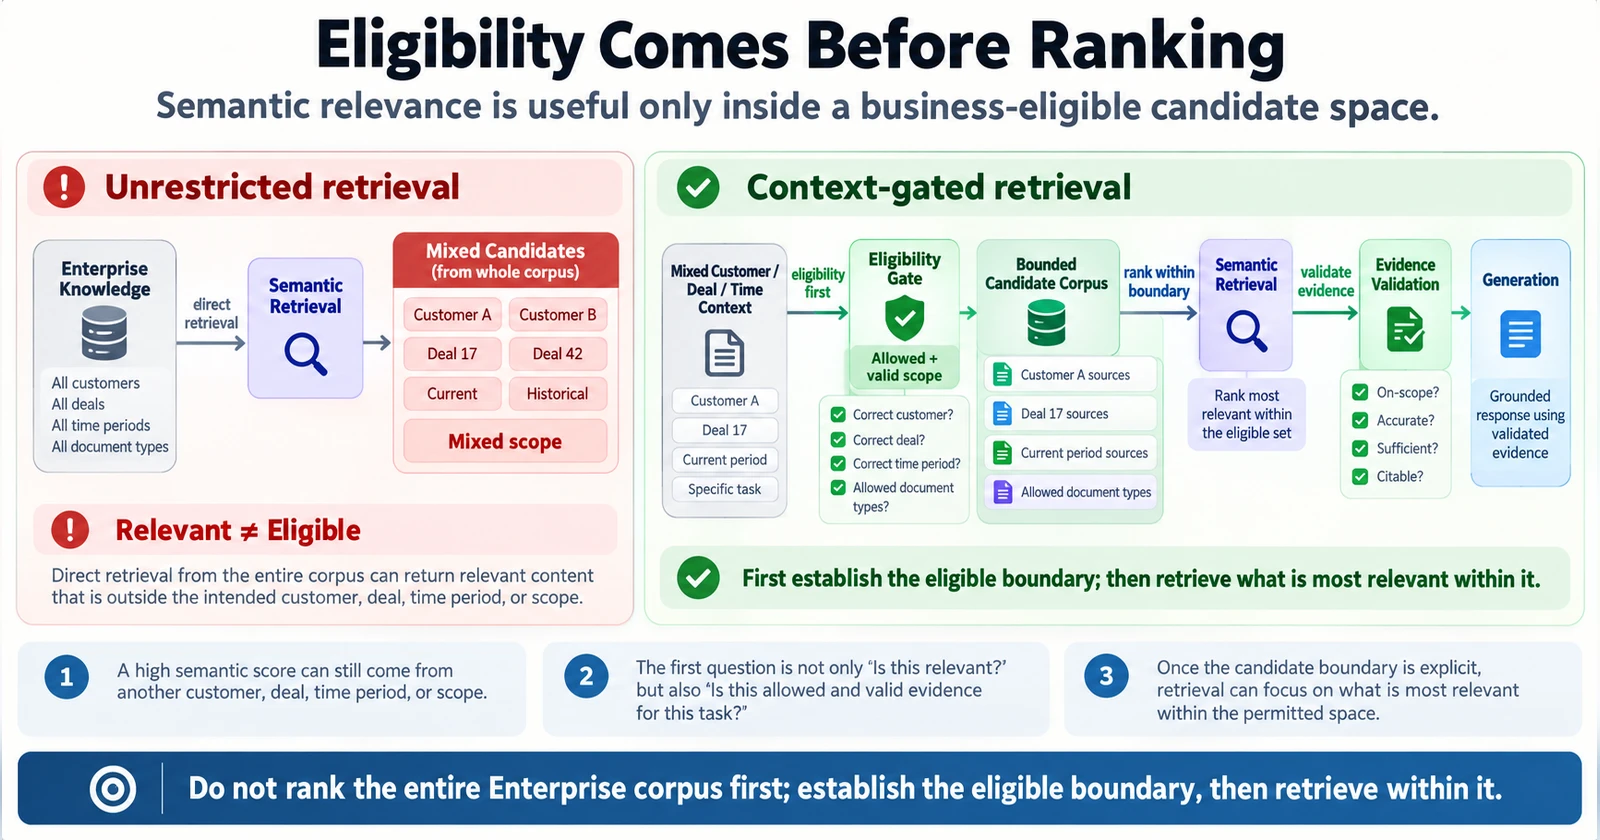
이 관점에서 RAG pipeline은 단순한 Query → Retrieval → Generation보다 다음에 가깝다.
Business Context → Retrieval Scope → Eligible Sources → Retrieval → Evidence Validation → Generation
Semantic search는 사라지지 않는다. 오히려 역할이 더 명확해진다. 전체 지식베이스에서 무엇을 볼지 결정하는 장치가 아니라, 업무적으로 허용된 범위 안에서 무엇이 가장 중요한지 찾는 장치가 된다.
Deal Context를 Retrieval Scope Contract로 바꾼다
그렇다면 검색 전에 어떤 Context를 알아야 할까. B2B Deal을 예로 들면 Account 이름 하나로는 부족하다. 실제 retrieval scope는 여러 업무 축이 함께 결정한다.
예를 들어 다음과 같은 context를 생각할 수 있다.
{
  "account": "Customer A",
  "opportunity_id": "OPP-2026-001",
  "deal_stage": "RFP",
  "industry": "Retail",
  "offering": "Logistics Automation",
  "region": "KR",
  "solution_scope": ["WCS", "Control Integration", "Commissioning"],
  "research_intent": "competitive_strategy",
  "as_of": "2026-10-02"
}
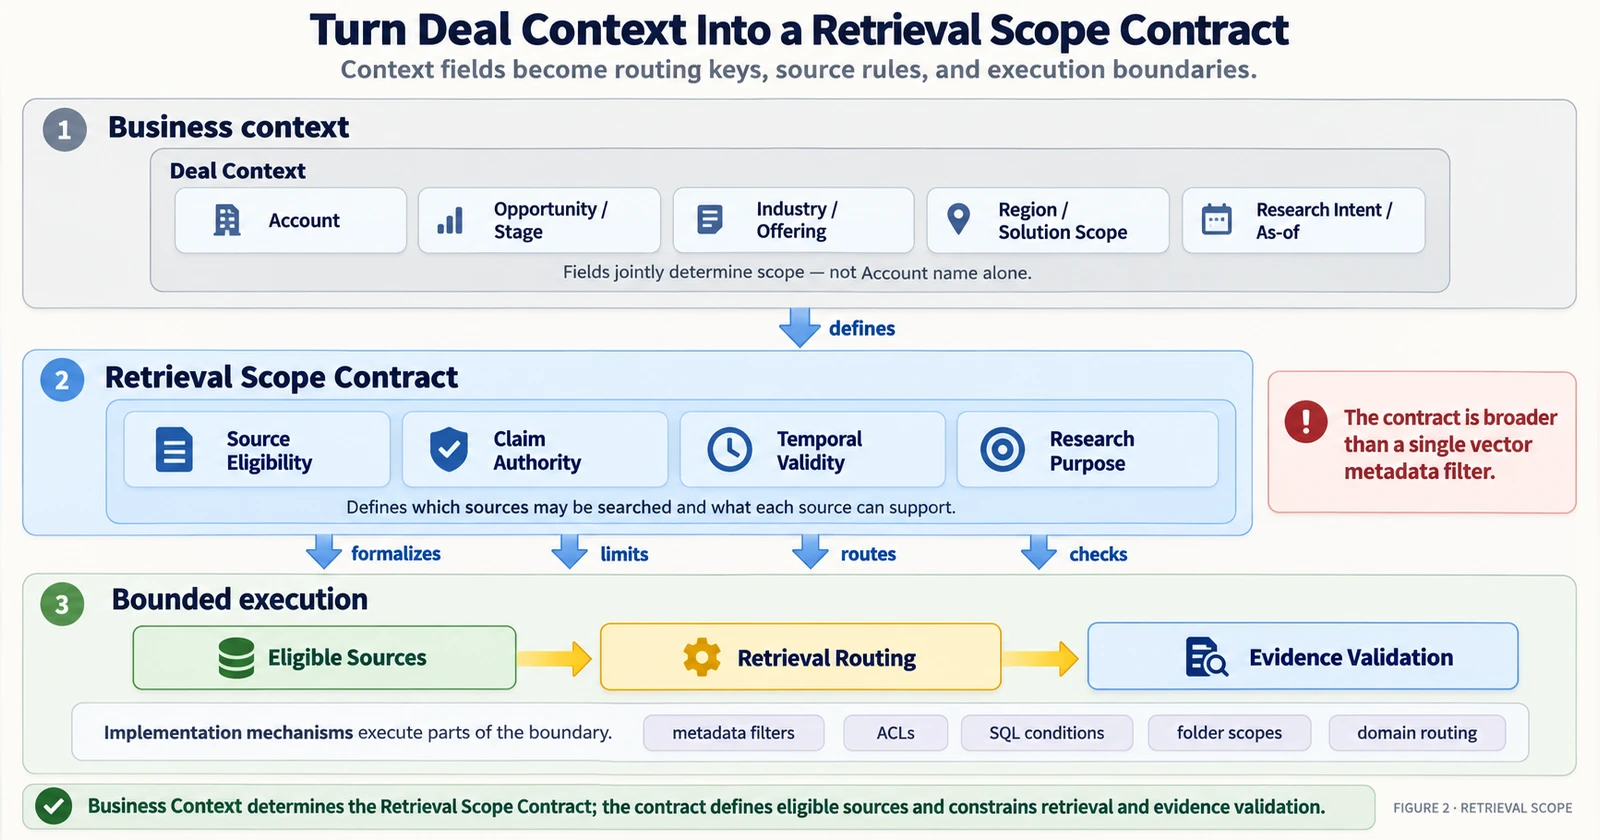
이 JSON이 중요한 이유는 형식 때문이 아니다. 이 필드들이 retrieval routing key로 작동한다는 점이 중요하다.
industry = Retail이고 offering = Logistics Automation이라면, 전체 회사 문서를 대상으로 Top-K를 계산하기 전에 Retail × Logistics Automation에 속하거나 그 Deal에서 허용된 Reference, 경쟁사 자료, 최신 Market evidence처럼 검색 자격이 있는 source class를 먼저 정할 수 있다.
여기서 나는 이를 단순한 metadata filtering보다 Retrieval Scope Contract에 가깝다고 본다. Scope Contract는 어떤 문서를 검색할 수 있는지만 정하지 않는다. 어떤 source가 무엇을 증명할 수 있는지, 어느 시점까지 유효한지, 어떤 업무 목적에서 사용할 수 있는지도 함께 제한한다.
RFP에 단어가 나온다고 모두 검색 범위가 되는 것은 아니다
이 원칙은 최근 Market Intelligence Agent를 설계하면서 특히 선명해졌다. 한 물류 자동화 RFP에는 Cloud, Network, Security, AI, Robotics처럼 검색 욕구를 자극하는 키워드가 많이 등장했다.
그 단어만 보고 research scope를 열었다면 각각의 기술 영역에 대해 시장 자료와 경쟁사 evidence를 찾기 시작했을 것이다. 검색 결과는 풍부했을 가능성이 높다. 하지만 그만큼 현재 Deal과 관계없는 context도 빠르게 늘어난다.
실제 파일럿에서는 다음을 분리했다.
Mention ≠ Integration Dependency ≠ Scope Ownership ≠ Active Research Grain
RFP에 Security가 언급됐다고 Security가 이번 제안의 독립 Offering이라는 뜻은 아니다. AWS가 나온다고 Cloud transformation Deal이 되는 것도 아니다. Robotics가 등장한다고 별도의 Robotics market analysis가 자동으로 필요한 것도 아니다.
현재 Deal에서 실제 scope ownership이 확인되고 전략 판단에 material한 영역만 active research grain으로 열었다. 나머지는 버린 것이 아니라 CONTEXT_ONLY로 남겼다. 결과적으로 primary research grain은 하나의 Industry × Offering 축으로 제한됐다.
여기서 중요한 것은 ‘적게 검색했다’가 아니다. 왜 어떤 영역은 검색했고 어떤 영역은 검색하지 않았는지를 설명할 수 있는 상태를 만들었다는 점이다.
이 차이는 Enterprise에서 크다. 검색 결과가 많아질수록 LLM이 더 똑똑해지는 것이 아니라, 서로 다른 source authority와 시점, customer context가 한 prompt 안에 섞일 가능성도 함께 커지기 때문이다.
Metadata filter만 추가하면 끝나는 문제는 아니다
이 이야기를 WHERE industry = 'Retail' 같은 metadata filter 팁으로 축소하면 핵심을 놓친다.
Metadata filtering은 좋은 구현 수단이다. 하지만 Retrieval Scope는 더 위에 있다.
예를 들어 같은 Retail 자료라도 현재 Account에서 사용할 수 없는 Reference가 있을 수 있다. 같은 Offering 자료라도 3년 전의 capability description은 현재 상태를 증명하지 못할 수 있다. Public market evidence와 내부 Win/Loss 기록은 모두 useful하지만 서로 같은 종류의 claim을 증명하지 않는다.
따라서 scope 결정에는 최소한 세 층이 필요하다.
- Business Context — 지금 어떤 Account, Opportunity, Case, RFP를 다루는가
- Source Eligibility / Authority — 어떤 source class가 현재 질문에 사용될 수 있고 무엇을 증명할 수 있는가
- Retrieval Mechanics — 그 bounded space에서 vector, keyword, SQL, API, web search 중 무엇으로 찾을 것인가
Vector DB의 metadata filter는 세 번째 층의 구현 중 하나일 뿐이다. Salesforce query, SharePoint folder scope, document ACL, SQL condition, web domain routing도 같은 역할을 할 수 있다.
그래서 RAG architecture를 특정 검색 제품의 기능 목록에서 시작하면 책임 경계가 뒤집히기 쉽다. 먼저 업무가 search space를 정의하고, 그 다음 infrastructure가 이를 실행해야 한다.
품질이 나쁘면 embedding보다 먼저 candidate corpus를 본다
RAG 답변이 이상할 때 흔히 확인하는 항목이 있다.
- chunk size가 너무 큰가
- embedding model이 맞지 않는가
- hybrid search가 필요한가
- Top-K가 너무 작은가
- reranker를 추가해야 하는가
- query rewrite가 필요한가
이들은 모두 유효한 질문이다. 다만 Enterprise에서는 그보다 앞에 하나를 추가할 필요가 있다.
왜 이 문서가 candidate corpus에 들어왔지?
잘못된 Account, 다른 Deal, 오래된 policy, 권한 밖 문서가 candidate set 안에 들어온 상태라면 reranker를 개선하는 것은 증상을 줄일 수는 있어도 scope 오류 자체를 해결하지 못한다.
반대로 candidate corpus가 업무적으로 잘 제한되어 있다면 retrieval model이 해야 할 일도 단순해진다. 검색 공간이 작아진다는 계산 비용의 문제가 아니라, 서로 경쟁하면 안 되는 evidence를 처음부터 같은 경쟁 풀에 넣지 않는 것이 핵심이다.
Recall@K 전에 확인해야 할 것
전통적인 retrieval evaluation에는 Recall@K, Precision@K, MRR, NDCG 같은 지표가 유용하다. 하지만 Enterprise RAG에서는 그 앞단의 scope quality도 별도로 봐야 한다.
| 관점 | 묻는 질문 |
|---|---|
| Scope Precision | 검색된 candidate 중 현재 business scope에 실제로 속하는 비율은 어떤가 |
| Authority Violation | 해당 claim을 뒷받침할 자격이 없는 source가 evidence로 사용됐는가 |
| Temporal Validity | 현재 as-of 시점에서 여전히 유효한 evidence인가 |
| Context Coverage | 검색 전에 필요한 Account/Deal/Product context가 충분히 해석됐는가 |
| Cross-scope Leakage | 다른 customer, deal, tenant의 자료가 현재 scope로 섞였는가 |
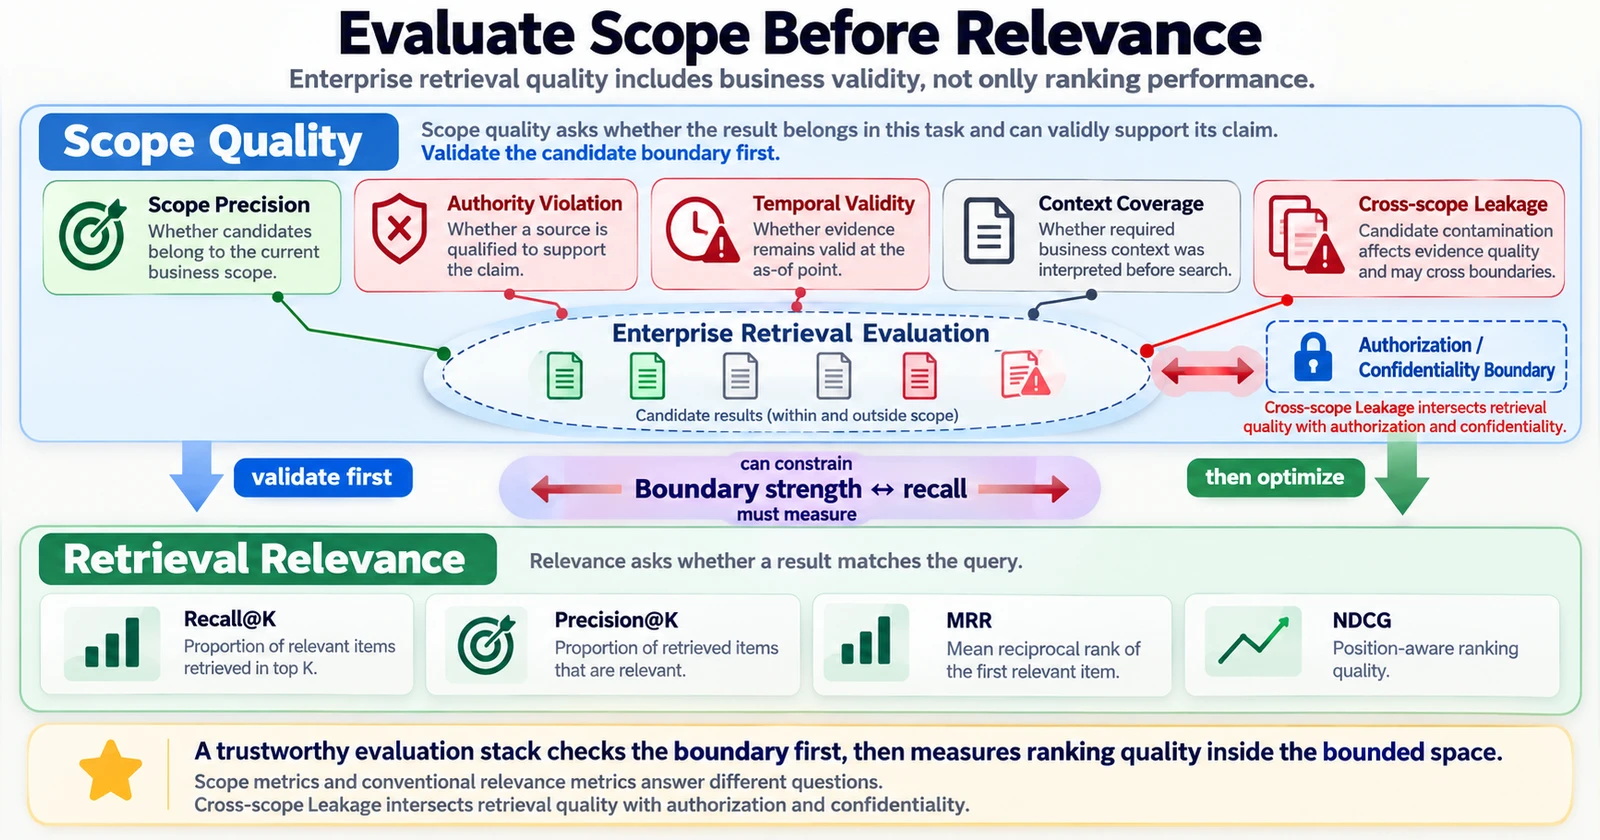
특히 Cross-scope Leakage는 단순한 answer relevance 문제가 아니다. 고객별 confidentiality와 authorization이 결합되는 환경에서는 retrieval quality와 security boundary가 만나는 지점이 된다.
물론 scope를 강하게 좁히면 필요한 문서를 놓칠 위험도 생긴다. 그래서 Context-first RAG는 ‘무조건 더 적게 검색하자’는 주장이 아니다. Business eligibility를 먼저 정의하고, 그 boundary가 recall을 얼마나 훼손하는지 함께 측정하자는 주장에 가깝다.
Context가 Retrieval을 통제하고, Retrieval이 Model Context를 통제한다
Enterprise RAG에서 더 좋은 embedding과 reranker는 분명 중요하다. 하지만 그것만으로는 어떤 지식이 이번 업무의 evidence가 될 수 있는지 결정할 수 없다.
내가 실제 Deal Intelligence 흐름을 설계하며 얻은 결론은 단순했다.
Context가 Retrieval을 통제하고, Retrieval이 Model Context를 통제해야 한다.
Business Context 없이 전체 Enterprise Knowledge를 열어놓은 뒤 LLM에게 알아서 잘 고르라고 하면, 우리는 retrieval 문제와 policy 문제, authority 문제를 한 번에 모델에게 넘기게 된다.
반대로 Account, Deal Stage, Industry, Offering, Scope, Source Authority, as-of 같은 context가 먼저 candidate space를 제한하면 semantic retrieval은 자신이 잘하는 문제에 집중할 수 있다. 주어진 범위 안에서 무엇이 더 relevant한지를 판단하는 일이다.
좋은 Enterprise RAG는 가능한 한 많은 지식을 모델에게 보여주는 시스템이 아니다.
지금 이 업무에서 사용할 자격이 있는 지식만, 필요한 순간에 보여주는 시스템에 더 가깝다.