
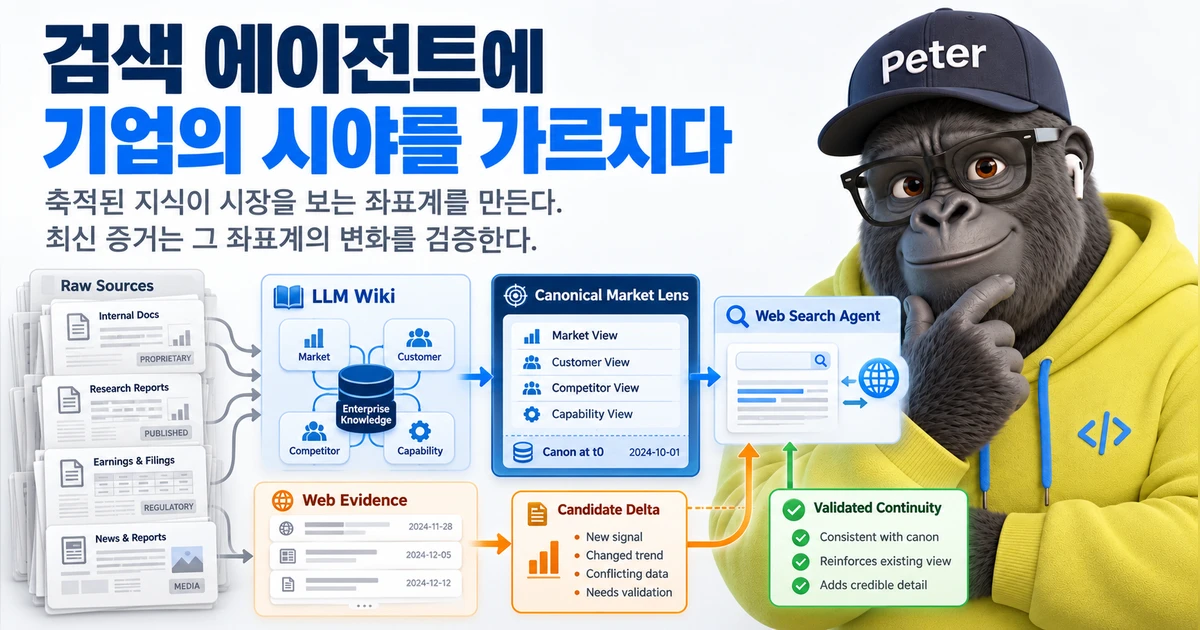
앞선 글에서는 Enterprise RAG가 검색부터 시작하면 안 된다는 이야기를 했다. RFP에 AI, Cloud, Security, Robotics라는 단어가 등장한다고 해서 그 모든 영역을 검색 대상으로 열어버리면, retrieval은 풍부해질 수 있어도 업무 맥락은 오히려 흐려진다. 그래서 Deal Context가 먼저 이번 업무에서 무엇을 검색할 자격이 있는지 정하고, 그 안에서 retrieval이 움직여야 한다고 봤다.
그런데 실제로 이 구조를 설계하다 보니 그 다음 문제가 남았다.
검색할 범위를 정했다고 해서, 어떤 관점으로 시장을 볼 것인지까지 정해지는 것은 아니다.
‘물류 자동화’라는 범위까지 잘 좁혔다고 해보자. 웹에는 최신 로봇 기술, WMS/WES/WCS, 설비 업체, AI Vision, Digital Twin, 고객 투자, 경쟁사 보도자료가 동시에 쏟아진다. 무엇이 현재 전략에 중요한 변화인지 판단하려면 검색 범위 외에 하나가 더 필요하다.
나는 이것을 Market Lens라고 부르고 싶다.
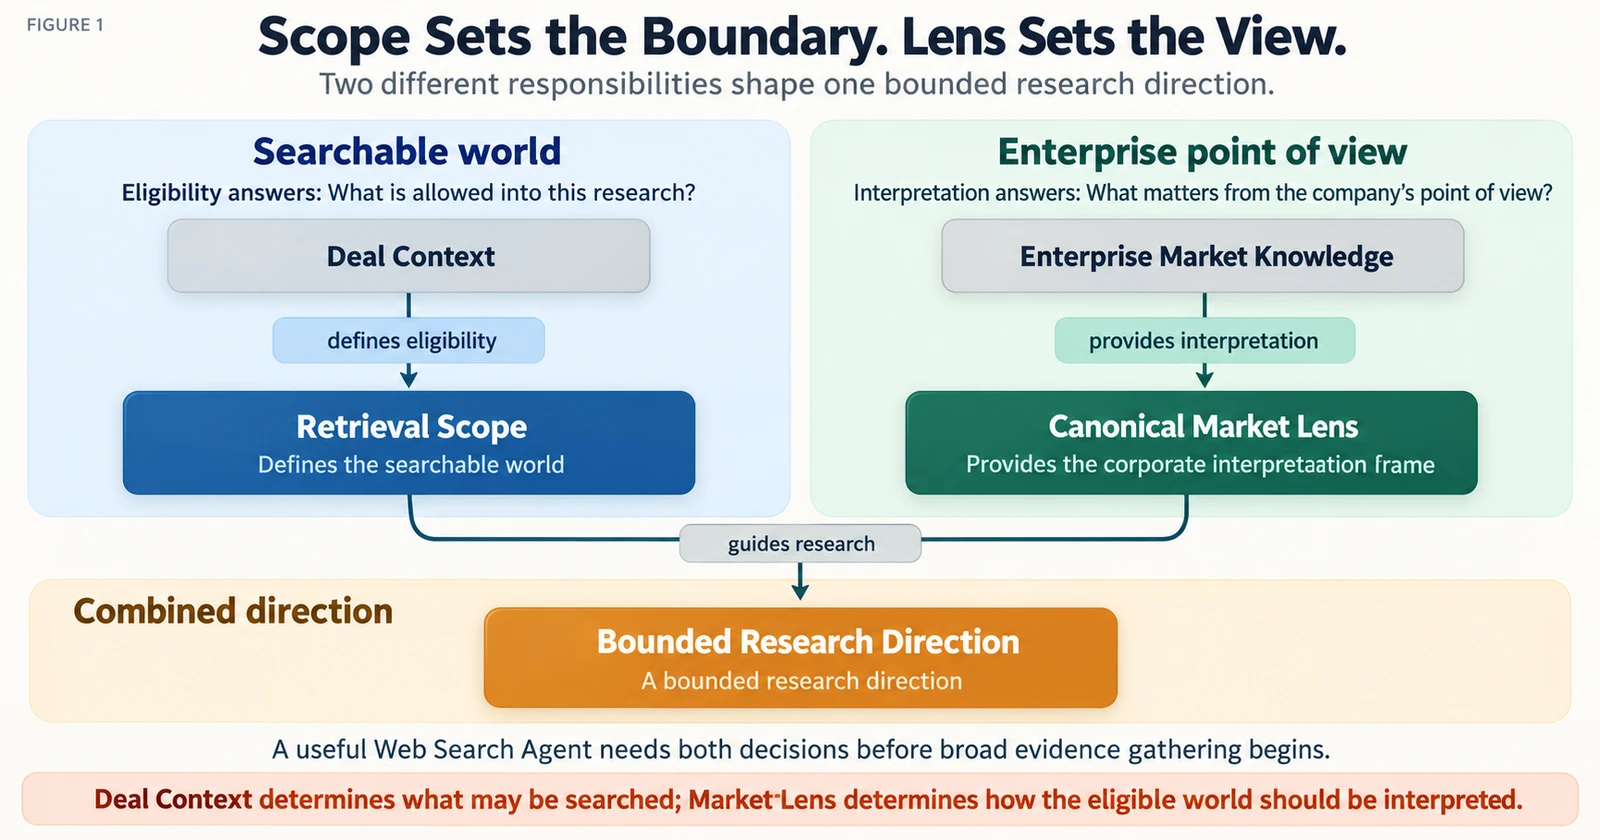
Scope와 Lens는 다른 문제다
Deal Context는 현재 Deal의 산업, Offering, scope, 단계, source authority 같은 정보를 이용해 candidate space를 줄일 수 있다. 하지만 그것만으로는 이런 질문에 답할 수 없다.
- 이 시장에서 고객은 무엇을 구매 기준으로 보는가?
- 경쟁은 가격, 장비 성능, 통합 역량, 운영 안정성 중 어디에서 벌어지는가?
- 주요 경쟁사는 어느 축에서 강한가?
- 우리 회사가 반복적으로 강점을 보이는 영역은 무엇인가?
- 반대로 어떤 변화가 발생하면 기존 차별화가 약해지는가?
이 질문들은 검색 엔진이 결정할 문제가 아니다. 기업은 이미 오랫동안 시장을 나누고 고객을 분석하며 경쟁사를 보고, 자신의 강점과 약점을 학습해 왔다. 전략 보고서, Market Intelligence 자료, 과거 제안서, Win/Loss 기록, 고객 미팅, Delivery 경험에 그 관점이 흩어져 있다.
그래서 나는 다음과 같이 구분하는 편이 명확하다고 본다.
Scope = 이번 업무에서 검색 가능한 세계의 경계
Lens = 그 세계를 해석하는 기업의 관점
Enterprise Web Search의 품질을 높이려면 둘 다 필요하다.
보고서를 매번 다시 넣는 것은 지식 축적이 아니다
가장 단순한 구현은 어렵지 않다. 새로운 RFP가 들어올 때마다 관련 시장 보고서, 경쟁사 자료, 과거 제안서, 고객 리서치를 함께 Context Window에 넣으면 된다.
개념적으로는 이런 형태다.
New RFP + MI Report + Competitor Report + Previous Proposal + Customer Research → LLM
PoC에서는 충분히 작동할 수 있다. 문제는 이 방식이 같은 지식을 매번 다시 해석하게 만든다는 점이다.
가령 시장 보고서는 작년에 작성됐고, 경쟁사 분석은 올해 초에 갱신됐으며, 특정 고객에 대한 관찰은 지난달에 추가됐다고 해보자. 이 문서를 한 번에 넣으면 LLM은 매 실행마다 어느 자료가 baseline이고, 어느 자료가 새로운 evidence이며, 어떤 주장이 이미 superseded되었는지 다시 판단해야 한다.
Token 비용보다 더 큰 문제는 관점의 일관성이다.
어떤 실행에서는 최신 기사 하나가 오래 검증된 기업 taxonomy보다 강하게 반영될 수 있다. 다른 실행에서는 과거 제안서의 표현이 현재 시장 정의처럼 읽힐 수도 있다. 같은 기업의 Agent인데도 질문할 때마다 시장을 보는 좌표계가 조금씩 달라진다.
이것은 retrieval 문제가 아니라 knowledge lifecycle 문제에 가깝다.
LLM Wiki는 raw document와 현재 지식을 분리한다
2026년 4월 Andrej Karpathy가 공개한 LLM Wiki 아이디어가 여기서 흥미롭게 연결된다.
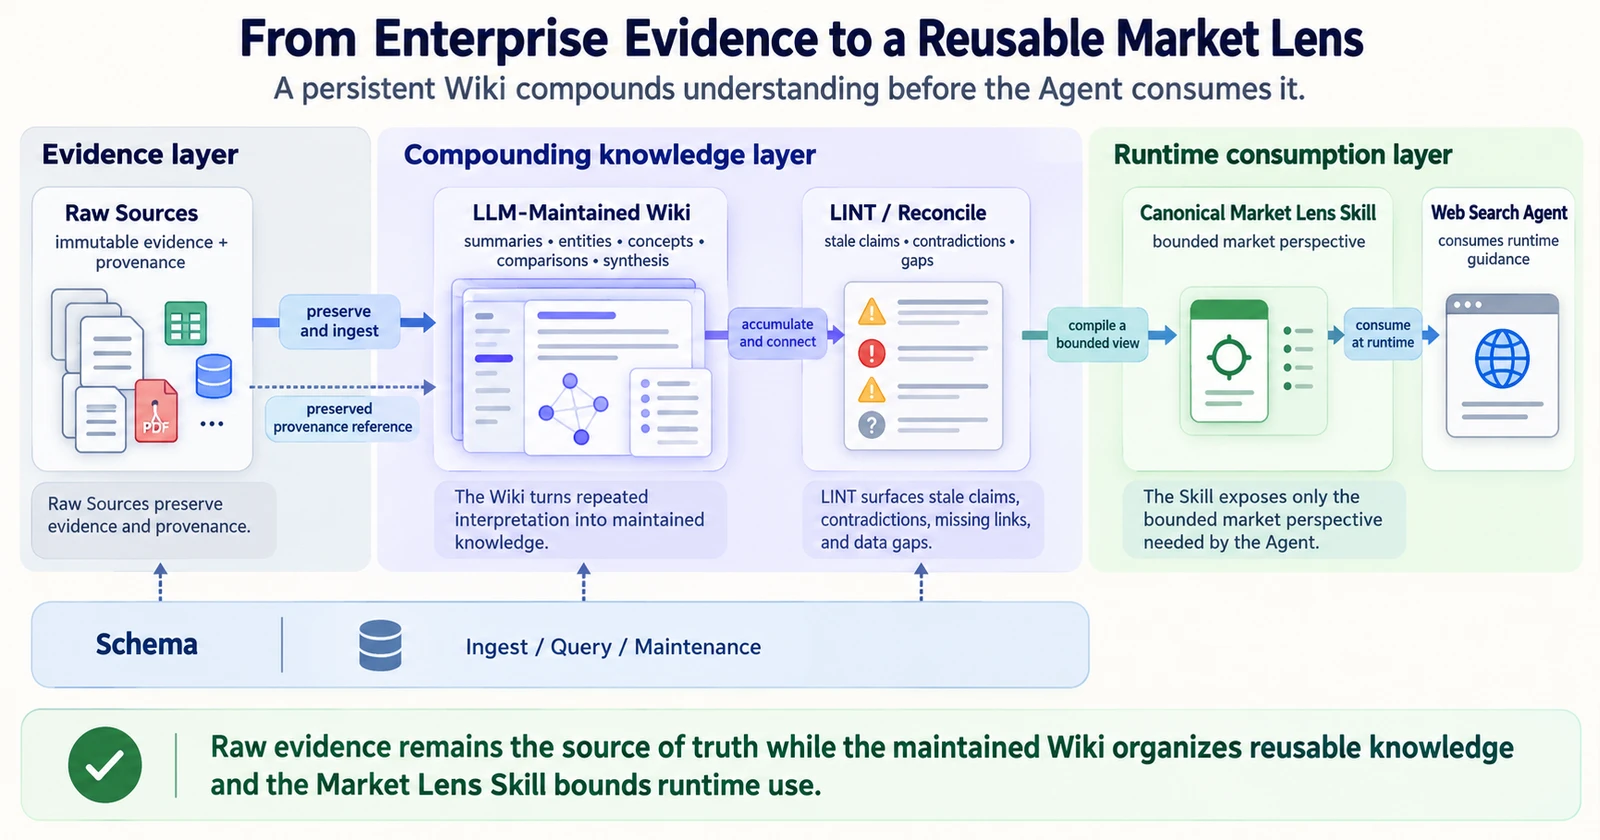
Karpathy가 지적한 기존 RAG의 한계 중 하나는 매 질문마다 raw document에서 필요한 조각을 다시 찾아 knowledge를 재구성한다는 점이다. 대신 그는 raw source와 사용자 사이에 LLM이 지속적으로 관리하는 persistent wiki를 두는 패턴을 제안한다.
핵심 구조는 세 층이다.
- Raw Sources — 원본 자료. LLM이 읽지만 수정하지 않는 source of truth
- Wiki — LLM이 summary, entity, concept, comparison, synthesis를 축적하고 서로 연결하는 지식 계층
- Schema — 어떤 구조와 규칙으로 ingest, query, maintenance를 수행할지 정하는 운영 계약
그리고 이 Wiki에는 단순한 ingest만 있는 것이 아니다. 새 source가 들어오면 기존 페이지를 갱신하고, 충돌하는 주장을 표시하며, query를 통해 만들어진 유용한 synthesis도 다시 축적할 수 있다. 주기적인 Lint는 stale claim, contradiction, missing cross-reference, data gap을 찾아낸다.
중요한 것은 Wiki가 단순 검색 index가 아니라는 점이다.
Knowledge를 매번 다시 조립하는 대신, 한 번 얻은 이해를 다음 질문이 재사용할 수 있는 형태로 누적한다.
이 아이디어를 Enterprise MI에 적용하면 꽤 다른 가능성이 열린다.
Enterprise MI를 하나의 compounding knowledge layer로 본다
기업이 시장을 바라보는 방식은 보통 한 문서에 완결되어 있지 않다.
예를 들면 다음과 같은 자료가 시간이 지나며 계속 들어온다.
- Market Definition과 Industry / Offering taxonomy
- 고객의 구매 기준과 투자 방향
- 경쟁사의 제품, Reference, M&A, partnership 변화
- 자사의 capability와 delivery 경험
- Win/Loss에서 반복해서 드러난 강점과 약점
- 시장 기술 트렌드와 regulation
- 실제 Deal에서 발견된 새로운 질문
이것을 모두 매번 prompt에 넣을 것이 아니라, source는 provenance를 보존한 채 두고 그 위에 현재의 합의된 지식 모델을 유지할 수 있다.
예를 들어 한 물류 시장 Lens가 다음과 같은 구조를 가진다고 해보자.
- Sector — Fulfillment / Warehouse Automation, WMS·WES·WCS, Robotics, Control Integration, Transportation, Lifecycle Operation
- Customer Buying Criteria — throughput, 안정화 기간, 납기, 장애 복구, 운영 안정성
- Competitive Axes — 장비 성능, integration, software control, observability, lifecycle operation
- Competitor Position — 어느 축에서 누가 강한지
- Our Capability — integration, commissioning, operation 등 반복적으로 증명된 강점
- Known Gap — robotics breadth, 제조 lead time처럼 전략적으로 확인해야 할 취약점
- Strategic Questions — 무엇이 바뀌면 현재 positioning을 다시 평가해야 하는지
이렇게 되면 새 RFP는 더 이상 시장을 처음부터 공부하게 만드는 문서가 아니다.
RFP는 매번 바뀌지만, 기업이 시장을 나누는 기준과 경쟁을 이해하는 방식은 누적되는 자산이다.
Wiki와 Skill은 같은 것이 아니다
여기서 한 단계 더 분리할 필요가 있다.
Enterprise Wiki는 넓은 knowledge layer다. 시장 정의뿐 아니라 source summary, 고객 history, 경쟁사 변화, 과거 분석, contradiction, confidence가 함께 존재할 수 있다.
반면 Web Search Agent가 한 번의 업무에서 소비해야 하는 것은 그 전체가 아니다.
따라서 Wiki에서 현재 업무에 필요한 부분을 Market Lens Skill 형태로 bounded하게 꺼내는 구조가 더 적합하다.
개념적으로 Skill에는 이런 내용이 들어갈 수 있다.
- market scope와 taxonomy
- customer buying criteria
- competitive axes
- known competitor positions
- company strengths / known gaps
- strategic questions
- knowledge baseline의 as-of
- evidence references
- freshness / review policy
여기서 Skill이라는 표현은 단순한 system prompt를 뜻하지 않는다. Agent가 해당 시장을 조사할 때 재사용하는 domain research contract에 가깝다.
Wiki가 ‘우리가 무엇을 알고 있는가’를 축적한다면, Skill은 ‘이번 Agent가 그 지식을 어떤 관점으로 사용할 것인가’를 제한한다.
물류 RFP를 읽을 때 무엇이 달라지는가
가상의 예를 하나 들어보자.
한 물류기업의 신규 자동화 RFP에 Sorter, Conveyor, PLC, WCS, WMS, Robot, AI, Network, Security, Cloud, Monitoring, API, Digital Twin 같은 용어가 함께 등장했다고 하자.
Lens가 없는 Web Search Agent라면 자연스럽게 최신 warehouse automation trend, robotics market, AI logistics, Digital Twin 같은 검색어를 넓게 확장할 가능성이 높다.
정보는 많이 얻는다. 하지만 그 정보가 현재 기업의 전략을 강화하는지, 반박하는지, 혹은 애초에 중요하지 않은지는 별도 문제다.
반면 기업이 이미 해당 시장을 sector로 구분하고 각 sector의 Buying Criteria, Competitive Axis, Competitor Position, Our Strength / Gap을 관리하고 있다면 시작점이 달라진다.
Agent는 ‘물류 자동화란 무엇인가’부터 다시 학습할 필요가 없다. 기존 Lens를 baseline으로 삼고, 새 RFP가 그 Lens의 어느 부분을 활성화하는지만 보면 된다.
이것이 내가 기업 MI를 Search Agent의 Skill로 만드는 아이디어에서 가장 큰 실익이라고 보는 부분이다.
기업의 Market Lens가 없다면 Web Search는 시장을 설명한다. Market Lens가 있다면 Web Search는 그 기업이 시장에서 무엇을 확인해야 하는지를 찾을 수 있다.
다만 여기서 실제로 어떤 RFP signal을 꺼내고, 어떤 전략 가설을 만들며, 어떤 query로 경쟁사와 시장의 현재 evidence를 검증할지는 다음 단계의 문제다. 이 글에서는 그 지점까지 가지 않는다.
Canon은 영원한 진실이 아니라 time-bounded baseline이다
Market Lens를 Canon이라고 부르면 오해하기 쉬운 부분이 있다.
Canon은 변하지 않는 진실이 아니다.
예를 들어 작년 시장 분석에서 특정 경쟁사를 ‘장비에는 강하지만 software control integration evidence는 제한적’이라고 봤다고 하자. 그 판단은 당시 evidence를 기반으로 한 합리적인 baseline일 수 있다. 하지만 올해 경쟁사가 새로운 제품을 출시하고 대형 reference를 확보했다면 그대로 유지해서는 안 된다.
따라서 Lens에는 반드시 시간축이 있어야 한다.
Canon at t0 → Temporal Gap → Current Evidence at t1 → Candidate Delta
Web Search의 역할도 여기서 명확해진다.
‘현재 시장이 무엇인지 처음부터 정의하라’가 아니라,
우리의 마지막 validated baseline 이후 무엇이 달라졌는가?
를 묻는 것이다.
Web Search도 외부 knowledge를 현재 context로 끌어온다는 의미에서는 광의의 retrieval-augmented context expansion으로 볼 수 있다. 하지만 중요한 것은 Web Search라는 도구 자체가 아니다. 무엇을 baseline으로 삼고 어떤 변화만 material하게 볼 것인지가 먼저다.
Fresh하다고 Canonical한 것은 아니다
반대 방향의 위험도 있다.
최신 Web Evidence를 발견했다고 해서 그것이 곧바로 Canon을 바꿔서는 안 된다.
경쟁사의 보도자료 하나, 출처가 불명확한 시장 기사 하나, 실제 production capability가 검증되지 않은 roadmap 하나가 기존 Lens를 즉시 overwrite하면 knowledge base는 최신이 아니라 불안정해진다.
그래서 update path는 다음과 같이 분리하는 편이 안전하다.
Web Evidence → Provenance / Date Validation → Candidate Delta → LINT against Canon → Keep / Supersede / Promote / Reject
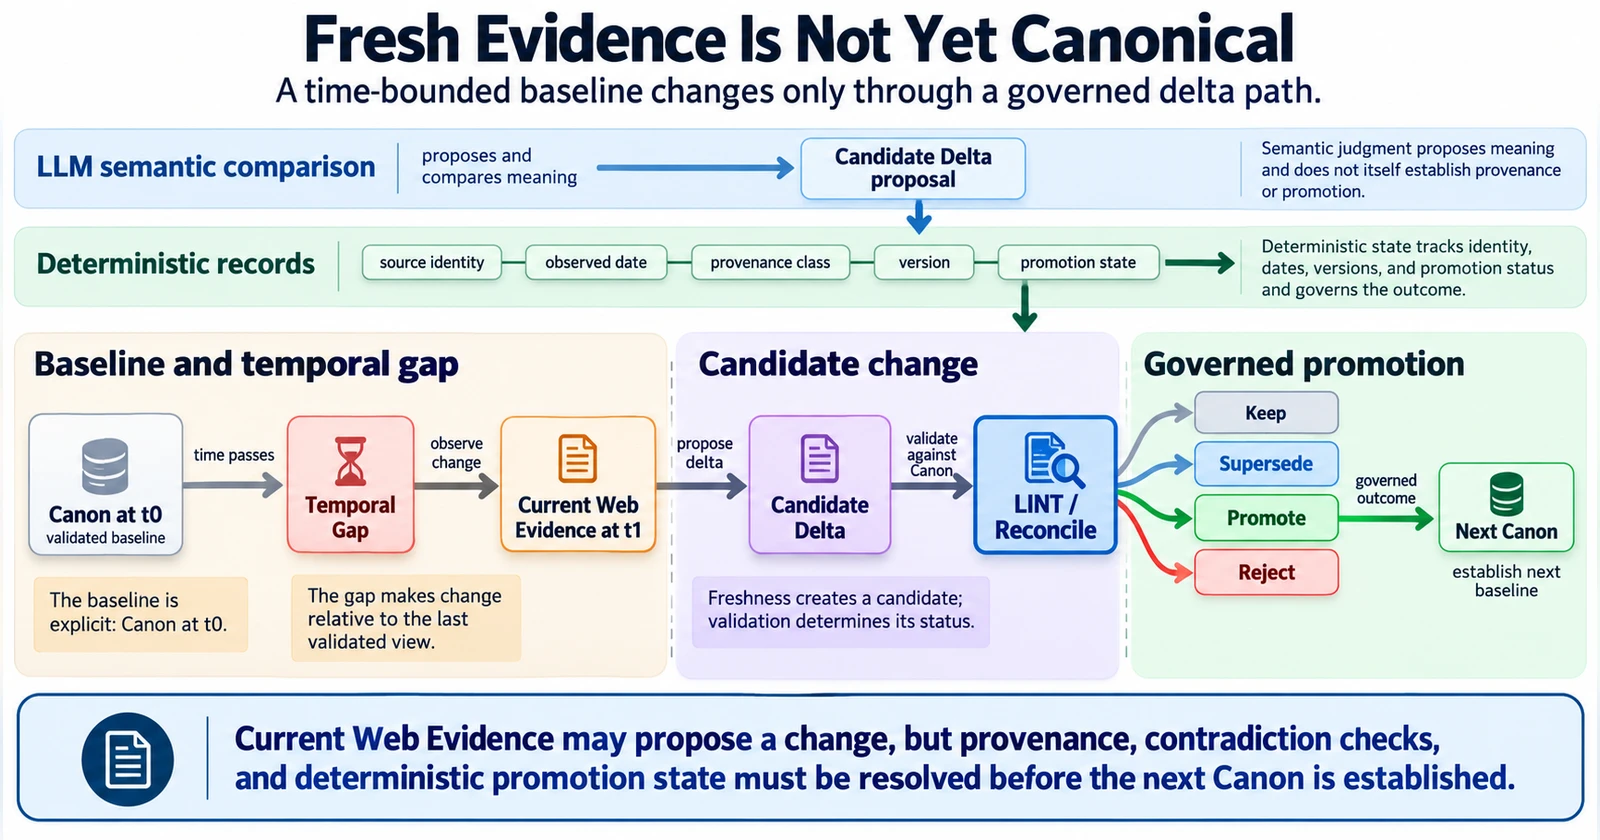
여기서 LLM이 잘할 수 있는 일과 deterministic하게 남겨야 할 일도 구분된다.
LLM은 새로운 source를 읽고 semantic similarity를 찾거나, 기존 claim과의 contradiction을 발견하고, candidate delta를 제안하는 데 적합하다.
하지만 source identity, observed date, provenance class, current version, 어떤 claim이 실제 Canon으로 승격됐는지 같은 상태는 deterministic하게 기록하는 편이 낫다.
LLM은 Lens를 해석하고 갱신 후보를 제안할 수 있다. 그러나 무엇이 현재 Canon인지는 시스템이 추적해야 한다.
Search Agent가 시간이 지날수록 기업에 맞아지는 구조
이 구조가 흥미로운 이유는 Web Search Agent가 한 번의 검색을 잘하게 만드는 데서 끝나지 않기 때문이다.
새 시장 자료가 들어오고, 새로운 고객 패턴을 발견하고, 경쟁사의 역량이 바뀌고, 우리 회사의 Win/Loss 경험이 쌓이면 Wiki를 LINT한다. 검증된 변화는 Market Lens에 반영된다. 다음 Deal은 더 나아진 Lens에서 시작한다.
흐름을 단순화하면 다음과 같다.
Enterprise Evidence → Wiki → LINT / Reconcile → Market Lens Skill → New Work → New Evidence → Next LINT
이렇게 보면 기업의 MI 자료는 단순한 RAG corpus가 아니다.
잘 관리하면 Agent가 외부 세계를 바라보는 좌표계가 된다.
그리고 그 좌표계는 보고서가 한 번 만들어졌을 때 완성되는 것이 아니라, 새로운 evidence와 실제 업무 경험을 통해 계속 도수가 맞춰진다.
좋은 Enterprise Research Agent는 매번 세상을 처음부터 공부하는 Agent가 아니다.
이미 축적된 기업의 관점을 기억하되, 그 관점이 아직 유효한지는 계속 의심할 수 있는 Agent에 더 가깝다.
다음 글에서는 여기서 한 단계 더 내려가려 한다.
Canonical Market Lens를 가진 상태에서 실제 신규 RFP가 들어오면, 어떤 signal을 꺼내고 어떤 질문을 만들어야 할까. 그리고 Web Search를 단순 정보 수집이 아니라 기존 전략 가설을 강화하거나 약화시키는 검증 도구로 바꾸려면 무엇이 필요할까.
그 지점부터는 Lens를 만드는 문제가 아니라 Lens를 사용하는 문제다.