
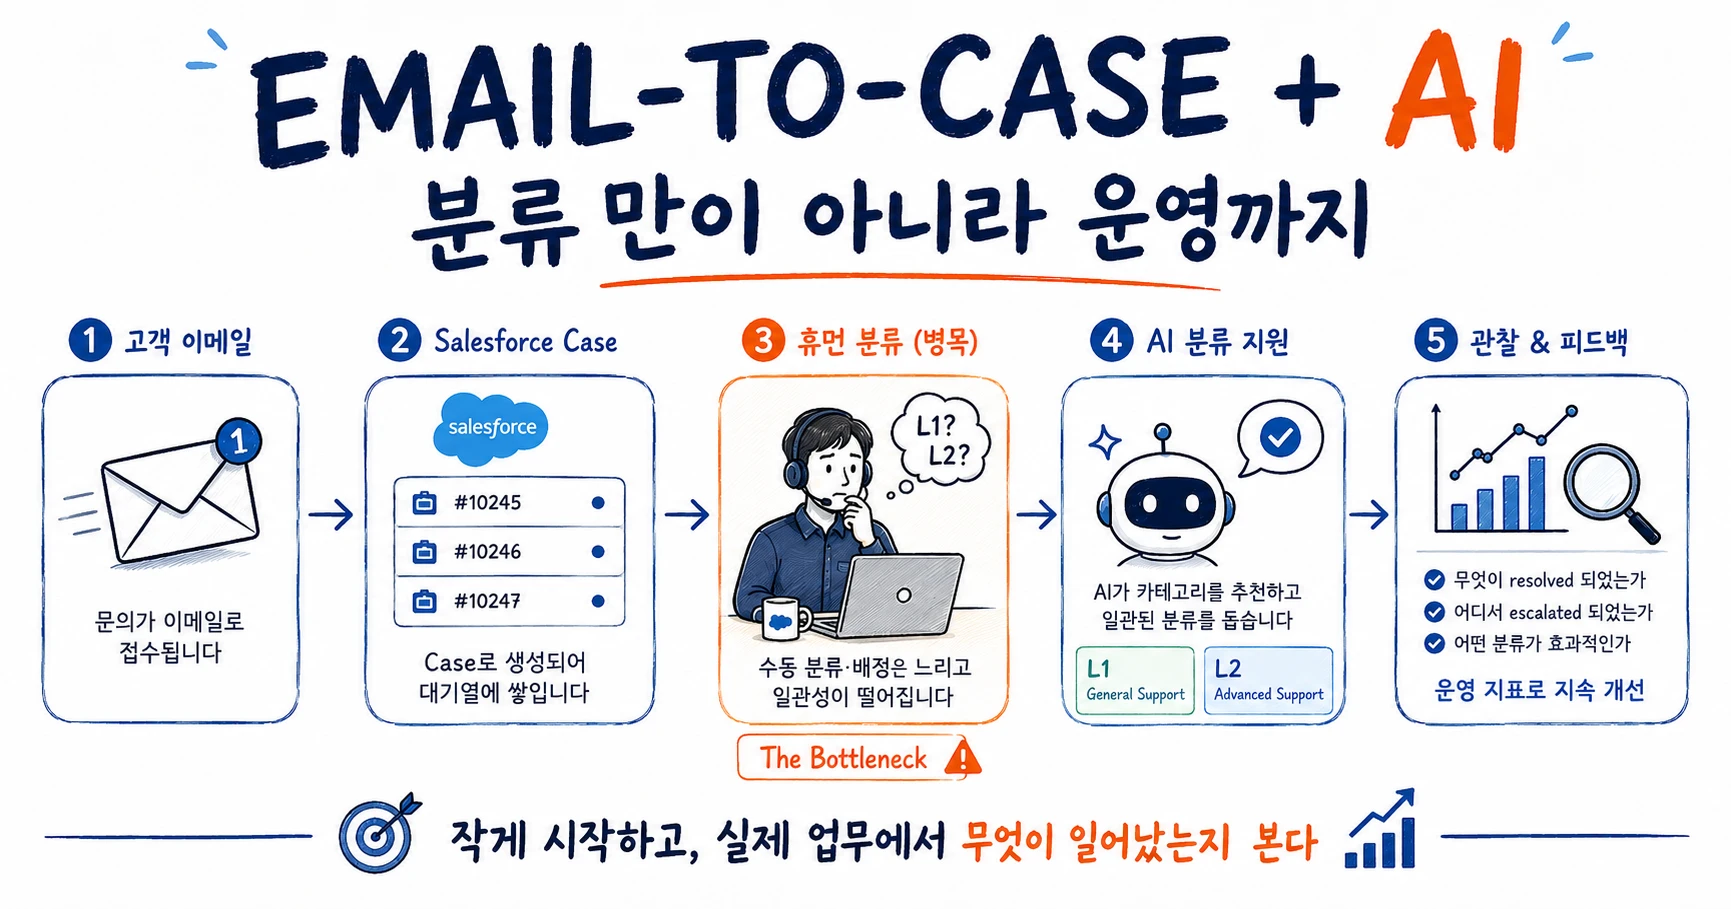
기업에서 AX를 이야기하다 보면, 잘 정리된 데이터와 프로세스 위에 AI를 연결하는 모습을 떠올리기 쉽다.
하지만 내가 실제로 마주치는 기업 환경은 대체로 그렇지 않았다. DX 자체가 아직 완결되지 않은 경우도 많고, 여러 시기에 서로 다른 조직과 프로젝트를 거쳐 만들어진 시스템이 이미 운영되고 있다. 그 안에는 기존 사용자와 업무 규칙이 있고, 다른 조직이 관리하는 화면과 자동화도 있다.
AI 프로젝트는 이런 환경을 새로 만들고 시작하는 일이 아니라, 대부분 이미 돌아가고 있는 시스템 위에 들어간다.
그래서 AX를 설계할 때는 AI를 얼마나 잘 아는지만큼이나, 기존 시스템이 무엇을 하고 있고 사람들이 그 안에서 실제로 어떻게 일하는지를 빠르게 이해하는 것이 중요하다고 생각한다. 그렇지 않으면 이미 있는 기능을 다시 만들거나, 필요 이상으로 프로젝트 범위를 키우기 쉽다.
이번에 소개할 사례는 그런 Enterprise AX 문제 가운데서도 비교적 단순한 편에 속한다.
복잡하게 흩어진 사내 데이터를 연결할 필요도 없었고, RAG를 구축할 필요도 없었다. ERP와 CRM, 문서 저장소를 한꺼번에 엮는 문제도 아니었다.
고객이 보낸 이메일을 읽고 Salesforce Case의 Level 1과 Level 2 Category를 정하는 것이 전부였다.
그런데 이 정도로 단순해 보이는 문제도 실제 업무가 돌아가는 장면까지 생각하기 시작하면, AI 모델 바깥에서 고민해야 할 것이 빠르게 늘어난다.
1. 고객이 원한 것은 단순한 분류였다
고객은 Salesforce의 Email-to-Case를 사용하고 있었다.
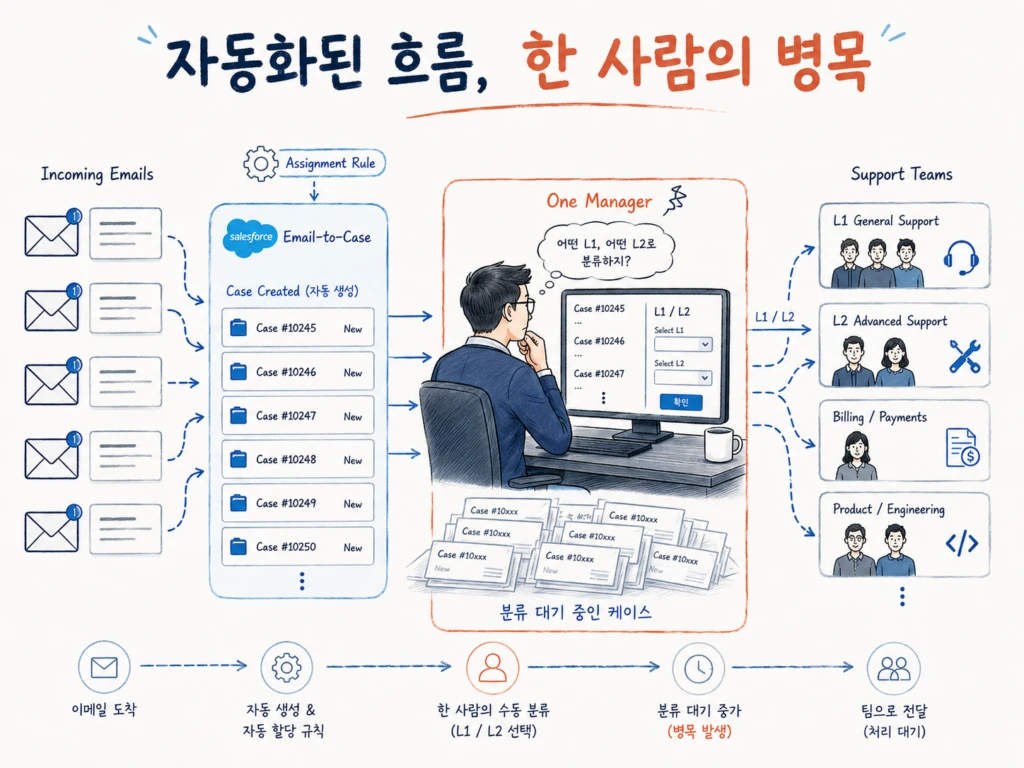
고객이 서비스 이메일 주소로 메일을 보내면 Salesforce가 EmailMessage와 Case를 생성하고 연결한다. Category가 정해지고 나면 이미 구축되어 있는 Assignment Rule이 적절한 담당 조직으로 Case를 배정한다.
즉 대부분의 흐름은 이미 시스템 안에서 돌아가고 있었다.
문제는 Category를 판단하는 지점이었다.
해당 조직에서는 문의 유형을 Level 1과 Level 2로 관리하고 있었고, Level 2는 Level 1에 종속된 구조였다.
새로운 Case가 들어올 때마다 이메일 내용을 읽고 적절한 Level 1을 선택한 뒤, 그 아래 Level 2까지 결정해야 했다. 이 일을 특정 매니저 한 명이 맡고 있었다.
시스템 자체가 멈춰 있는 것은 아니었다. 하지만 모든 신규 Case가 결국 한 사람의 판단을 거쳐야 다음 담당 조직으로 흘러갈 수 있었다.
Case가 늘어나면 전체 처리 속도 역시 그 사람이 얼마나 빨리 이메일을 읽고 Category를 정할 수 있는지에 영향을 받는다.
고객의 질문은 명확했다.
“이 부분만 AI가 분류해 줄 수 있을까요?”
처음에는 나도 이 문제를 어렵게 볼 이유가 없다고 생각했다.
가능하다.
그리고 이 요구사항만 놓고 보면 정말 복잡하게 만들 필요도 없다.
2. AI보다 먼저 봐야 했던 것은 Salesforce였다
이런 요청을 받으면 바로 LLM부터 생각하기 쉽다.
어떤 모델을 사용할지, Prompt는 어떻게 구성할지, Agent를 써야 할지, 혹시 RAG까지 필요한지를 먼저 고민하는 식이다.
하지만 이번 경우에는 그보다 먼저 확인해야 할 것이 있었다.
고객이 이미 사용하고 있는 Salesforce가 어디까지 해주고 있는가였다.
Email-to-Case는 고객의 이메일을 받아 Case와 EmailMessage를 생성하고 연결하고 있었다. Category가 결정된 이후에는 기존 Assignment Rule이 적절한 담당 조직으로 Case를 전달하고 있었다. 상담원들이 Case를 확인하고 처리하는 화면과 업무 방식도 이미 만들어져 있었다.
즉 처음부터 다시 설계해야 하는 시스템이 아니었다.
기존 구조를 이해하고 나니 AI가 새롭게 담당해야 할 영역은 오히려 아주 작아졌다.
최초 이메일을 읽고, 이미 정해져 있는 Taxonomy 안에서 Level 1과 Level 2를 판단하는 것.
그 정도면 됐다.
나머지는 Salesforce가 이미 잘하고 있는 일을 그대로 사용하면 된다.
이런 판단에서는 AI에 대한 지식만큼 기존 서비스에 대한 경험과 이해가 중요하다.
Salesforce를 충분히 알지 못했다면 이메일을 별도의 시스템으로 가져오고, 새로운 Routing Logic을 만들고, 상태를 별도로 관리하는 식으로 필요 이상으로 설계를 키웠을 수도 있다.
Enterprise AX에서는 이런 상황을 자주 만난다.
대부분의 고객은 AI를 위해 새로운 시스템을 처음부터 만들고 있지 않다. 이미 운영 중인 CRM이 있고, 기존 화면이 있고, 다른 조직이 관리하는 Automation과 Integration이 있다. 잘 만들어진 부분도 있고, 오래된 부분도 있다.
그 위에 AI가 들어간다.
그래서 중요한 것은 AI로 무엇을 새로 만들 수 있는가만 보는 것이 아니다.
이미 존재하는 시스템이 잘하고 있는 일은 그대로 두고, 사람의 판단 때문에 막혀 있는 지점만 정확하게 찾아내는 것이 더 중요할 때가 많다.
이번 사례에서는 그 지점이 명확했다.
이메일을 읽고 Category를 결정하는 판단.
AI가 맡아야 할 영역은 바로 그 한 부분이었다.
3. 이 정도면 굳이 Agent가 필요하지 않았다
최근 Enterprise AI를 이야기하면 거의 모든 문제에 Agent라는 단어가 따라붙는다.
하지만 이번 요구사항에는 굳이 Agent가 필요하지 않았다.
장기 Memory도 필요하지 않았고, 복잡한 Retrieval이나 RAG도 필요 없었다.
최초 Case가 만들어졌을 때 연결된 첫 EmailMessage를 가져온다.
필요한 전처리를 한다.
현재 사용할 수 있는 Level 1과 Level 2 Category를 모델에 알려준다.
모델은 정해진 형식으로 결과를 반환한다.
Salesforce는 그 결과가 허용된 Category인지 검증한 뒤 Case에 기록한다.
그 다음부터는 기존 Assignment Rule이 처리한다.
Workflow 전체를 AI에게 넘기는 것이 아니라, 기존 Workflow 안에서 사람의 판단이 필요했던 특정 순간만 AI에게 맡기는 것.
내가 이전 글에서 이야기했던 Agentic Moment도 사실 이런 장면에 더 가깝다.
이번 경우 그 순간은 아주 명확했다.
“이 이메일은 어느 Category인가?”
여기까지 구현하면 고객이 최초에 이야기한 요구사항은 충족된다.
비용도 크지 않고, 기존 Salesforce를 거의 건드리지 않으며, 사용자에게 새로운 화면을 학습시킬 필요도 없다.
실제 프로젝트라면 이것만으로도 충분히 좋은 첫 번째 Scope가 될 수 있다.
Deterministic Trigger
↓
Context Preparation
↓
Bounded AI Judgment
↓
Output Validation
↓
Existing Salesforce Automation
4. 그런데 실제 상담원이 일하는 모습을 생각해봤다
문제는 시스템 Diagram을 그릴 때보다 실제 상담원이 일하는 장면을 떠올렸을 때부터 생기기 시작했다.
가장 먼저 든 생각은 단순했다.
AI가 틀리면 어떻게 되지?
예를 들어 AI가 어떤 이메일을 Technical Support로 분류했다고 해보자.
기존 Assignment Rule은 해당 Case를 Technical Support 담당 조직으로 보낸다. 담당자는 Case를 Pickup하고 이메일 내용을 확인한다.
그런데 읽어보니 이런 생각이 들 수 있다.
“이건 우리 팀 문의가 아닌데?”
결국 담당자는 Category를 다시 변경하거나 다른 담당 조직으로 넘긴다.
여기서 재미있는 점이 하나 있다.
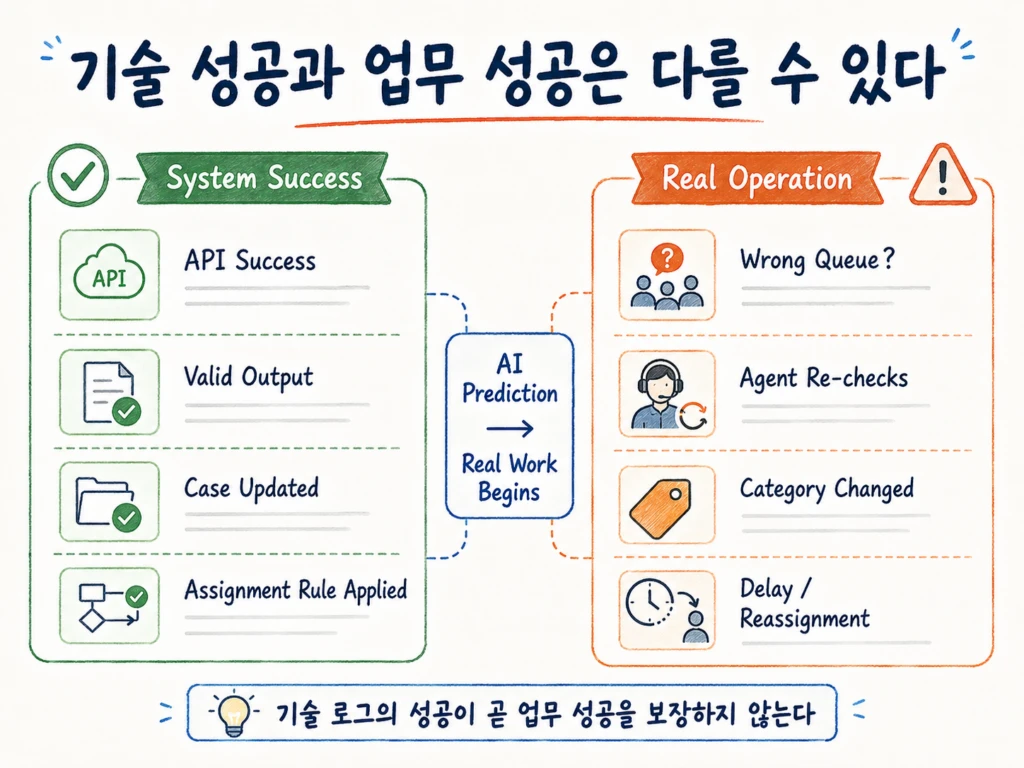
시스템 입장에서는 그전까지 아무런 문제가 없었다.
LLM API 호출은 성공했다. 응답 형식도 정상이고, Case의 Category도 정상적으로 업데이트됐다. Assignment Rule 역시 예상한 대로 실행됐다.
기술 로그만 보면 완벽하게 성공한 처리다.
하지만 실제 업무에서는 잘못된 담당 조직으로 Case가 전달됐다.
이 지점에서 질문이 달라졌다.
API 호출이 성공했는지가 아니라, AI의 판단이 실제 업무에서도 맞았는지는 어떻게 알 수 있을까?
그리고 이 질문을 하기 시작하자 단순해 보였던 자동 분류 문제의 범위가 조금 다르게 보이기 시작했다.
5. 이메일은 생각보다 훨씬 무규칙하다
조금 더 생각해보면 이메일이라는 Input 자체도 그렇게 얌전하지 않다.
고객이 처음에는 청구 문제로 이메일을 보낸다.
몇 분 뒤 다시 메일을 보내 장비에 문제가 있다고 이야기할 수도 있다.
그리고 다시 2분 뒤에는 이렇게 쓸 수도 있다.
“아, 장비 문제는 해결됐어요. 처음 청구 건만 확인해 주세요.”
기존 이메일 Thread에서 전혀 다른 문의를 시작하는 경우도 있다.
“이전 문제는 해결됐습니다. 그런데 이번에는 다른 제품이 작동하지 않습니다.”
상담원이 아직 첫 Case를 Pickup하기도 전에 고객이 짧은 간격으로 여러 통의 이메일을 연속해서 보내는 상황도 충분히 가능하다.
이런 장면을 생각하기 시작하면 처음에는 그럴듯해 보였던 또 다른 아이디어가 위험해진다.
“EmailMessage가 추가될 때마다 AI가 다시 읽고 최신 Category로 Case를 자동 변경하면 되지 않을까?”
실제 운영에서는 그렇게 간단하지 않다.
몇 분 사이에 Category가 여러 번 바뀌면 담당 Queue도 함께 움직일 수 있다.
누군가 이미 Case를 Pickup한 상태라면 오히려 업무를 더 혼란스럽게 만들 수도 있다.
AI가 매 순간 가장 최신의 Category를 맞히는 것과 상담 프로세스를 안정적으로 운영하는 것은 같은 문제가 아니다.
오히려 조금 늦게 반영되는 것이 Category가 계속 흔들리는 것보다 나을 수도 있다.
그렇다고 이런 모든 Edge Case를 첫 번째 Scope에서 해결하기 시작하면 프로젝트 자체가 달라진다.
고객은 그렇게 복잡한 시스템을 요청하지 않았다.
6. Scope를 늘리는 대신 관찰 범위를 넓혀보기로 했다
여기까지 생각하고 나서 내 판단은 의외로 단순했다.
구현 범위를 무작정 늘리지 말자.
최초 이메일을 기준으로 한 번 분류한다는 기존 Scope는 그대로 유지할 수 있다.
고객이 원한 것도 그 정도였다.
대신 한 가지는 추가로 보고 싶었다.
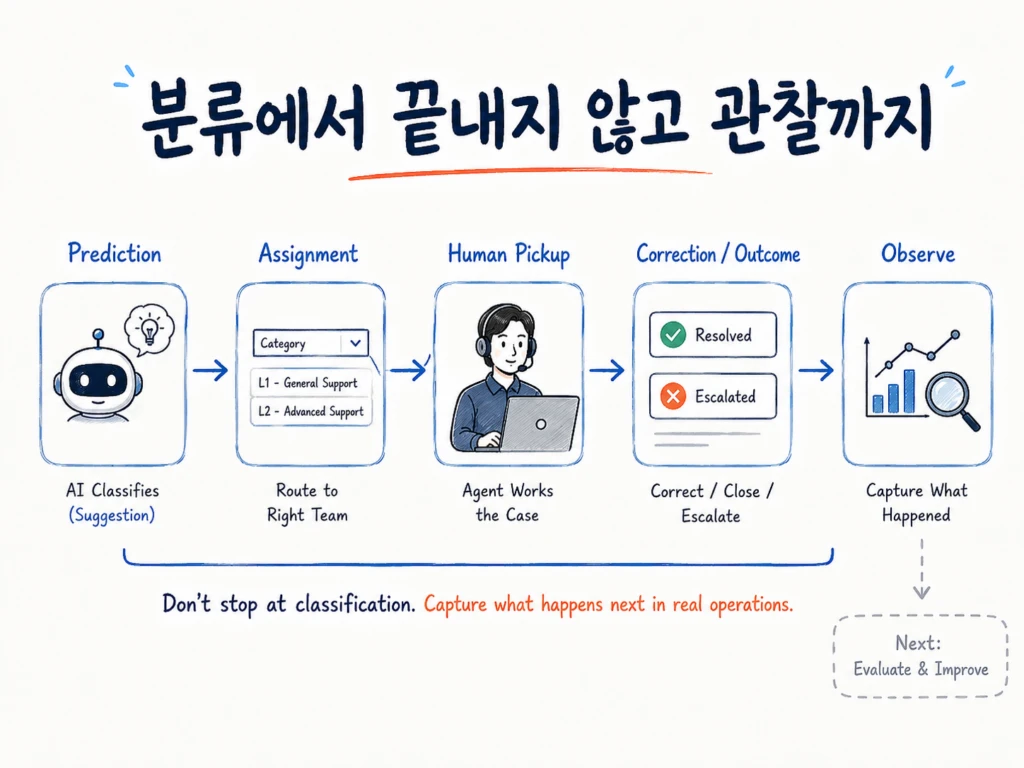
AI가 처음 내린 판단이 실제 업무 안에서 어떻게 소비되는가.
나는 이것을 구현 Scope를 확장한다기보다 관찰 범위를 넓히는 것에 가깝다고 생각했다.
예를 들어 최초 분류 시점에 최소한 다음 정도는 남길 수 있다.
- Case ID
- Predicted Level 1
- Predicted Level 2
- Confidence
- Model Version
- Prompt Version
- Prediction Timestamp
그리고 이후 Salesforce 안에서 이미 발생하는 업무 데이터와 연결해볼 수 있다.
- Assigned Queue
- First Pickup Time
- Category Changed 여부
- Changed From / To
- Changed By
- Changed At
- Final Category
- Resolved At
이렇게 보면 처음에는 단순했던 자동 분류가 조금 다른 형태로 보이기 시작한다.
Prediction에서 끝나는 것이 아니라, 그 판단 이후 실제 업무에서 무슨 일이 일어났는지를 연결해서 보는 것이다.
여기서 중요한 것은 LLM을 감시하는 것이 아니다.
AI의 판단이 실제 프로세스 안에서 어떤 결과를 만들었는지를 나중에 다시 볼 수 있게 만드는 것이다.
7. AI가 맞았는지는 분류 직후에는 알 수 없다
AI가 다음과 같은 결과를 반환했다고 해보자.
Level 1 = Technical Support
Level 2 = Device Failure
Confidence = 0.94
이 순간에 확실히 알 수 있는 것은 모델이 어떤 답을 냈고, 그 결과가 시스템에서 정상적으로 처리됐다는 사실 정도다.
그 답이 실제 업무에서도 맞았는지는 아직 알 수 없다.
Case가 적절한 Queue로 갔는지, 담당자가 그대로 처리했는지, 다른 Category로 다시 변경했는지, 결국 어떤 유형으로 종결됐는지는 그 이후에야 알 수 있다.
여기서 내가 생각하는 AI Observability는 일반적인 애플리케이션 모니터링과 조금 다르다.
물론 시스템을 운영하려면 이런 정보도 필요하다.
- HTTP Status
- Latency
- Token Usage
- Exception
- Model Response
하지만 이 정보만으로는 AI 기능이 실제 업무에서 잘 작동하고 있는지를 판단하기 어렵다.
오히려 이런 정보가 함께 보여야 한다.
- Predicted Category
- Assigned Queue
- First Pickup Time
- Human Recategorization
- Final Category
- Resolution
예를 들어 API 응답 시간은 700ms였고 오류도 하나도 없는데, AI가 분류한 Case의 상당수가 담당자에 의해 다시 Category가 변경되고 있다면 이 기능을 성공했다고 보기는 어렵다.
반대로 일부 예측이 완벽하지 않더라도 대부분의 Case가 올바른 담당 조직으로 빠르게 전달되고, 현업의 수동 분류 업무가 크게 줄었다면 실제 업무 관점에서는 충분한 가치를 만들고 있을 수도 있다.
서비스가 정상적으로 살아 있는지를 보는 것과, AI가 실제 업무에서 좋은 판단을 하고 있는지를 보는 것은 서로 다른 Observability 문제다.
그래서 AI 기능을 운영할 때는 모델 호출 자체뿐 아니라 그 판단의 업무상 결과까지 이어서 볼 수 있어야 한다고 생각한다.
8. 사람이 Category를 바꿨다고 AI가 틀렸다고 단정할 수도 없다
여기까지 생각하면 아주 매력적인 아이디어가 하나 생긴다.
AI가 처음 분류한 Category와 상담원이 나중에 선택한 Category를 비교하면 자동으로 정답 데이터를 만들 수 있지 않을까?
일부는 가능하다.
하지만 이것도 곧바로 Ground Truth라고 부르기는 어렵다.
예를 들어 AI가 다음과 같이 분류했다고 해보자.
AI Prediction
Technical Support / Device Failure
그런데 실제 상담원이 다음과 같이 변경했다.
Human Correction
Billing / Warranty Charge
정말 AI가 잘못 판단했을 수도 있다.
하지만 다른 가능성도 있다.
최초 이메일 자체가 애매했을 수도 있다.
AI가 분류한 이후 고객이 새로운 이메일에서 문의 목적을 바꿨을 수도 있다.
상담원이 실제 Category 정의와 다르게, 업무 편의상 특정 Queue로 보내기 위해 값을 변경했을 수도 있다.
더 근본적으로는 Level 1과 Level 2 Category의 정의 자체가 현업에서도 애매할 수 있다.
즉, Human Correction이 발생했다는 것은 중요한 Signal이지만 그 자체가 곧 Ground Truth는 아니다.
그래서 질문은 다시 바뀐다.
“AI가 틀렸나?”가 아니라, “사람은 왜 AI의 판단을 바꿨을까?”
이 질문을 할 수 있어야 실제 개선으로 이어질 수 있다.
9. 작은 자동화에서 예상하지 않았던 데이터가 보이기 시작했다
처음 고객이 원했던 것은 아주 분명했다.
한 명의 매니저가 모든 신규 Case를 읽고 Category를 정해야 하는 병목을 줄이는 것이었다.
그런데 AI의 최초 분류 결과와 이후의 업무 데이터를 함께 보기 시작하면, 처음에는 요구사항에 없었던 질문들이 생긴다.
특정 Category에서만 오분류가 많이 발생하는가?
두 Category 사이에서 사람과 AI가 반복적으로 같은 혼동을 보이는가?
분류는 맞는데 특정 Queue에서 First Pickup이 유난히 늦지는 않은가?
특정 담당 조직으로 갔다가 다른 조직으로 다시 전달되는 Case가 많은가?
그리고 조금 더 흥미로운 질문도 생긴다.
AI가 계속 A와 B를 헷갈리고, 사람도 계속 A와 B 사이에서 값을 바꾸고 있다면 정말 AI만의 문제일까?
Category Taxonomy 자체가 실제 업무를 제대로 반영하지 못하고 있을 수도 있다.
Category의 정의는 문서상으로는 구분되어 있지만, 실제 고객의 이메일에서는 그 경계가 모호할 수도 있다.
분류 결과 자체는 맞지만 Assignment Rule이나 실제 조직의 역할 구분이 업무와 어긋나 있을 수도 있다.
AI를 적용하려다 오히려 기존 프로세스의 불명확한 부분이 드러나는 것이다.
이 지점이 흥미로웠다.
처음에는 사람의 반복 작업 하나를 자동화하기 위해 시작했지만, 운영 데이터를 함께 보기 시작하면 AI 기능은 기존 업무를 관찰하는 새로운 지점이 될 수 있다.
작은 자동화가 단순히 몇 번의 클릭을 줄이는 것을 넘어, 현재 프로세스가 실제로 어떻게 움직이고 있는지를 보여주는 데이터를 만들기 시작하는 것이다.
10. Implementation은 작게, Thinking과 Observability는 넓게
이 사례에서 실제 첫 번째 구현은 여전히 단순할 수 있다.
최초 EmailMessage를 읽고 Level 1과 Level 2를 분류한 뒤, 기존 Salesforce Assignment Rule을 그대로 사용한다.
나는 오히려 그렇게 시작하는 편이 좋다고 생각한다.
Enterprise AX라고 해서 첫날부터 모든 Edge Case와 미래의 Workflow를 해결하는 거대한 시스템을 만들 필요는 없다.
특히 실제 기업 환경에서는 이미 구축된 시스템과 업무가 존재한다.
어떤 화면은 다른 조직이 관리하고 있고, 어떤 Automation은 오래전부터 운영되고 있으며, 이번 프로젝트에서 건드릴 수 없는 영역도 많다.
그래서 AX 컨설턴트에게 필요한 것은 AI 기술만이 아니다.
AI가 들어갈 기존 서비스를 빠르게 이해해야 한다.
현업이 그 시스템을 실제로 어떻게 사용하는지도 봐야 한다.
새로운 기능을 어디까지 넣어야 하는지뿐 아니라, 어디까지 넣지 않아야 하는지도 판단해야 한다.
그리고 작은 기능으로 시작하더라도 그 판단이 실제 업무에서 어떻게 소비되고 있는지는 볼 수 있어야 한다.
이번 사례를 생각하면서 내가 다시 확인한 것은 이것이었다.
Implementation Scope는 작게 시작해도 된다. 하지만 Thinking Scope와 Observability까지 작게 가져가서는 안 된다.
고객이 처음 원했던 것은 이메일 Category 자동 분류였다.
그 요구사항은 여전히 그대로다.
하지만 여기까지 생각하고 나니, 최초 분류가 잘 동작하는 것만으로는 끝나지 않는다는 사실이 보이기 시작했다.
실제 이메일 대화는 최초 문의의 Category를 그대로 유지하면서 끝나지 않는다.
같은 Email Thread 안에서 고객이 전혀 다른 문의를 시작할 수도 있고, 상담원이 Case를 Pickup하기 전에 짧은 간격으로 새로운 이메일을 계속 보낼 수도 있다. 이미 처리 중인 문의에서 고객의 관심사가 다른 문제로 넘어가는 경우도 있다.
그렇다면 다음 질문은 자연스럽게 이것이 된다.
같은 Email Thread 안에서 고객의 문의 목적이 바뀌었을 때, AI는 어디까지 판단하고 실제 Case의 상태 변경은 누가 결정해야 할까?
매 EmailMessage가 들어올 때마다 AI가 최신 Category로 Case를 바꾸게 하면 가장 빠르게 반응하는 시스템은 만들 수 있다.
하지만 그것이 반드시 좋은 상담 시스템을 의미하지는 않는다.
담당자가 이미 Case를 Pickup했을 수도 있고, 고객이 몇 분 뒤 다시 이전 문의로 돌아올 수도 있다. Category가 바뀔 때마다 Assignment와 담당 조직까지 움직인다면 AI의 빠른 판단이 오히려 업무를 흔들 수도 있다.
그래서 다음 글에서는 Email Thread와 Business Intent를 분리해서 보는 것부터 시작해, AI의 Category 변경 제안, 담당자의 Accept, 기존 Case와 처리 이력의 보존, Resolution Time, 담당 조직 변경과 고객 알림까지 실제 운영 상태를 어떻게 안전하게 전환할 것인지를 다뤄보려고 한다.
여기서도 내가 중요하게 보는 원칙은 같다.
Model Confidence가 높다는 것과 Business State를 변경할 권한이 있다는 것은 다른 문제다.
그리고 그 운영 구조까지 만들어지고 나면 마지막 질문이 남는다.
어떤 Category 변경이 실제 AI의 오분류였는지, 반복되는 Edge Case는 무엇인지, 사람이 수정한 데이터를 어디까지 신뢰할 수 있는지, 그리고 Prompt나 Taxonomy, Rule을 변경했을 때 정말 이전보다 나아졌는지를 어떻게 검증할 것인가.
이 문제는 세 번째 글에서 이어간다.
이번 시리즈는 결국 세 단계의 문제를 다루게 됐다.
- 무엇을 AI에게 맡길 것인가
- AI의 판단을 실제 업무 상태에 어떻게 안전하게 반영할 것인가
- 운영 결과를 이용해 그 판단을 어떻게 지속적으로 개선할 것인가
처음에는 이메일 두 개의 Category를 자동으로 채우는 작은 요구사항이었다.
하지만 실제 Enterprise AX에서는 작은 자동화 하나도 결국 기존 시스템, 사람의 업무, 상태 전환, 그리고 운영 이후의 학습 구조까지 연결해서 봐야 한다.
내가 생각하는 AX 컨설팅의 깊이는 아마 이런 지점에서 생긴다.