JEV와 GPT-6 Luna가 17/17 같은 답을 냈다. 그런데 설계는 왜 달랐을까?
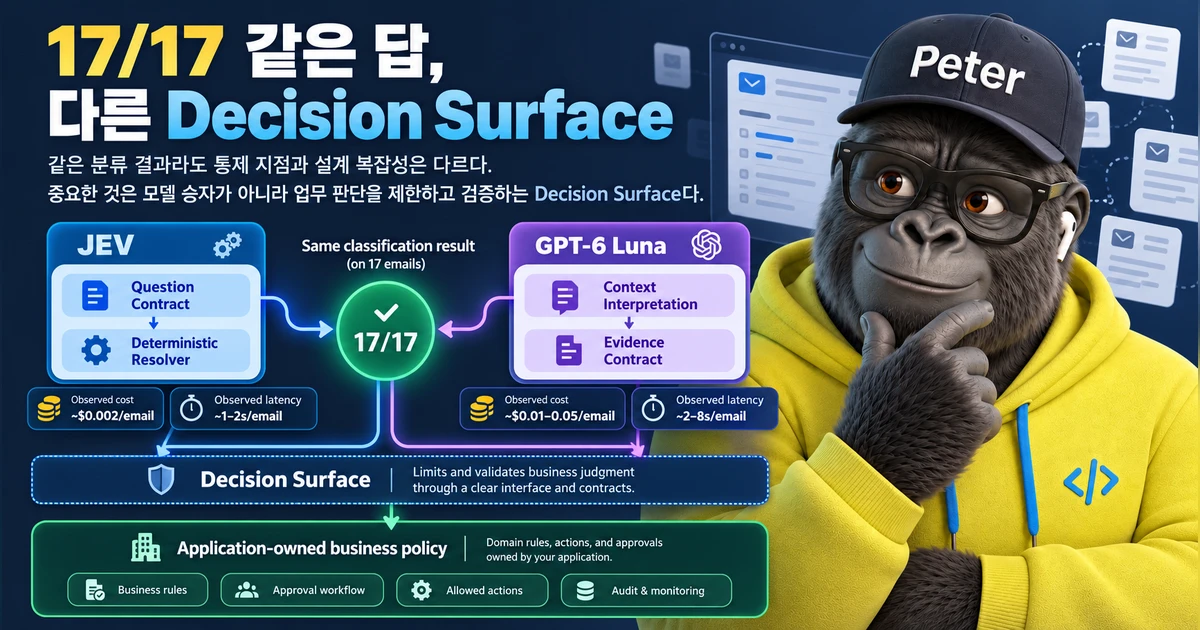
같은 17개 Email-to-Case를 JEV와 GPT-6 Luna로 분류했더니 결과는 모두 같았습니다. 실제 비용·latency·ground truth 사례를 바탕으로 두 방식의 설계 차이와 OpenAI Decisions API가 흥미로운 이유를 정리합니다.

같은 17개 Email-to-Case를 JEV와 GPT-6 Luna로 분류했더니 결과는 모두 같았습니다. 실제 비용·latency·ground truth 사례를 바탕으로 두 방식의 설계 차이와 OpenAI Decisions API가 흥미로운 이유를 정리합니다.
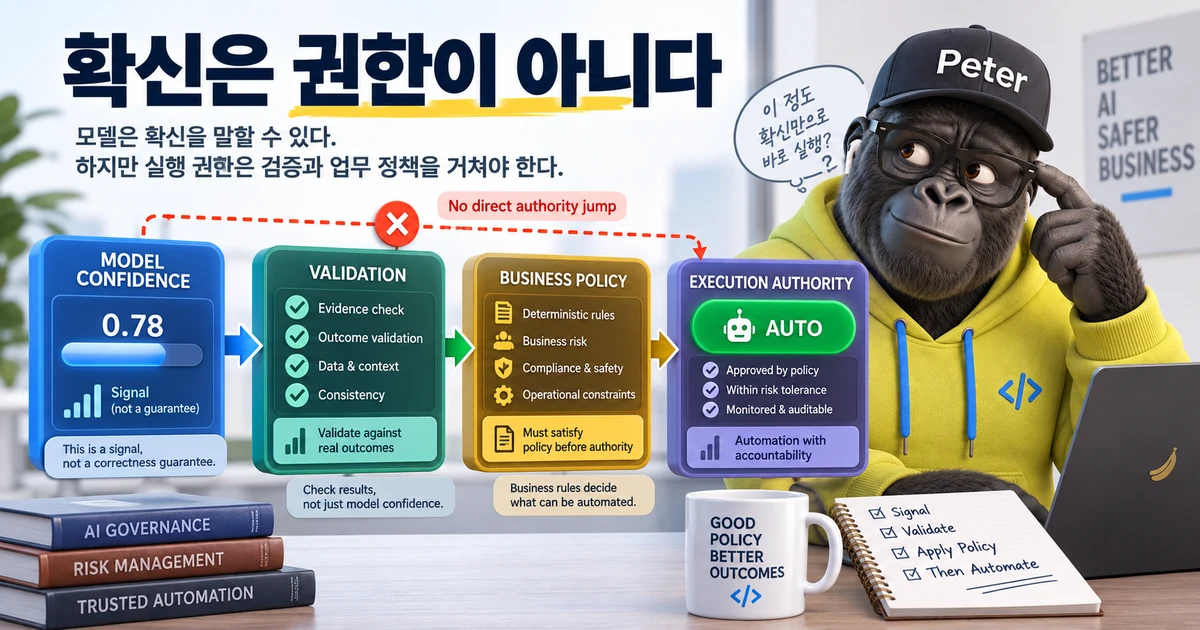
AI 분류 모델의 confidence를 곧바로 자동화 기준으로 써도 될까? JEV 이메일 분류 PoC 경험을 바탕으로 calibration, risk-coverage, AUTO·VERIFY·REVIEW 정책과 Human-in-the-loop를 실무 관점에서 설명합니다.
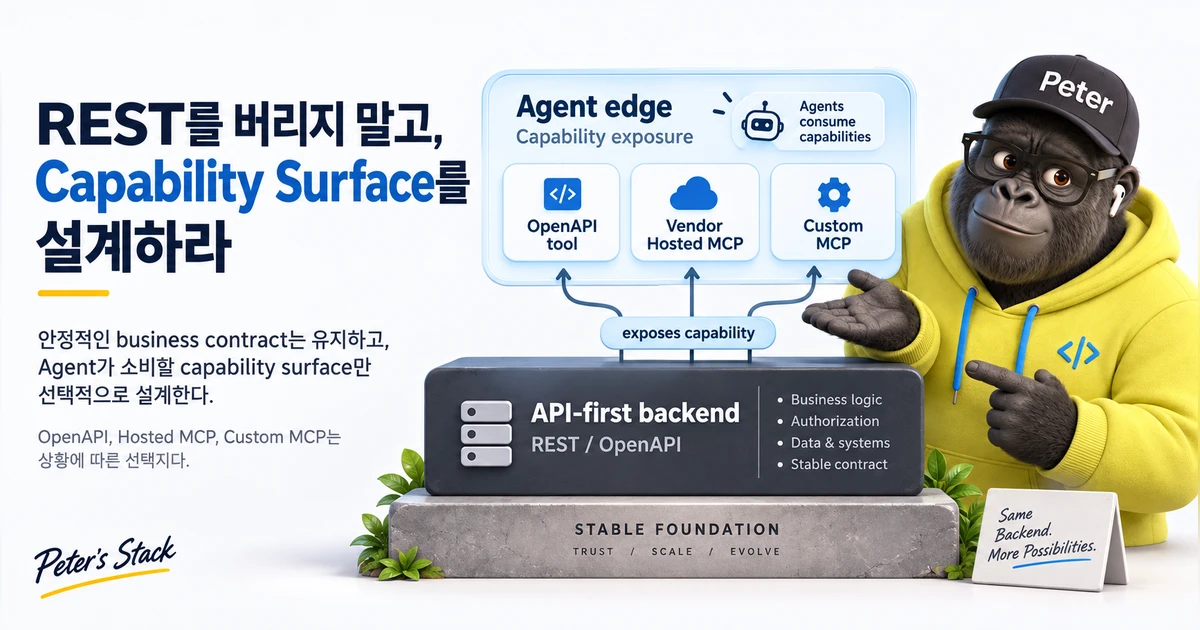
MCP가 확산된다고 기존 REST API를 모두 다시 만들 필요는 없다. OpenAPI, Hosted MCP, Custom MCP를 어떤 기준으로 조합할지 Enterprise Agent의 capability exposure 관점에서 정리한다.
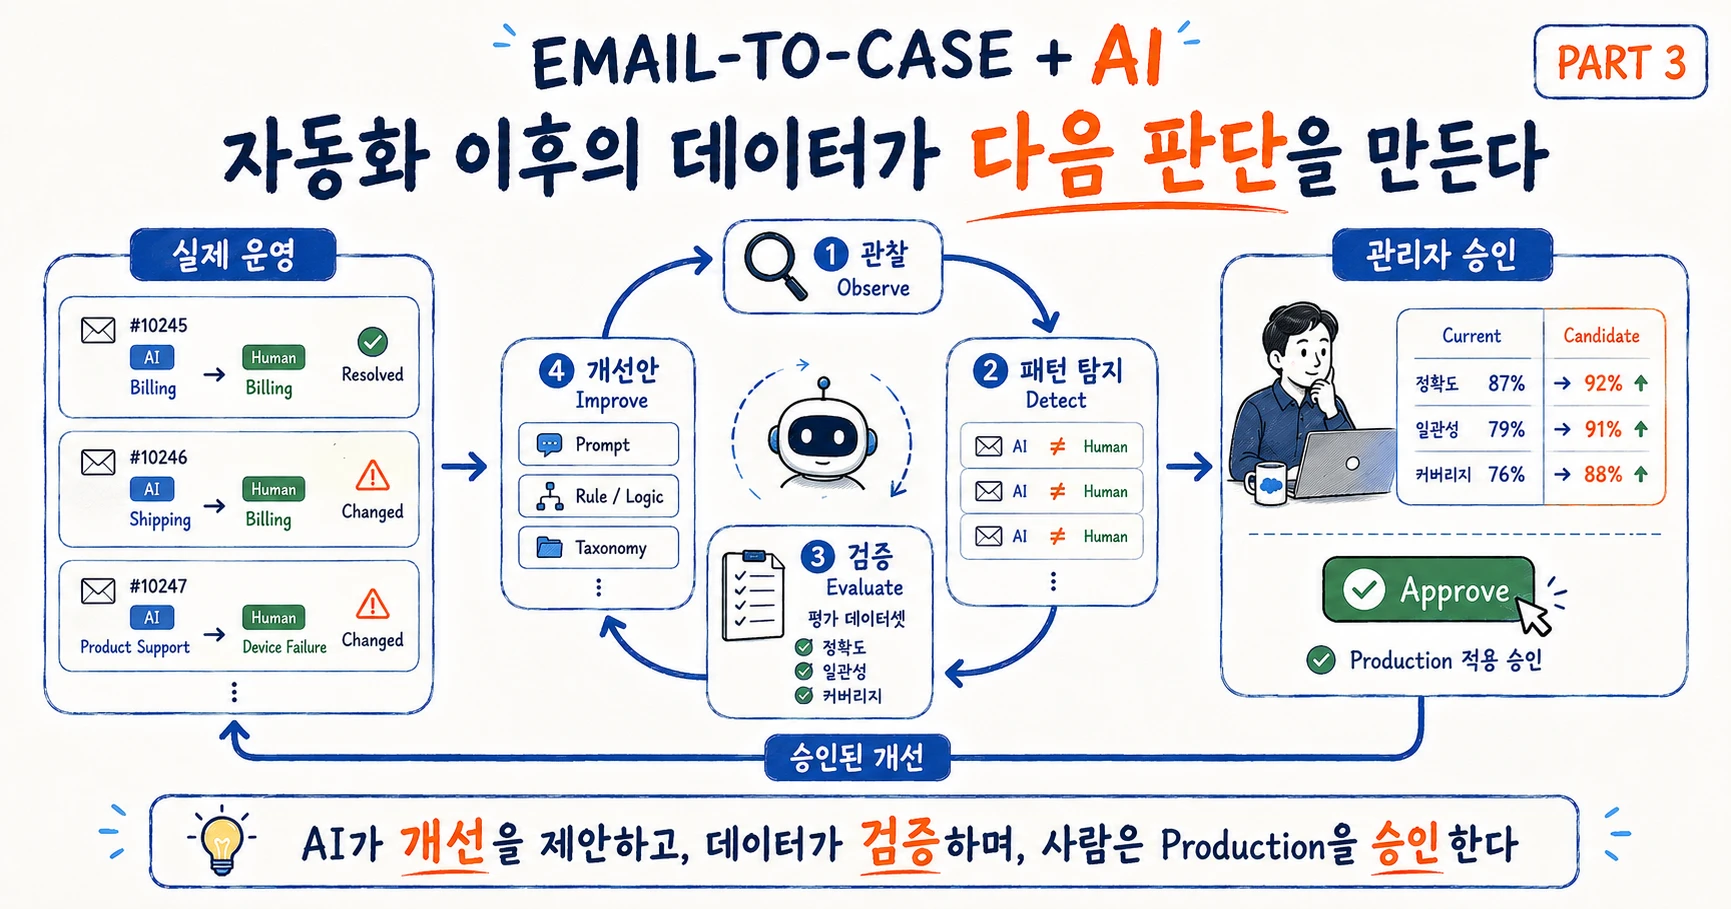
지난 두 글에서는 하나의 작은 요구사항을 계속 따라가봤다. 처음 고객이 원했던 것은 Salesforce Email-to-Case로 생성되는 Case의 Level 1과 Level 2 Category를 AI가 자동으로 판단하는 것이었다. 첫 번째 글에서는 무엇을 AI에게 맡길 것인지 고민했다. 두 번째 글에서는 AI가 고객의 문의 의미를 판단하더라도 실제 Case의 Category, 담당 조직, 업무 이력 같은 상태 변화까지 바로 맡길 필요는 없다고 … 더 읽기
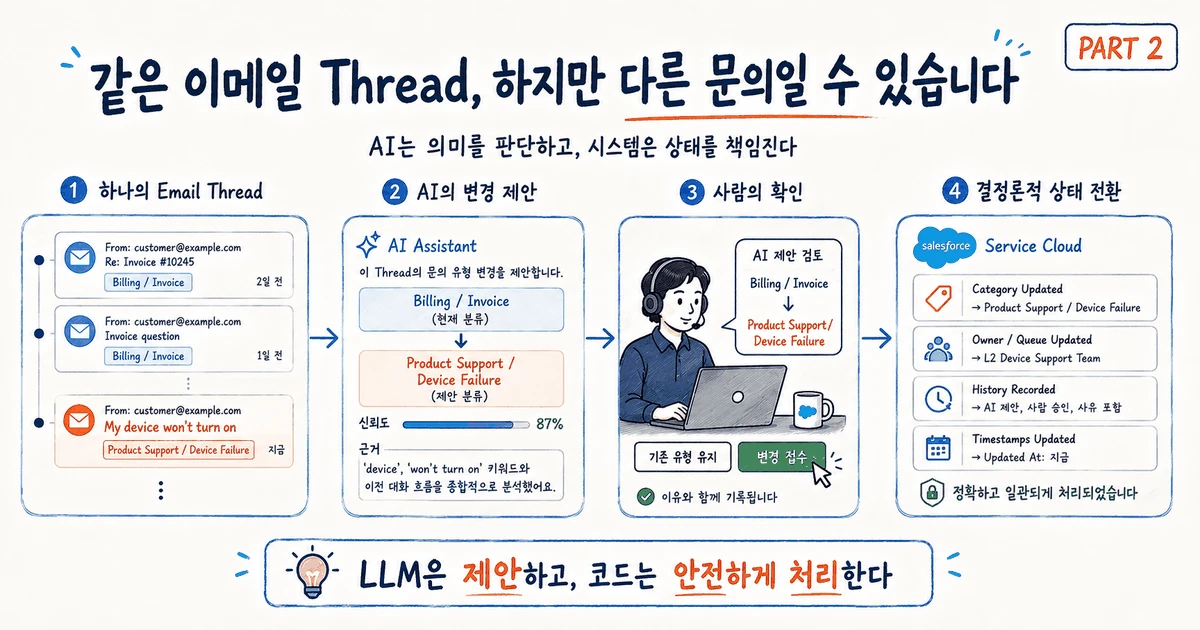
지난 글에서는 고객의 요구사항을 최대한 단순하게 유지했다. 최초 이메일이 Salesforce Email-to-Case를 통해 Case로 생성되면 AI가 내용을 읽고 Level 1과 Level 2 Category를 판단한다. Category가 정해진 이후의 Assignment는 이미 존재하는 Salesforce의 규칙에 맡긴다. 여기까지만 보면 꽤 깔끔하다. 그런데 실제 상담 업무를 생각하기 시작하면 문제는 최초 분류 이후부터 생긴다. 처음에는 Billing 문의였던 고객이 같은 이메일 Thread에서 이렇게 … 더 읽기
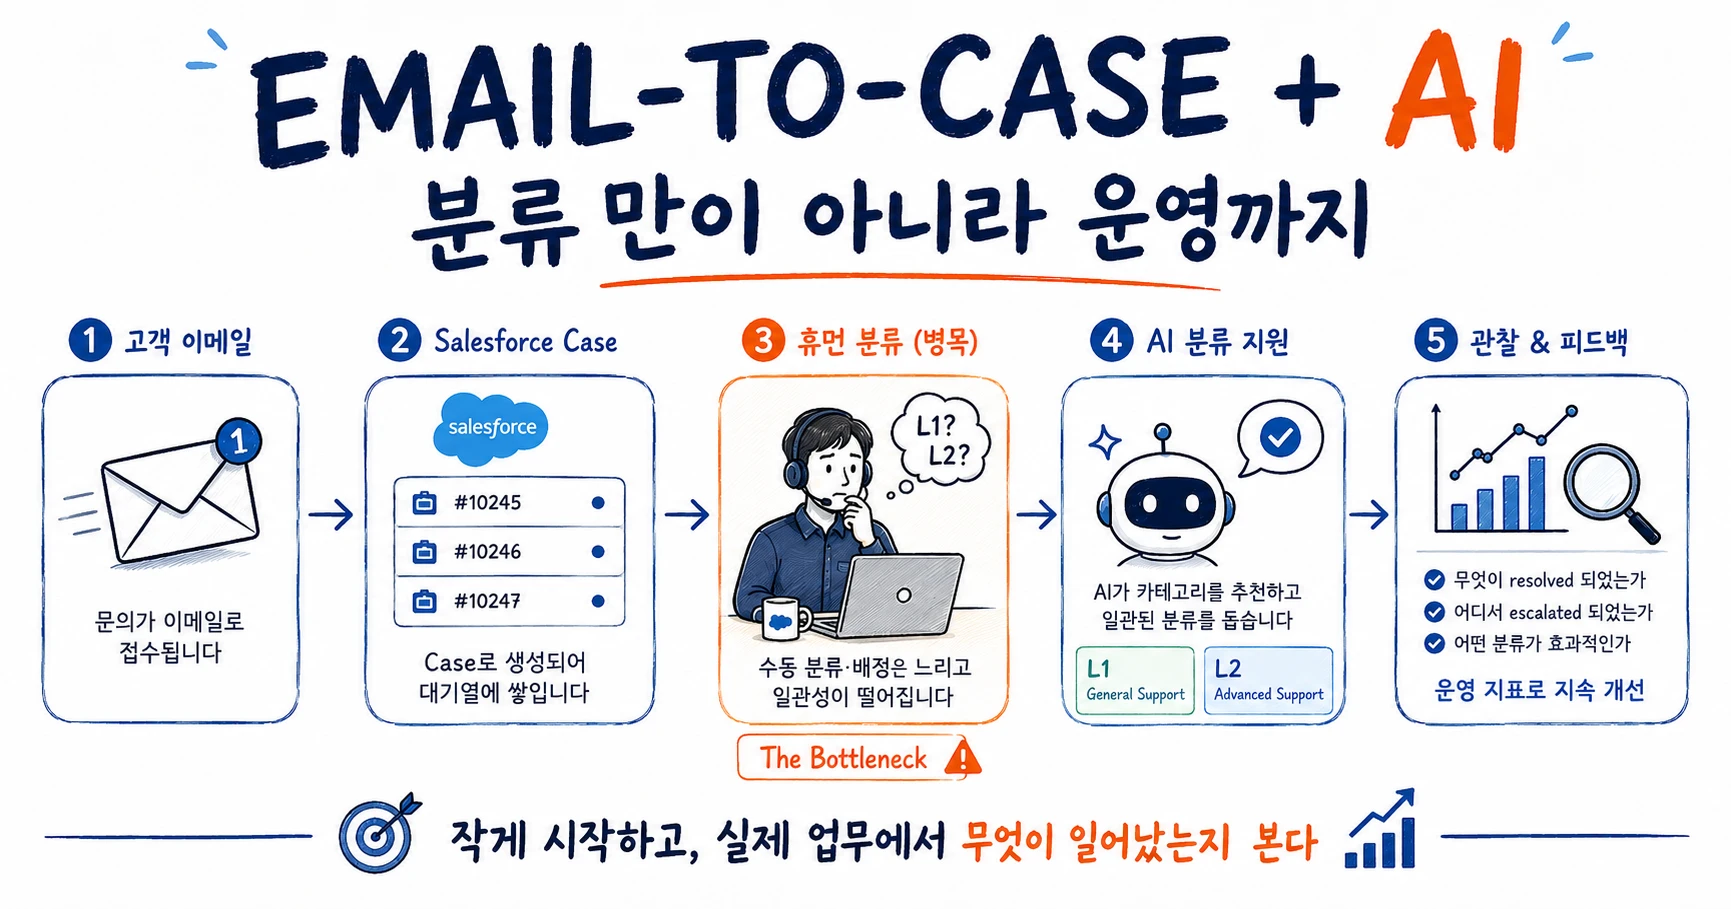
Salesforce Email-to-Case의 단순한 L1/L2 자동 분류 요구에서 시작해, 기존 시스템 이해와 실제 상담 업무, AI Observability까지 생각이 확장된 과정을 정리한다.