
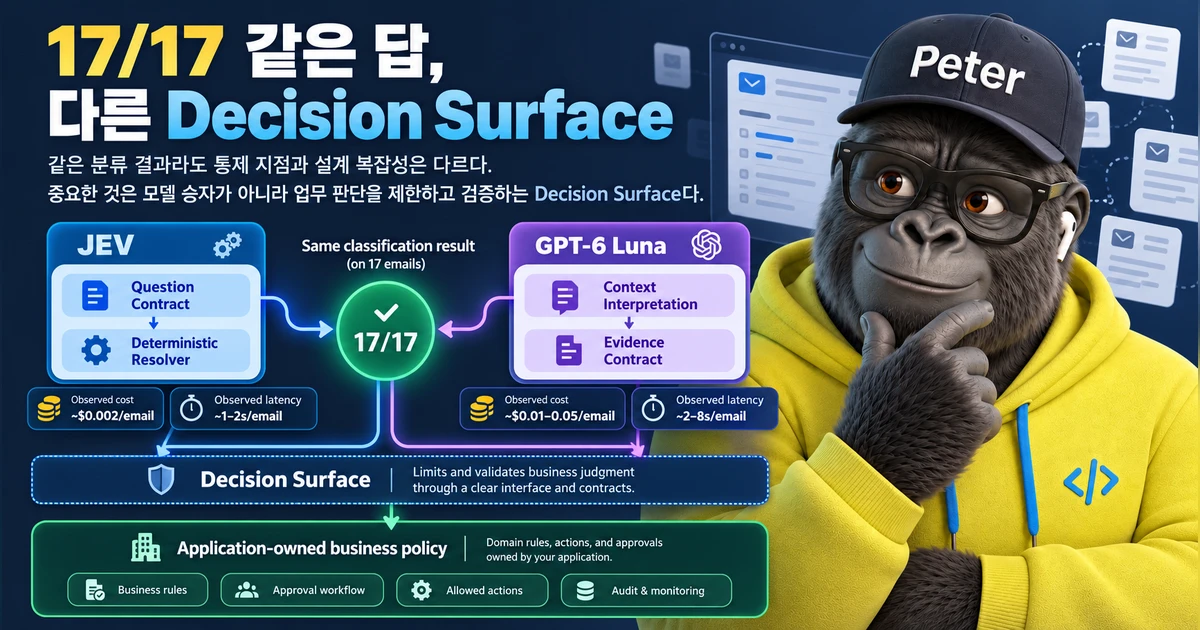
같은 17개 이메일을 두 개의 전혀 다른 방식으로 분류해봤다.
하나는 TypeSafe AI의 JEV였다. 정해진 질문과 유한한 답, probability와 score를 중심으로 움직이는 decision model이다. 다른 하나는 GPT-6 Luna였다. 이메일 thread 전체를 읽고 structured output으로 현재 요청과 분류 근거를 함께 내도록 했다.
결과부터 보면 조금 싱거웠다.
17건 모두 두 engine의 최종 classification이 같았다.
처음에는 “그러면 더 싸고 빠른 쪽을 쓰면 되는 것 아닌가?”라는 생각이 들었다. 그런데 실제 workflow를 다시 들여다보니 오히려 반대였다. 같은 답에 도달했다는 사실이 두 시스템을 더 비슷하게 보이게 한 것이 아니라, 같은 답을 만들기 위해 서로 어디에 설계 복잡성을 요구하는지를 더 선명하게 보여줬다.
이번 글은 JEV와 GPT-6 Luna의 승자를 고르는 benchmark가 아니다. 내가 Salesforce Email-to-Case 분류를 두 방식으로 직접 구현하면서 보게 된 Decision Layer의 설계 차이에 관한 기록이다.
17/17이 같았는데, 숫자부터 다시 읽게 됐다
비교에는 기존 Email-to-Case PoC의 17개 이메일을 그대로 사용했다.
JEV는 jev-1.13.0, general LLM은 gpt-6-luna에 reasoning medium을 사용했다. 동일한 business taxonomy를 기준으로 결과를 비교했다.
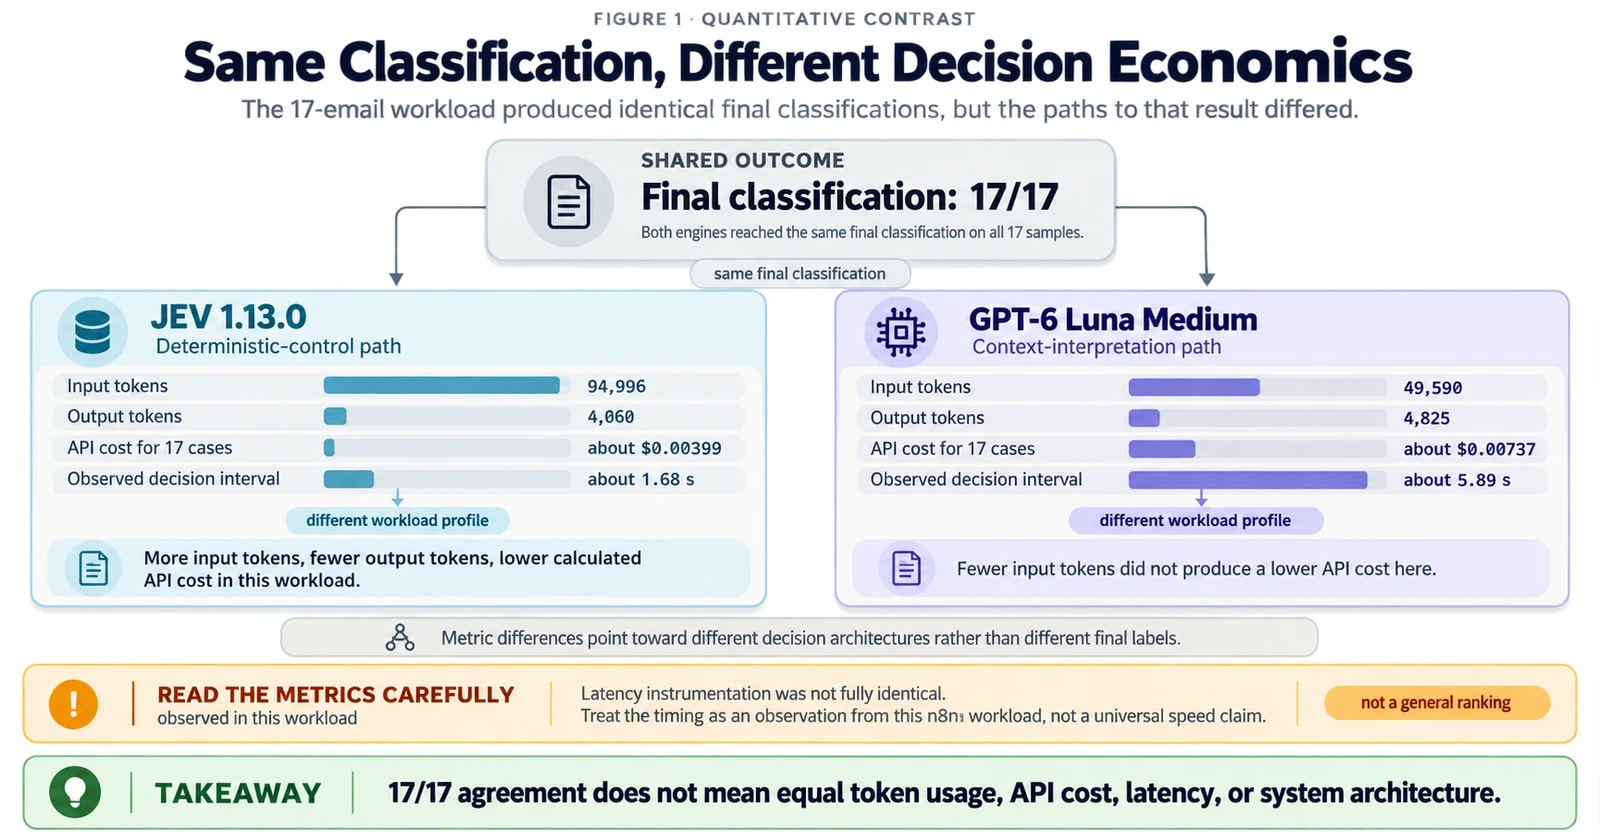
| 관찰 항목 | JEV 1.13.0 | GPT-6 Luna Medium |
|---|---|---|
| 두 engine의 최종 분류 일치 | 17/17 | 17/17 |
| 기존 expected label과 일치 | 15/17 | 15/17 |
| Input tokens | 94,996 | 49,590 |
| Output tokens | 4,060 | 4,825 |
| 현재 공개 단가로 계산한 17건 API cost | 약 \$0.00399 | 약 \$0.00737 |
| 이번 workload에서 관찰한 비교 가능한 decision 구간 | 약 1.68초 | 약 5.89초 |
비용은 2026년 10월 1일 다시 확인한 공개 단가를 적용했다. TypeSafe AI는 Jev input을 100만 token당 \$0.042, output은 별도 과금하지 않는다고 공개하고 있다. OpenAI의 GPT-6 Luna Standard short-context 가격은 input \$0.10, output \$0.50 per 1M tokens다. 따라서 이번 17건에서는 GPT-6 Luna가 훨씬 적은 input token을 사용했지만 최종 API cost는 JEV의 약 1.85배였다. TypeSafe AI의 Jev 소개와 OpenAI GPT-6 Luna 모델 문서를 기준으로 계산했다.
Latency는 더 조심해서 봐야 한다. 두 실험의 instrumentation이 완전히 같지는 않았다. 그래서 “JEV가 일반적으로 3.5배 빠르다”고 말할 수는 없다. 정확한 표현은 이번 n8n workload에서 비교 가능한 decision 구간이 약 1.68초 대 5.89초로 관찰됐다는 정도다.
그런데 내게 더 흥미로웠던 숫자는 17/17이 아니라 15/17이었다.
둘 다 같은 두 건에서 틀렸다면, 정말 모델이 틀린 걸까
기존 expected label 기준으로 JEV와 GPT-6 Luna는 모두 15건을 맞혔다. S005와 S013 두 건이 FAIL이었다.
처음에는 단순했다.
15 / 17.
하지만 두 이메일을 다시 읽어보니 이 숫자 자체가 흔들렸다.
S005 — “온라인 기술지원”이라고 부르기에는 이미 너무 멀리 왔다
S005의 기존 label은 POST_SALES_SUPPORT__TECHNICAL_SUPPORT_ONLINE이었다.
그런데 thread는 이미 긴 시간 동안 여러 번의 조치가 진행된 상태였다. 제조사 기술팀과 현장 방문도 했고, 권고받은 작업도 수행했다. 효과가 없었다. 이전 메시지에서는 실내기 교체를 명시적으로 요청했고, 최신 메시지는 다시 방문해서 진단해달라는 요청이 아니라 “이제 적절한 해결책을 달라”는 escalation이었다.
JEV는 REPAIR_RMA 0.91, 두 번째 ON_SITE_TECHNICAL_SUPPORT 0.29로 판단했다. GPT-6 Luna도 primary를 REPAIR_REQUEST로 두었다.
두 engine이 서로 독립적으로 같은 결론에 도달했다.
이 경우 기존 label을 기준으로 둘 다 오답이라고 세는 것이 맞을까?
내가 다시 읽었을 때는 오히려 기존 human label이 thread의 누적 상태를 충분히 반영하지 못했을 가능성이 더 커 보였다.
S013 — “수리”라는 명사보다 지금 요구하는 행동을 읽는다
S013은 반대 방향의 경계 사례였다.
기존 label은 REPAIR_REQUEST였다. 하지만 고객의 문장은 매우 구체적이었다.
제조사에서 고장 대응 기술자를 보내달라고 요청했다. 비용을 지불할 의사도 밝혔다.
JEV는 ON_SITE_TECHNICAL_SUPPORT 0.97, REPAIR_RMA 0.87로 판단했다. margin은 0.10에 불과했다. GPT-6 Luna도 primary를 TECHNICAL_SUPPORT_ON_SITE_VISIT, secondary를 REPAIR_REQUEST로 잡았다.
일상적인 표현으로는 “수리 요청”이라고 부를 수도 있다. 하지만 우리가 앞선 PoC에서 정한 taxonomy boundary를 엄격하게 적용하면 현재 recipient에게 요청하는 행동은 technician visit이다. Repair는 방문 뒤 나올 수 있는 outcome이다.
이 사례에서 낮은 JEV margin도 의미가 있었다. 모델은 정답을 확신하는 척하지 않고 On-site와 Repair 경계가 가깝다는 신호를 남겼다.
여기서 내가 다시 배운 것은 모델보다 evaluation 쪽이었다.
Model prediction과 human label이 다르다는 사실만으로 model error라고 부를 수 없다. Ground truth도 business decision policy에 대해 검증되어야 한다.
Enterprise 프로젝트에서 validation set은 단순한 정답지라기보다 업무 정책을 압축한 artifact에 가깝다. Taxonomy 경계를 바꾸면 label도 바뀔 수 있다. 사람이 붙였다는 이유만으로 자동으로 canonical truth가 되는 것은 아니다.
JEV에서는 Prompt보다 Question Graph를 만들었다
앞선 글에서 JEV를 구현하며 가장 많은 시간을 쓴 곳은 API 연결이 아니었다.
질문을 설계하는 일이었다.
L1에서는 이메일을 Engineering, Sales, Post Sales, Training, Other 같은 큰 업무 domain으로 좁혔다. L2에서는 선택된 domain 안에서 category별로 작은 yes/no decision을 독립적으로 물었다.
형태를 단순화하면 이런 구조였다.
Email Thread → L1 finite choice → Domain-specific L2 questions → probability / score → deterministic resolver → business category
중요했던 것은 “좋은 prompt 한 장”이 아니었다.
Spare Parts라면 어떤 요청이 들어와야 true인지, Repair라면 무엇이 포함되고 무엇은 제외되는지, On-site Support는 언제 선택하고 언제 선택하면 안 되는지를 작은 decision contract로 쪼갰다.
JEV의 경우 설계 복잡성이 이쪽으로 이동했다.
- 질문을 얼마나 작게 쪼갤 것인가
- category마다 true / false boundary를 어떻게 적을 것인가
- L1과 L2를 어떻게 나눌 것인가
- score가 비슷할 때 어떤 signal을 남길 것인가
- 동점이나 unexpected response를 code가 어떻게 처리할 것인가
- 어디서부터 deterministic resolver가 final category를 소유할 것인가
결국 intelligence를 어디에 둘 것인가보다 intelligence에 어떤 질문만 허용할 것인가가 더 중요했다.
이 구조는 꽤 Enterprise 친화적이었다. Business Analyst와 개발자가 같은 질문을 읽고 category boundary를 리뷰할 수 있었다. 분류가 이상하면 “모델이 왜 이러지?”라고 시작하지 않고, 먼저 해당 question contract를 열어볼 수 있었다.
그 대신 대가도 명확했다.
Hierarchy가 잘못 좁혀지면 정답 L2가 아예 candidate set에서 사라진다. Taxonomy가 자주 바뀌면 question graph도 같이 관리해야 한다. 긴 예외 맥락을 자유롭게 해석하는 문제까지 모두 작은 질문으로 쪼개려 하면 오히려 복잡해질 수 있다.
GPT-6 Luna에서는 복잡성이 다른 곳으로 갔다
General LLM 버전을 만들 때 JEV request를 거대한 prompt 하나로 옮기지는 않았다.
대신 한 번의 structured inference에서 다음을 함께 받도록 했다.
primary classification / secondary classification / decision strength / thread resolution / boundary code / current request / decision basis
JEV에서 질문이 application asset이었다면, LLM 쪽에서는 context를 어떻게 읽었는지 드러내는 evidence contract가 더 중요해졌다.
예를 들어 S013에서는 단순히 ON_SITE라는 label만 받는 것보다 다음 정보가 함께 있는 편이 훨씬 유용했다.
- primary: On-site Visit
- secondary: Repair Request
- boundary: ON_SITE_VS_REPAIR
- current request: technician visit
- basis: repair outcome이 아니라 방문 자체가 현재 요청
이 구조는 긴 email thread나 복수 의도가 섞인 사례에서 강점이 있었다. 최신 메시지만 읽어서는 이해하기 어려운 follow-up을 전체 history와 연결하기도 쉬웠다.
하지만 “structured output을 받았다”는 사실만으로 production classifier가 완성되는 것은 아니었다.
Application은 여전히 다음을 소유해야 했다.
- 허용 가능한 taxonomy
- schema validation
- 잘못된 category rejection
- primary / secondary consistency
- boundary별 policy
- REVIEW 여부
- 실제 Salesforce field mutation authority
즉 LLM에서는 Prompt Engineering이 끝나는 곳에서 Evidence Contract와 deterministic validation engineering이 시작됐다.
같은 답이라고 같은 시스템은 아니다
두 구현을 나란히 놓고 보니 처음의 “누가 더 좋은 모델인가?”라는 질문이 별로 중요하지 않게 느껴졌다.
이번 17건에서는 결과가 같았다.
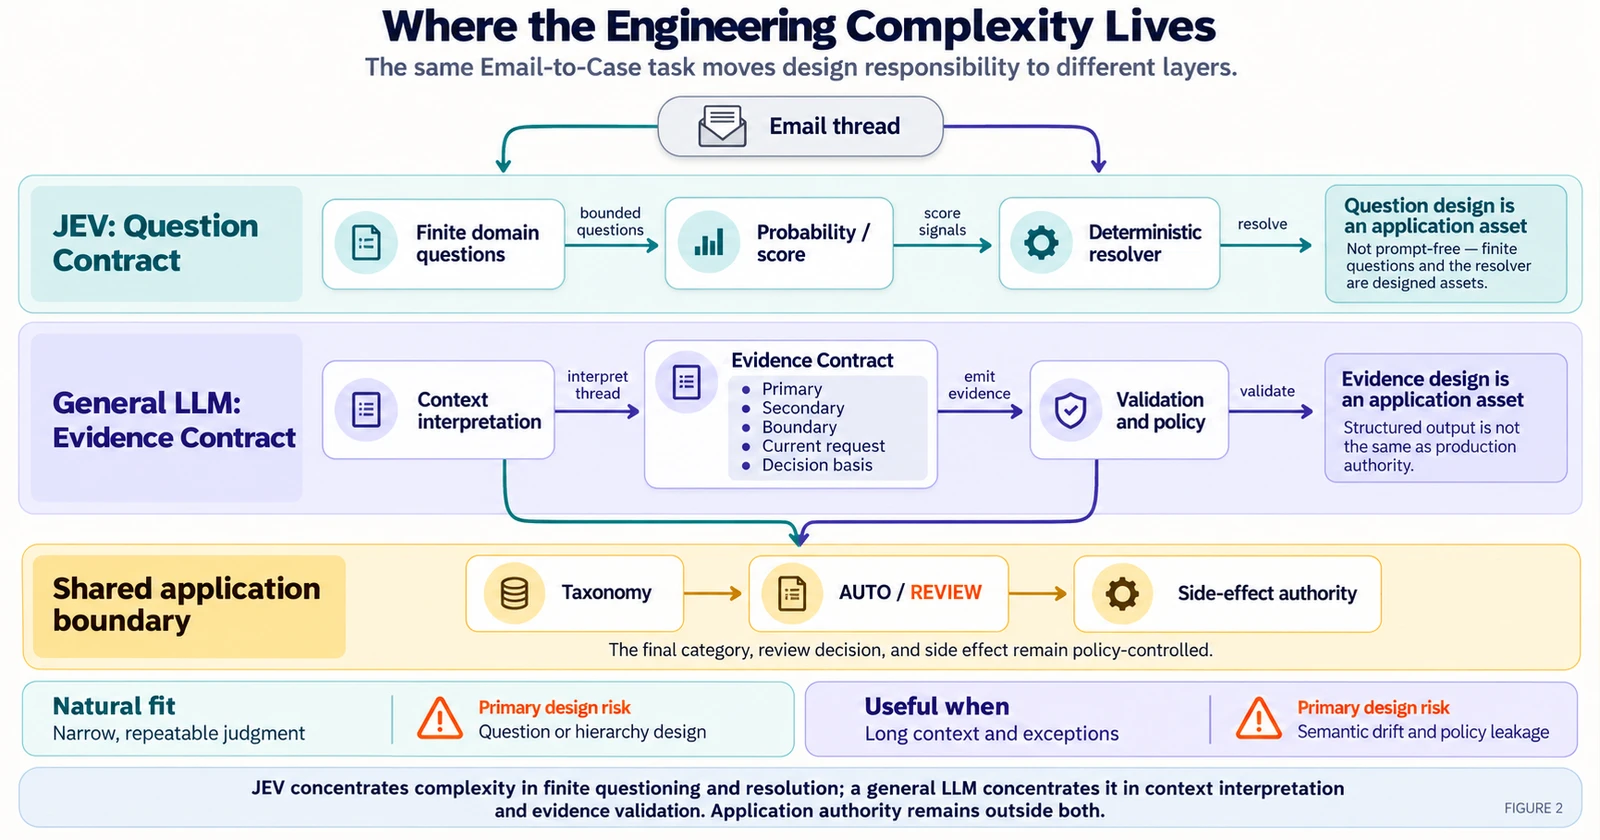
그런데 같은 결과를 만들기 위한 control surface가 달랐다.
| JEV | General LLM | |
|---|---|---|
| 핵심 설계 자산 | Question Contract | Context + Evidence Contract |
| 출력 | finite typed decision / probability | structured semantic interpretation |
| 강한 지점 | 좁고 반복적인 bounded judgment | 긴 맥락, 예외, 복수 의도 해석 |
| 주요 위험 | 잘못 설계된 question/hierarchy | semantic drift와 policy leakage |
| Application에 남는 것 | resolver / threshold / authority | validation / policy / authority |
그래서 “JEV냐 LLM이냐”라고 묻기 전에 workload를 먼저 봐야 한다.
Category가 유한하고 안정적이며, 같은 판단을 대량으로 반복하고, 질문을 작은 decision으로 분해할 수 있다면 JEV 같은 specialized decision model이 매우 자연스럽다.
반대로 taxonomy만으로 설명하기 어려운 긴 context, 예외적인 thread 전환, 모호한 복수 의도까지 한 번에 해석해야 한다면 general LLM이 훨씬 편할 수 있다.
둘은 서로를 완전히 대체하는 관계라기보다 서로 다른 곳에 비용을 지불하는 설계에 가까웠다.
Token이 적다고 항상 더 싸지는 않았다
이번 비교에서 개인적으로 재미있었던 부분 중 하나는 token과 cost였다.
GPT-6 Luna는 JEV보다 input token을 거의 절반만 사용했다.
그런데 현재 공개 단가를 적용하면 비용은 오히려 더 높았다.
이건 이상한 결과가 아니다. Token 수와 token 단가가 다른 축이기 때문이다.
JEV 쪽에서는 L1과 여러 L2 question 때문에 입력이 반복된다. 그래서 총 input token은 커졌다. 반면 TypeSafe가 공개한 Jev input 가격은 100만 token당 \$0.042이고 output은 별도 과금하지 않는다.
GPT-6 Luna는 한 번의 richer structured inference로 더 많은 판단을 모아서 처리해 input token은 줄였다. 하지만 Standard 가격이 input \$0.10, output \$0.50 per 1M tokens다.
그래서 이번 17건에서는 JEV 약 \$0.00399, GPT-6 Luna 약 \$0.00737가 됐다.
이 숫자를 확대해서 “JEV가 항상 절반 가격”이라고 말할 생각은 없다. Prompt 길이, category 수, cache, batch/flex 사용 여부, reasoning 설정, 질문 decomposition에 따라 economics는 얼마든지 달라질 수 있다.
오히려 내가 가져간 교훈은 이것이다.
Decision workload의 비용은 모델 가격표만 보면 안 된다. 전체 decision graph가 어떤 모양인지 봐야 한다.
실제 운영이라면 둘 중 하나만 고르지 않을 것 같다
17건 테스트만으로 production architecture를 정할 수는 없다.
그래도 이번 경험을 바탕으로 실제 프로젝트를 다시 설계한다면 나는 “모든 이메일을 한 모델에 넣는다”보다 hybrid 쪽부터 검토할 가능성이 높다.
Email → bounded / repeatable decision → known and calibrated case는 deterministic routing → ambiguous / exceptional case는 richer semantic interpretation → verify / review.
예를 들어 대부분이 안정적인 routine category라면 저비용 bounded decision engine으로 처리한다. Known confusion pair, low-margin case, 복잡한 thread transition 같은 일부만 general LLM이나 human review로 넘길 수 있다.
여기서 중요한 것은 “JEV를 1차 모델로 써야 한다”는 특정 제품 조합이 아니다.
구조적인 원칙은 더 일반적이다.
싸고 좁은 판단과 비싸고 넓은 해석을 같은 비용으로 취급하지 않는다.
Enterprise AI에서 모든 case를 가장 강한 모델에 보내는 것은 구현은 단순할 수 있지만, 반복 workload에서는 cost와 latency뿐 아니라 failure surface도 같이 커질 수 있다.
반대로 모든 예외를 finite taxonomy 안에 억지로 밀어 넣는 것도 좋지 않다.
어떤 case가 routine인지, 어떤 case가 escalation인지 application이 구분할 수 있어야 한다.
그러다 OpenAI가 Decisions API를 발표했다
이 실험을 정리하던 시점에 OpenAI DevDay 2026에서 Decisions API가 발표됐다.
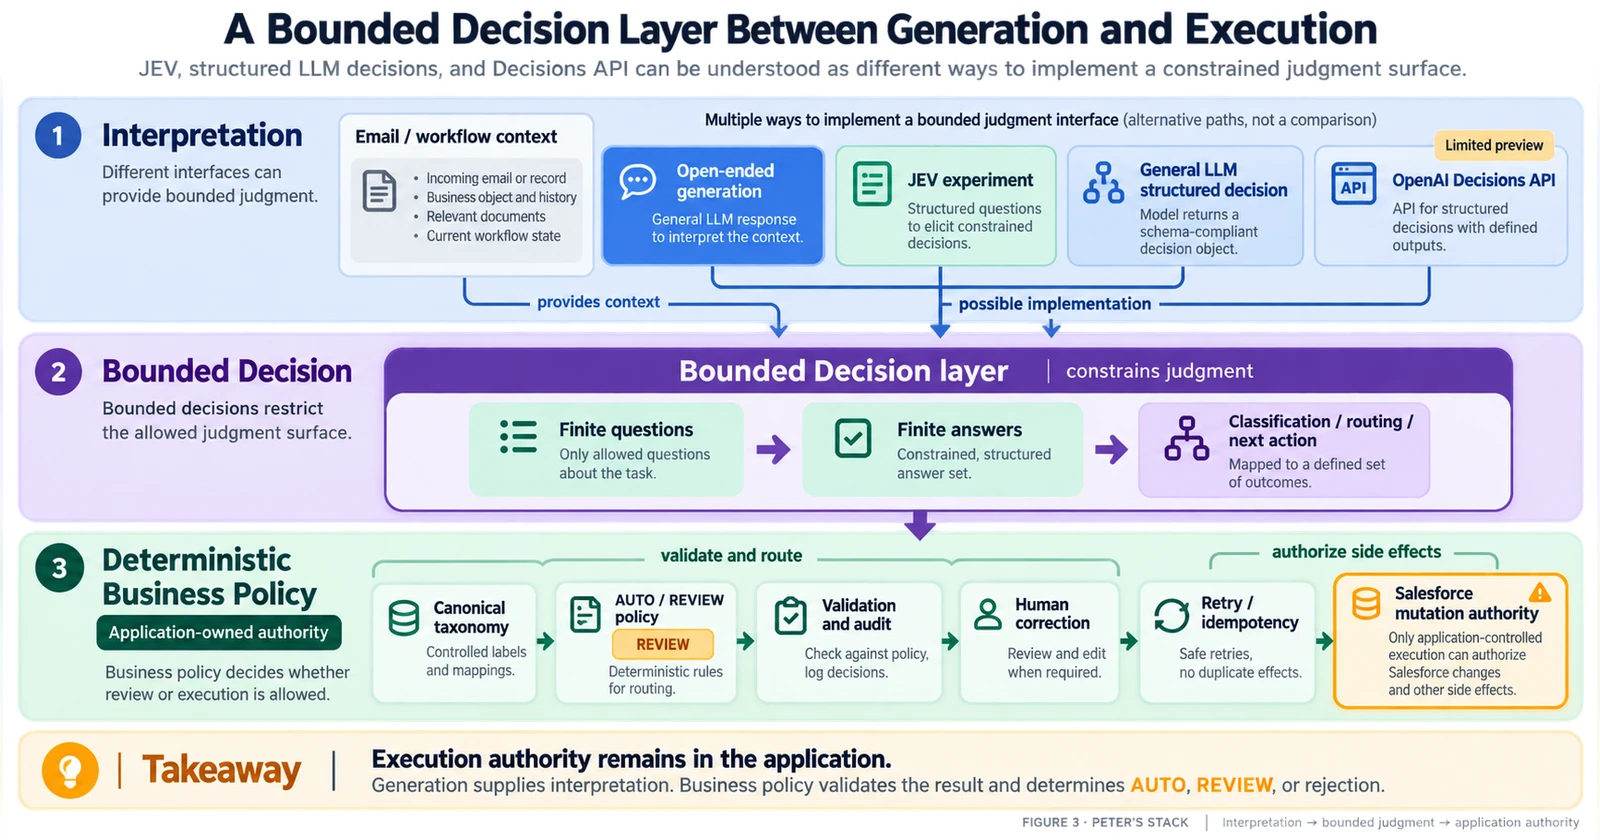
OpenAI의 공식 DevDay 2026 recap은 Decisions API를 Luna의 intelligence를 사용자가 정의한 특정 질문 집합과 미리 정해진 유한한 답에 집중시키는 방식으로 설명한다. 개발자는 text나 image context를 제공하고, 결과를 content classification, request routing, agent의 next action 선택 등에 사용할 수 있다고 소개했다.
발표일인 2026년 9월 29일 기준으로는 limited preview였고, OpenAI는 수일 내 더 넓은 release를 계획한다고 밝혔다.
이 설명을 보면서 JEV를 처음 붙였을 때의 경험이 바로 떠올랐다.
내가 JEV에서 좋다고 느낀 것도 결국 비슷한 문제 구조였다.
open-ended generation → bounded questions → finite answers → application decision
물론 이것을 “OpenAI가 JEV 방식을 따라왔다”고 해석할 근거는 없다. 두 제품의 내부 구조와 목표가 같다고 말할 수도 없다.
내가 흥미롭게 보는 부분은 제품이 아니라 abstraction이다.
General-purpose LLM이 충분히 좋아진 뒤에도 classification, routing, next-action처럼 반복적이고 제한된 판단을 별도의 engineering surface로 다루려는 흐름이 보인다는 점이다.
내가 Decisions API에 기대하는 것은 Accuracy가 아니다
Decisions API가 JEV보다 더 정확할지, 더 빠를지, 더 쌀지는 아직 이 글에서 말할 수 없다.
현재 내가 직접 동일 17건을 Decisions API로 재실행한 것도 아니다. 공개 preview 단계에서 확보되지 않은 benchmark를 상상해서 채워 넣을 이유도 없다.
내가 기대하는 것은 오히려 API abstraction이다.
General LLM으로 bounded classification을 만들면 개발자가 보통 prompt, allowed values, structured output schema, validation, retry, boundary representation, decision policy를 직접 조립한다.
여기서 앞부분의 많은 작업이 “문장을 잘 생성하는 모델”을 decision component처럼 쓰기 위한 plumbing이다.
Decisions API가 finite questions와 finite answers를 first-class contract로 제공한다면, 적어도 bounded judgment를 표현하는 interface가 더 명확해질 수 있다.
이건 Enterprise workload에서 꽤 중요하다.
우리가 원하는 것이 항상 “좋은 답변을 써줘”는 아니기 때문이다.
어떤 순간에는 정확히 이런 요청이 필요하다.
이 context를 읽고, 내가 허용한 몇 가지 질문에 대해, 내가 허용한 답 안에서 판단해줘.
Email routing, document triage, eligibility check, approval routing, agent next-action 같은 문제는 이런 interface와 잘 맞는다.
Decision API가 생겨도 Business Policy는 사라지지 않는다
여기서 한 가지는 분명히 하고 싶다.
Decision에 특화된 API가 생긴다고 해서 application의 deterministic policy가 없어지는 것은 아니다.
오히려 decision interface가 좋아질수록 경계를 더 명확히 그을 수 있다.
모델이나 Decisions API가 소유할 수 있는 것은 현재 context에서 어떤 candidate가 더 맞는지, finite question에 대한 answer, 여러 option 사이의 semantic judgment, 그리고 필요하다면 uncertainty에 해당하는 signal이다.
하지만 application이 계속 소유해야 하는 것은 다르다.
- canonical taxonomy
- category definition과 policy version
- 어떤 signal이면 AUTO인지 REVIEW인지
- 어떤 category는 반드시 사람 승인이 필요한지
- Salesforce의 어떤 field를 실제 변경할지
- 동일 request의 retry/idempotency
- audit와 human correction
- side effect authority
내가 JEV를 직접 만들어보고 general LLM으로 다시 구현하면서 반복해서 확인한 것도 이 경계였다.
Model이 더 좋아져도 이 책임은 저절로 사라지지 않았다.
결국 오래 남는 것은 모델보다 Decision Surface였다
처음에는 “JEV가 LLM보다 분류에 더 잘 맞을까?”가 궁금했다.
17개 이메일을 두 방식으로 다시 돌리고 나니 질문이 바뀌었다.
둘은 17/17 같은 답을 냈다.
그런데 JEV에서는 질문을 설계해야 했고, general LLM에서는 context와 evidence schema를 설계해야 했다. 비용과 latency profile도 달랐다. 심지어 둘 다 기존 label과 다른 두 사례를 다시 읽으면서 모델뿐 아니라 ground truth도 검증 대상이라는 사실까지 보게 됐다.
그리고 바로 그 시점에 OpenAI는 finite questions와 finite answers를 별도 surface로 다루는 Decisions API를 발표했다.
그래서 지금 내가 더 중요하게 보는 질문은 제품 이름이 아니다.
이 업무에서 intelligence를 어떤 Decision Surface 안에 가둘 것인가?
Model은 바뀔 수 있다.
JEV가 될 수도 있고, general LLM이 될 수도 있고, 앞으로 Decisions API 같은 managed decision primitive가 들어올 수도 있다.
하지만 업무가 허용하는 질문, 답, 경계, escalation과 최종 authority를 명시하는 일은 그대로 남는다.
내 경험상 Enterprise AI에서 오래 살아남는 자산은 모델 선택표보다 그쪽에 더 가까웠다.