
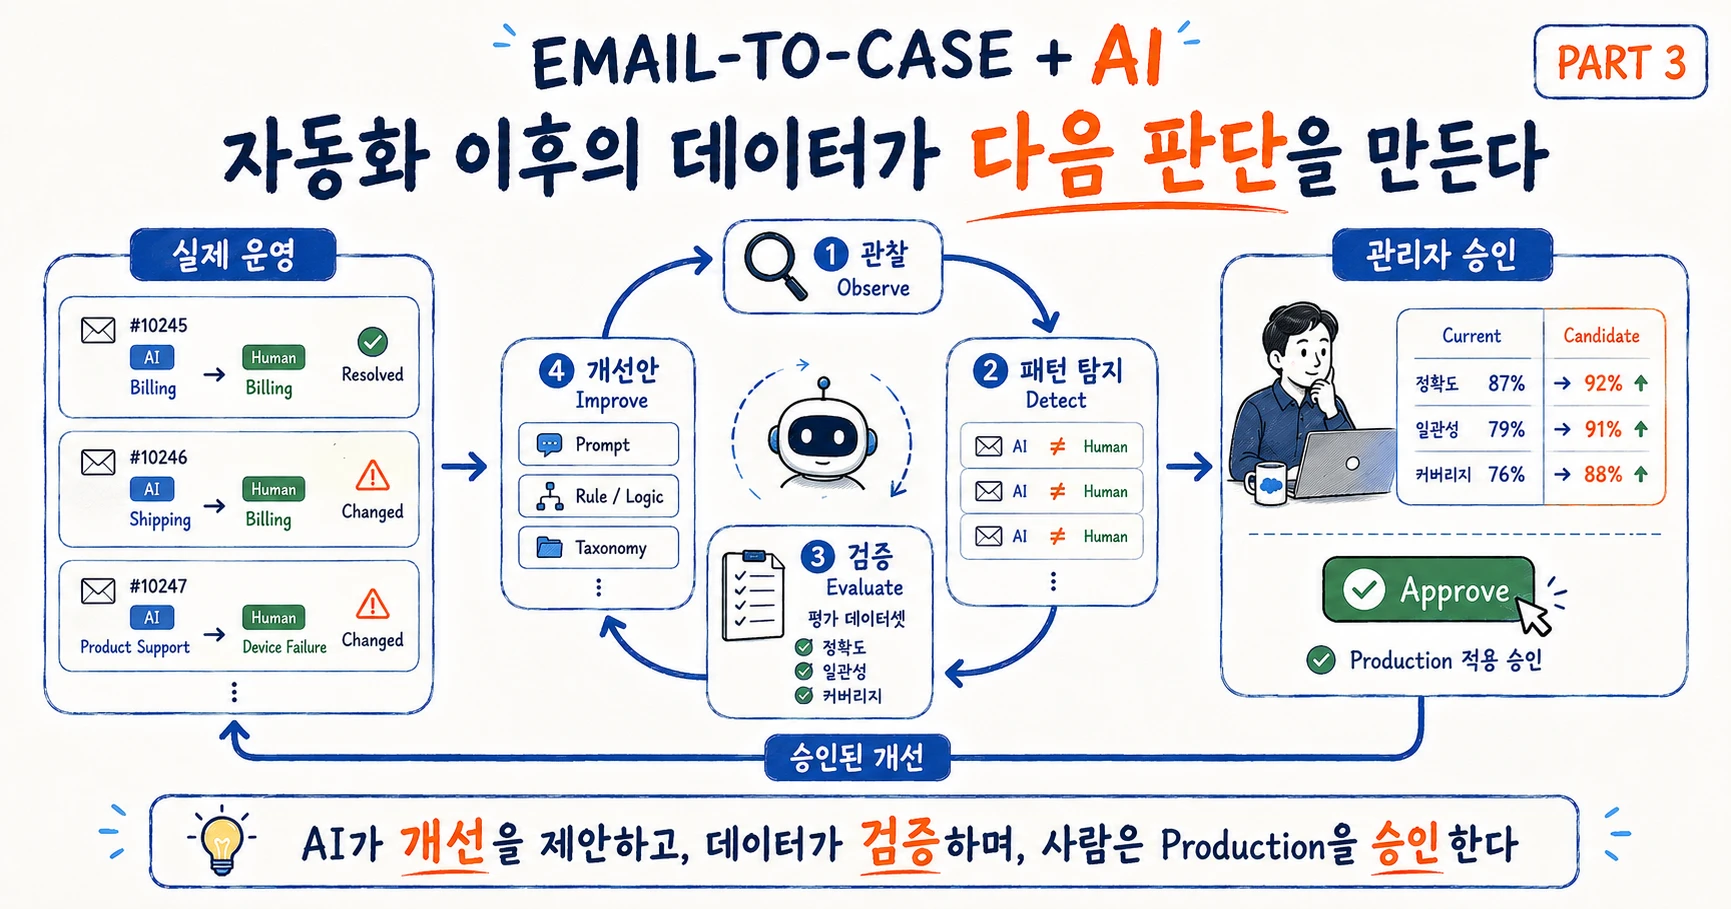
지난 두 글에서는 하나의 작은 요구사항을 계속 따라가봤다.
처음 고객이 원했던 것은 Salesforce Email-to-Case로 생성되는 Case의 Level 1과 Level 2 Category를 AI가 자동으로 판단하는 것이었다.
첫 번째 글에서는 무엇을 AI에게 맡길 것인지 고민했다.
두 번째 글에서는 AI가 고객의 문의 의미를 판단하더라도 실제 Case의 Category, 담당 조직, 업무 이력 같은 상태 변화까지 바로 맡길 필요는 없다고 봤다.
그래서 자연어의 의미 판단은 LLM에게 맡기고, 실제 업무 상태의 변경은 Human Accept와 결정론적인 시스템 로직을 통해 처리하는 구조까지 생각했다.
이 정도면 고객이 처음 이야기했던 불편은 상당 부분 해결된다.
Manager가 모든 신규 Case를 읽고 L1/L2를 직접 선택할 필요도 줄어든다.
그런데 프로젝트가 끝나고 3개월 정도 지났다고 생각해보면 새로운 질문이 생긴다.
그동안 AI는 어떤 문의에서 반복적으로 틀렸고, 우리가 처음 만든 분류 Logic은 실제로 얼마나 좋아졌을까?
이 질문에 답할 수 없다면 조금 아쉽다.
우리는 AI Classification 기능을 만들었지만, 그 시스템이 운영을 통해 더 좋아질 수 있는 구조까지 만든 것은 아닐 수 있기 때문이다.
이번 글에서는 그래서 자동화 이후에 남는 데이터를 어떻게 볼 것인지 이야기해보려고 한다.
단순히 로그를 많이 저장하는 문제가 아니다.
어떤 데이터를 남겨야 하는지, 무엇을 오탐으로 인정할 것인지, 그 데이터를 어떻게 Evaluation Dataset으로 만들고, 개선 후보를 어떻게 검증한 뒤 다시 Production에 반영할 것인지에 대한 이야기다.
1. 자동화가 끝났다고 프로젝트가 끝난 것은 아니다
현실적인 프로젝트에서는 여기까지 구현해도 충분히 성공이라고 볼 수 있다.
Incoming Email
      ↓
Salesforce Case
      ↓
AI Classification
      ↓
L1 / L2
      ↓
Assignment Rule
      ↓
Right Team
고객이 불편해했던 수동 분류 업무가 줄어들었다.
API도 정상적으로 호출된다.
Structured Output도 유효하다.
Case의 Category도 업데이트된다.
Assignment Rule도 정상적으로 실행된다.
요구사항만 놓고 보면 완료다.
문제는 그 다음이다.
몇 달 뒤 이런 질문을 받을 수 있다.
“AI가 주로 어떤 Category를 헷갈립니까?”
“지난달 Prompt를 변경했는데 실제로 좋아졌습니까?”
“잘못된 Queue로 배정된 Case는 얼마나 됩니까?”
“Category가 한 번 바뀐 Case는 평균적으로 처리 시간이 얼마나 늘어납니까?”
그런데 처음부터 필요한 데이터를 남기지 않았다면 대답하기 어렵다.
AX에서 데이터는 시스템을 운영하면 저절로 쌓이는 부산물이 아니다. 나중에 무엇을 알고 싶은지를 먼저 생각해야 한다.
이 지점은 구현 Scope와 조금 다른 문제다.
고객은 지금 당장의 자동 분류만 요구했을 수 있다.
Delivery 팀도 그 범위만 구현하면 계약된 요구사항은 충족한다.
하지만 Improvement Capability까지 처음부터 닫아버릴 것인지는 별도의 Architecture Decision이라고 생각한다.
2. Current State를 저장하는 것과 History를 쌓는 것은 다르다
예를 들어 Salesforce Case에 현재 Category만 저장한다고 해보자.
처음에는:
Billing
이었다가 상담원이 나중에:
Product Support
로 바꿨다.
현재 Case를 조회하면 알 수 있는 것은 이것뿐일 수 있다.
Current Category = Product Support
하지만 우리가 나중에 알고 싶은 것은 훨씬 많다.
AI는 처음 무엇이라고 판단했는가.
그 판단의 Confidence는 얼마였는가.
어떤 EmailMessage와 Context를 보고 판단했는가.
어떤 모델과 Prompt를 사용했는가.
처음 어느 Queue로 배정됐는가.
상담원은 언제 Pickup했는가.
Category는 언제, 누구에 의해 바뀌었는가.
왜 바뀌었는가.
최종적으로 어느 Category에서 종료됐는가.
그리고 실제 Resolution에는 얼마나 걸렸는가.
Current State를 저장하는 것과 History를 축적하는 것은 다른 문제다.
그래서 #2에서 Category Started At, Transition Accepted At, First Pickup At, Resolved At 같은 Timestamp를 굳이 생각했던 이유도 여기에 있다.
지금 당장 Dashboard를 만들지 않더라도, 나중에 분석하고 싶은 사건은 사건이 일어날 때 기록해야 한다.
3. Prediction과 실제 업무 결과를 연결해야 한다
나는 AI Observability를 단순히 모델 호출 로그를 저장하는 것으로 보지는 않는다.
예를 들어 Prediction 쪽에는 이런 정보가 있을 수 있다.
Case ID
EmailMessage ID

Predicted Category Key
Confidence
Predicted At

Model Version
Prompt Version
Taxonomy Version
Rule Version
그리고 실제 업무에서는 이런 일이 일어난다.
Assigned Queue
First Pickup At

Transition Proposed
Accept / Reject

Category Changed
Changed From / To
Changed At

Final Category
Resolved At
Escalated
각각 따로 저장하는 것만으로는 충분하지 않다.
중요한 것은 이 둘이 하나의 업무 흐름으로 연결되는 것이다.
Prediction
      ↓
Assignment
      ↓
Human Operation
      ↓
Correction / Transition
      ↓
Outcome
그래야 나중에 단순히:
“AI가 Billing이라고 분류했다.”
에서 끝나는 것이 아니라,
“AI가 Billing이라고 분류했고 Billing Queue에 배정됐다. 12분 후 상담원이 Pickup했고, 18분 뒤 Product Support로 변경됐다. 이후 Product Support에서 42분 뒤 해결됐다.”
까지 볼 수 있다.
이 정도가 되어야 AI의 판단이 실제 업무에 어떤 영향을 미쳤는지 이야기할 수 있다.
4. 사람이 Category를 바꿨다고 AI가 틀린 것은 아니다
여기서 가장 쉬운 오탐 탐지 방법이 하나 떠오른다.
AI Prediction
Billing

Human Final Category
Product Support
그러면:
AI Wrong
이라고 판단하면 되지 않을까?
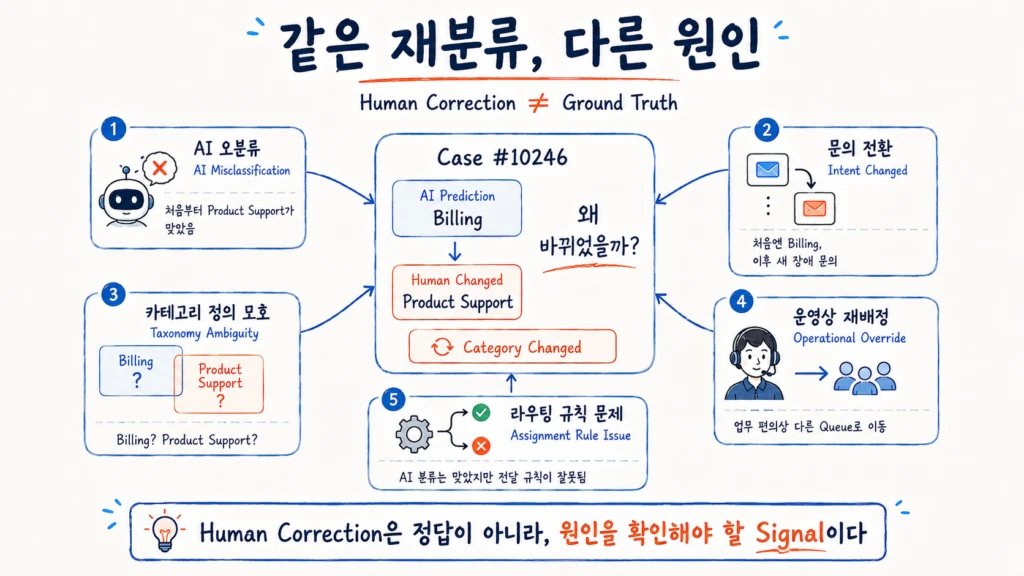
그런데 #2에서 이미 봤듯이 실제 이메일 업무는 그렇게 단순하지 않다.
처음 이메일은 분명 Billing 문의였다가 고객이 나중에 새로운 장비 문제를 이야기했을 수도 있다.
또 다른 경우에는 두 Category의 정의 자체가 애매할 수도 있다.
상담원이 단지 업무 편의를 위해 다른 Queue로 옮겼을 수도 있다.
AI의 Category는 맞았는데 Assignment Rule이 잘못되어 사람이 수정했을 수도 있다.
같은 Category Changed라는 이벤트에도 전혀 다른 원인이 존재한다.
예를 들면:
AI Misclassification
Intent Changed
Taxonomy Ambiguity
Operational Override
Assignment Rule Issue
Other
따라서:
Human Correction은 Ground Truth가 아니다.
Human Correction은 아주 중요한 Signal이다.
하지만 그것을 자동으로 정답 Label이라고 선언해서는 안 된다.
오히려 질문은 이렇게 바뀌어야 한다.
“AI가 틀렸는가?”가 아니라 “사람은 왜 AI의 판단을 바꿨는가?”
이 질문을 할 수 있어야 이후의 개선 방향도 정확해진다.
5. 모든 Correction을 다시 사람이 검토하는 것도 답은 아니다
여기서 또 다른 함정이 생긴다.
사람의 Correction을 바로 Ground Truth로 사용할 수 없다면 Manager가 전부 확인하면 되지 않을까?
예를 들어 한 달에:
Total Cases
10,000

Human Recategorization
430
건이 발생했다고 해보자.
Manager에게 430건을 하나씩 읽게 하고:
AI Wrong?
Yes / No
를 체크하게 만들 수도 있다.
하지만 그렇게 되면 묘한 상황이 된다.
기존에는 Manager가 모든 Case를 수동 분류했다.
AI를 넣어서 그 업무를 없앴다.
그리고 다시 Manager에게 수백 건의 AI Review 업무를 만들어줬다.
자동화로 없앤 일을 AI 검수 업무라는 이름으로 다시 만들 필요는 없다.
그래서 Case 하나하나를 보는 것보다 먼저 반복되는 Pattern을 찾는 쪽이 더 자연스럽다고 생각했다.
6. Case가 아니라 반복되는 Pattern을 본다
예를 들어 이런 변경이 한 건 발생했다고 해보자.
Technical Support
Device Failure
        ↓
Billing
Warranty Charge
한 번이라면 우연일 수도 있다.
그런데 최근 30일 동안 같은 형태가 37번 반복됐다면 이야기가 달라진다.
Technical Support / Device Failure
→ Billing / Warranty Charge

37 Cases
이제는 AI가 특정 유형의 문의를 반복해서 헷갈리고 있을 가능성이 있다.
하지만 단순 Frequency만 높은 Pattern을 보는 것도 충분하지 않을 수 있다.
예를 들어:
Pattern A
General Inquiry
→ Product Inquiry

150 Cases

Average Pickup Delay
+3 min
Pattern B
General Inquiry
→ Critical Incident

14 Cases

Average Pickup Delay
+47 min
건수만 보면 A가 훨씬 크다.
하지만 업무 영향은 B가 더 중요할 수 있다.
그래서 Review Candidate를 고를 때는 개념적으로 이런 요소를 함께 볼 수 있다.
Frequency
×
Business Impact
×
Ambiguity / Confidence
정교한 점수 공식을 처음부터 만드는 것이 목적은 아니다.
중요한 것은 모든 Case를 사람에게 다시 던지지 않고, 확인할 가치가 높은 Pattern을 먼저 찾는 것이다.
7. Manager의 역할도 분류자에서 Governor로 바뀐다
기존의 Manager 역할은 단순했다.
Every New Case
      ↓
Manager
      ↓
L1 / L2 Classification
AI가 들어오면 역할을 이렇게 바꿀 수 있다.
Every New Case
      ↓
AI Classification
      ↓
Operation
      ↓
Pattern Detection
      ↓
High-value Edge Cases
      ↓
Manager Review
Manager가 모든 Case를 분류할 필요는 없다.
대신 이런 Pattern을 볼 수 있다.
Pattern A
AI: Technical / Device Failure
Human: Billing / Warranty Charge
Cases: 37
Avg Delay: +18 min

Pattern B
AI: General Inquiry
Human: Critical Incident
Cases: 14
Avg Delay: +47 min
그리고 실제 사례를 확인한 뒤 원인을 판단한다.
AI Misclassification
Taxonomy Ambiguity
Intent Changed
Operational Override
Rule Issue
Manager의 역할이:
Classification Operator
에서
Classification Governor
로 바뀌는 셈이다.
개인적으로 이것이 AX가 사람의 역할을 바꾸는 더 흥미로운 방식이라고 생각한다.
사람을 단순히 Loop에서 제거하는 것이 아니라, 반복적인 판단에서는 빠져나오고 어떤 판단을 정답으로 인정할지 관리하는 역할로 이동하는 것이다.
8. 운영 로그를 바로 Evaluation Dataset으로 쓰면 안 된다
여기서 데이터의 종류도 구분할 필요가 있다.
다음 네 가지는 비슷해 보이지만 서로 다르다.
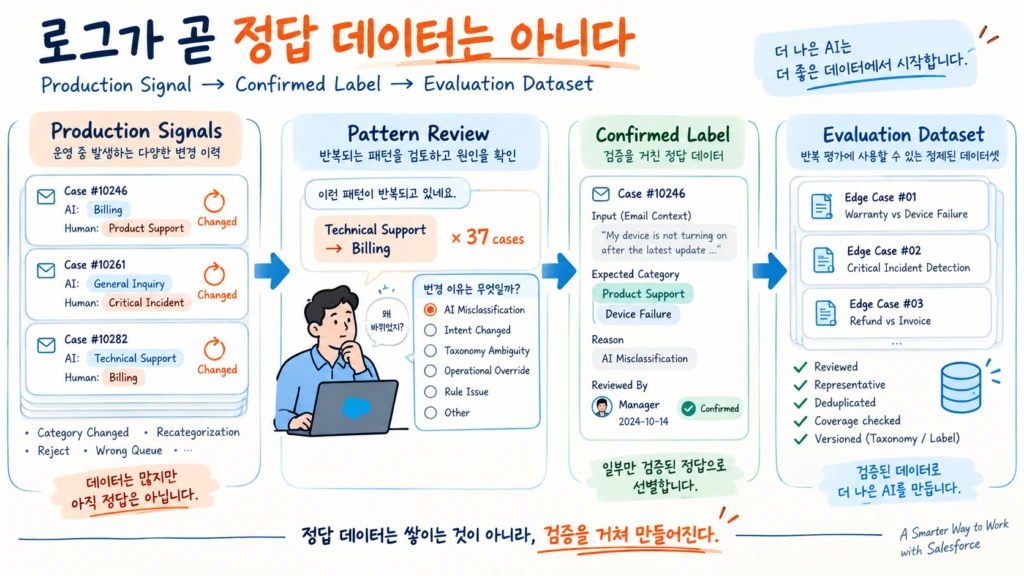
Production Log

Human Correction

Confirmed Label

Evaluation Dataset
예를 들어:
AI
Billing

Human later
Product Support
라는 데이터가 있다.
이것은 중요한 Production Signal이다.
하지만 아직 정답은 아니다.
Manager가 실제 Case와 Email Context를 확인했고:
Reason
AI Misclassification

Expected Category
Product Support / Device Failure
라고 판단했다면 이제 Confirmed Label에 가까워진다.
그런 Samples를 모은 뒤:
- 중복을 줄이고
- Category별 Coverage를 확인하고
- 중요한 Edge Case를 보존하고
- 지나치게 비슷한 사례가 한쪽으로 몰리지 않게 정리하면
비로소 반복 가능한 Evaluation Dataset으로 사용할 수 있다.
Production Log, Confirmed Label, Evaluation Dataset은 서로 다른 것이다.
이 차이는 생각보다 중요하다.
Production 데이터를 아무 검증 없이 다시 모델에게 넣고:
운영
→ 사람이 변경
→ 자동 학습
→ 다시 운영
으로 연결하면 Closed Loop처럼 보일 수 있다.
하지만 사람이 바꾼 이유가 잘못된 경우까지 다시 학습한다면 오히려 오류를 증폭시키는 Feedback Loop가 될 수도 있다.
9. Ground Truth도 영원한 Truth는 아닐 수 있다
Evaluation Dataset을 만들었다고 해서 끝은 아니다.
업무 Category 자체가 변할 수 있기 때문이다.
예를 들어 처음에는:
Taxonomy v7

Billing
├ Refund
├ Invoice
└ Warranty Charge
였다고 해보자.
몇 달 뒤 조직 정책이 바뀌면서 Warranty Charge의 정의가 Product Support 쪽으로 이동할 수도 있다.
그러면 과거에:
Expected Category
Billing / Warranty Charge
라고 검증했던 Sample을 현재 기준에서도 그대로 정답이라고 볼 수 있는지 다시 확인해야 한다.
그래서 Evaluation Sample에도 상황에 따라 이런 Context가 필요하다.
Taxonomy Version
Label Version
Reviewed At
Ground Truth도 업무 정의가 바뀌면 영원한 Truth가 아닐 수 있다.
AI Evaluation에서 Versioning이 중요한 이유도 단순한 개발 편의 때문만은 아니다.
우리가 무엇을 기준으로 Correct라고 판단했는지를 재현할 수 있어야 하기 때문이다.
10. 오분류가 보였다고 바로 Prompt를 고치는 것은 아니다
반복적인 오분류 Pattern이 발견되면 가장 먼저 하고 싶은 것은 Prompt를 수정하는 일일 수 있다.
나도 처음에는 그렇게 생각하기 쉽다.
“이 경우를 Prompt에 한 줄 더 넣으면 되겠는데?”
하지만 실제 원인은 다양할 수 있다.
Taxonomy 문제
두 Category의 업무 정의 자체가 모호하다.
→ Category 정의부터 수정해야 한다.
Prompt 문제
Category 정의는 명확하지만 모델에게 전달된 Instruction이 부족하다.
→ Prompt를 수정한다.
Few-shot 문제
특정 경계 사례에 대한 예시가 부족하다.
→ Example을 보강한다.
Input 문제
Forwarded Email, Signature, 이전 Quote가 Noise로 작용한다.
→ Preprocessing을 개선한다.
Rule 문제
특정 Salesforce Field나 확정적인 조건으로 이미 결정할 수 있다.
→ LLM이 아니라 Deterministic Rule로 이동한다.
Context 문제
최초 Email만 봐서는 판단할 수 없다.
→ 어떤 Context를 함께 제공할지 조정한다.
Model 문제
현재 모델이 필요한 의미 구분을 안정적으로 하지 못한다.
→ 모델을 변경한다.
필요하다면 그 이후에 Fine-tuning 같은 선택지도 검토할 수 있다.
개인적으로는 대략 이런 순서로 생각하는 편이다.
Taxonomy
      ↓
Prompt
      ↓
Few-shot
      ↓
Input Normalization
      ↓
Deterministic Rules
      ↓
Context
      ↓
Model
      ↓
Fine-tuning
절대적인 순서는 아니다.
중요한 원칙은:
가능하면 비용이 낮고, 설명 가능하고, 되돌리기 쉬운 변경부터 검토한다.
여기에서도 무조건 더 강한 AI를 사용하는 것이 답은 아니다.
11. Runtime 모델과 개선을 고민하는 모델도 같을 필요는 없다
이 지점에서 한 가지 재미있는 선택이 가능하다.
#2에서 실제 Email Classification은 비교적 가벼운 모델로도 충분할 수 있다고 이야기했다.
매번 들어오는 이메일마다:
L1 / L2 의미 판단
만 하면 되기 때문이다.
Latency와 비용을 생각하면 Runtime에서는 필요한 수준을 만족하는 가벼운 모델을 사용하는 것이 합리적일 수 있다.
반면 개선 작업은 성격이 다르다.
예를 들어 최근 한 달간 검증된 오분류 Pattern과 Representative Cases를 모아:
왜 이 Category를 반복적으로 헷갈렸는가?

현재 Taxonomy 정의가 애매한가?

Prompt의 어떤 설명이 부족한가?

Deterministic Rule로 옮길 수 있는 조건이 있는가?
를 분석하는 것은 호출 빈도는 낮지만 더 깊은 Reasoning이 필요한 일이다.
이런 곳에는 필요하다면 더 강한 모델을 별도로 사용할 수 있다.
즉:
Production Runtime
→ Lightweight Model
→ 빠르고 경제적인 Classification
과
Offline Improvement
→ Stronger Reasoning Model
→ Pattern / Root Cause / Improvement Proposal
을 굳이 같은 모델로 묶을 필요가 없다.
매번 비싼 모델을 사용하는 것보다, 판단의 성격에 따라 모델의 역할을 나누는 편이 더 합리적일 수 있다.
이것도 결국 LLM의 역할을 하나의 거대한 Agent로 합치는 대신, 각 작업에 맞는 Boundary를 정하는 방식이다.
12. 개선 제안은 Agent에게 맡길 수 있지만 검증 결과까지 믿지는 않는다
여기에서 Agent를 꽤 의미 있게 사용할 수 있다.
예를 들어 Manager가 확정한 오탐 데이터가 충분히 쌓였다고 해보자.
Agent는 다음과 같은 작업을 순차적으로 수행할 수 있다.
Confirmed Misclassification 수집
        ↓
Pattern별 Representative Cases 선택
        ↓
Root Cause 분석
        ↓
Prompt / Rule / Taxonomy 개선안 생성
        ↓
Candidate Logic 생성
        ↓
Evaluation Dataset Bulk Run
        ↓
Current vs Candidate 비교
        ↓
Improvement Proposal 작성
여기까지는 Agent가 상당히 잘할 수 있는 영역이라고 생각한다.
여러 데이터와 도구를 호출하고, 반복적인 Evaluation을 실행하고, 결과를 한 번에 정리할 수 있기 때문이다.
다만 중요한 Boundary가 하나 있다.
“Candidate가 더 좋아졌다.”라는 최종 판단 자체를 Agent의 자연어 평가에만 맡길 필요는 없다.
예를 들어 동일 Evaluation Dataset에 대해서는 애플리케이션이 결정론적으로 계산한다.
Current Logic

Correct 910 / 1000
Accuracy 91.0%
Candidate Logic

Correct 943 / 1000
Accuracy 94.3%
그리고 Category별 Regression도 계산한다.
Agent는 이 결과를 해석하고 설명할 수 있다.
하지만 숫자를 계산하고 Release Gate를 판단하는 기준은 가능한 한 명확한 코드로 유지한다.
다시 같은 원칙이다.
Agent는 개선을 탐색하고 제안할 수 있지만, 검증 기준은 가능한 한 결정론적으로 만든다.
13. 전체 Accuracy가 올라갔다고 더 좋아진 것은 아니다
예를 들어 Candidate Prompt가 이런 결과를 만들었다고 해보자.
| Metric | Current | Candidate |
|---|---|---|
| Overall Accuracy | 91% | 94% |
| Warranty Edge Cases | 62% | 91% |
| Critical Incident | 96% | 94% |
전체 Accuracy는 분명히 좋아졌다.
Warranty 관련 문제는 크게 개선됐다.
그런데 Critical Incident의 Accuracy는 떨어졌다.
전체 숫자만 보면 Candidate를 바로 배포하고 싶을 수 있다.
하지만 Critical Incident가 업무적으로 매우 중요한 Category라면 2%의 Regression도 가볍게 볼 수 없다.
전체 Accuracy가 올라갔다고 더 좋은 업무 시스템이 된 것은 아니다.
그래서 Evaluation에서도:
Overall Metric
+
Category Metric
+
Critical Edge Cases
+
Regression
을 함께 봐야 한다.
그리고 최종적으로는 Model Metric만으로도 충분하지 않다.
14. Accuracy와 실제 업무 성과는 같이 봐야 한다
여기서 #2에서 남겨둔 Timestamp가 다시 중요해진다.
AI Classification의 Accuracy가 좋아졌다고 해보자.
91%
→ 94%
좋은 결과다.
그런데 같은 기간:
Average Resolution Time
42 min
→ 55 min
으로 늘었다면 어떨까.
실제 업무가 좋아졌다고 단정하기 어렵다.
그래서 운영 데이터에서는 이런 지표도 함께 볼 수 있다.
Recategorization Rate

Wrong Queue Rate

Time to First Pickup

First Response Delay

Resolution Time

Category Transition Frequency

Category Oscillation

Escalation Rate
이 지점에서 Email-to-Case처럼 현실의 이메일이 다소 messy한 업무에서는 정확한 이벤트 데이터가 더 중요해진다.
Case가 같은 Thread 안에서 여러 업무 Category를 거칠 수 있다.
현재 Category만 가지고 통계를 내면 이전 업무 구간은 사라진다.
Historical Case의 CreatedDate만 가지고 처리 시간을 계산하면 실제 업무 시간도 왜곡될 수 있다.
그래서 #2에서 업무 구간과 Timestamp를 명시적으로 남겨두자는 이야기가 #3의 분석 기반으로 돌아온다.
Model Metric과 Business Metric은 연결해서 봐야 한다.
그래야 “분류가 더 정확해졌다”를 넘어:
“실제로 더 빨리 올바른 담당자에게 도달했고, 고객 문의가 더 빨리 해결됐다.”
까지 이야기할 수 있다.
15. Manager에게는 변경안이 아니라 근거가 보여야 한다
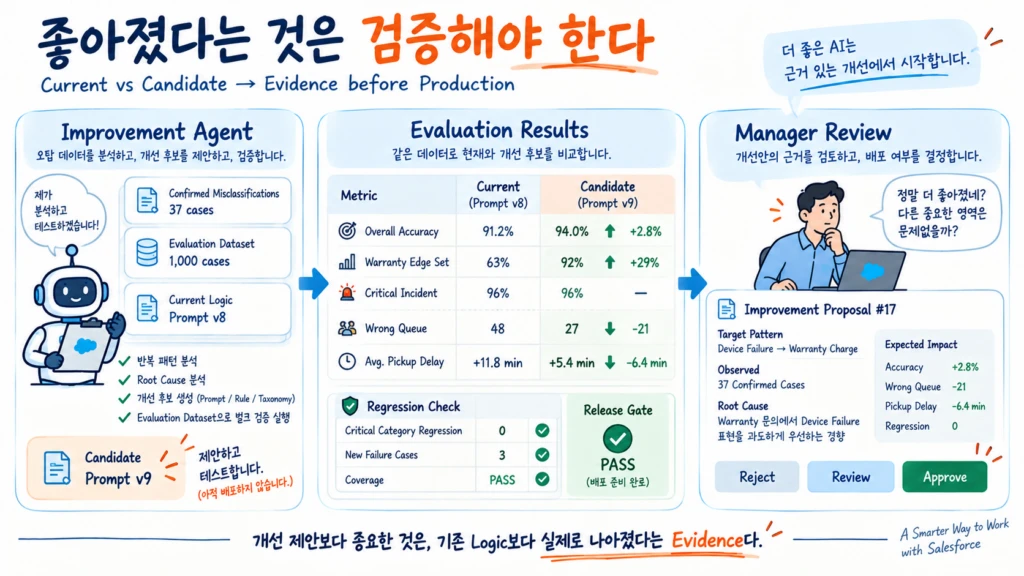
여기까지 오면 Agent가 이런 제안을 만들 수도 있다.
Candidate Improvement #17

Target Pattern
Technical / Device Failure
→ Billing / Warranty Charge

Observed
37 confirmed misclassifications

Root Cause
Warranty 문의에서 device failure 표현을
과도하게 우선하는 경향

Proposal
Prompt v8 → v9

Evaluation

Overall
91.2% → 94.0%

Warranty Edge Set
63% → 92%

Critical Incident
96% → 96%

Business Simulation
Wrong Queue -21 cases / month
Estimated Pickup Delay -6.4 min
Manager가 보는 것은:
“AI가 Prompt를 바꾸자고 합니다.”
가 아니다.
그보다는:
왜 바꾸려고 하는지, 어떤 데이터를 근거로 했는지, 기존 Logic보다 얼마나 나아졌는지, 다른 Category에 Regression은 없는지
를 함께 보는 것이 좋다.
그 상태에서:
[Reject]
[Request Review]
[Approve]
를 결정한다.
AI가 개선안을 만들었다고 바로 Production에 반영하지 않는다.
Manager의 Approve가 다시 한번 Production Boundary가 된다.
#2에서 Human Accept가 하나의 Case 상태 변경을 통제했다면,
#3에서는 Manager Approval이 AI Logic 자체의 변경을 통제한다.
두 글이 같은 철학으로 연결된다.
16. 이제 Closed Loop가 완성된다
전체 구조는 결국 이렇게 된다.
Incoming Case
      ↓
AI Classification
      ↓
Assignment
      ↓
Human Operation
      ↓
Correction / Outcome
      ↓
Observability
      ↓
Pattern Detection
      ↓
Manager Review
      ↓
Confirmed Labels
      ↓
Evaluation Dataset
      ↓
Improvement Analysis
      ↓
Candidate Logic
      ↓
Bulk Evaluation
      ↓
Regression / Business Metrics
      ↓
Manager Approve
      ↓
Deploy
      ↓
Incoming Case...
겉으로 보면 하나의 Data Flywheel처럼 보인다.
하지만 내가 중요하게 보는 것은 이 Loop가 완전히 자율적인 구조가 아니라는 점이다.
AI가 관찰한다
→ AI가 자기 Prompt를 바꾼다
→ AI가 Production에 배포한다
가 아니다.
더 현실적인 구조는:
Observe
→ Detect
→ Propose
→ Evaluate
→ Review
→ Approve
→ Deploy
에 가깝다.
AI는 이 과정에서 많은 일을 할 수 있다.
Pattern을 찾는다.
원인을 분석한다.
개선안을 제안한다.
수천 건의 Evaluation을 실행하는 Agent 역할을 할 수도 있다.
하지만 시스템의 상태와 평가 기준, 그리고 Production 변경 권한까지 모두 AI에게 줄 필요는 없다.
17. 가장 어려운 것은 이 구조를 처음부터 선택하는 일이다
사실 기술적으로 가장 어려운 것은 Closed Loop Diagram을 그리는 일이 아닐 수 있다.
현실에서는 고객이 이렇게 말하기 때문이다.
“이메일 Category 자동 분류만 되면 됩니다.”
그리고 Delivery 팀 입장에서도:
LLM 호출
Structured Output
Salesforce Update
Assignment Rule
까지 구현하면 요구사항을 충족한다.
Prediction History를 왜 따로 저장해야 하는지.
Category Transition의 Timestamp가 왜 필요한지.
Prompt Version까지 왜 기록해야 하는지.
Evaluation Dataset을 왜 생각해야 하는지.
고객이 요구하지 않았다면 굳이 Scope를 늘리고 싶지 않은 것이 현실적이다.
나도 그 판단 자체가 잘못됐다고 생각하지 않는다.
일정도 있고 비용도 있다.
프로젝트에는 명확한 Boundary가 필요하다.
다만 한 가지 차이는 있다.
Implementation Scope를 작게 가져가는 것과, Improvement 가능성까지 처음부터 없애는 것은 같은 선택이 아니다.
예를 들어 처음부터 거대한 Evaluation Platform을 만들 필요는 없다.
하지만 최소한:
Prediction
Model / Prompt Version
Category Change
Accept / Reject
Pickup
Resolved
정도라도 나중에 연결할 수 있게 남겨두는 것은 완전히 다른 결과를 만들 수 있다.
오늘 고객이 요청한 Pain Point는 동일하게 해결한다.
하지만 한쪽에는 몇 달 뒤 개선할 수 있는 데이터가 남고,
다른 한쪽에는 현재 Case의 최종 상태만 남는다.
18. AX의 데이터는 부산물이 아니라 설계해야 하는 자산이다
처음 이 프로젝트를 생각했을 때 고객의 문제는 매우 단순해 보였다.
Manager 한 명이 모든 신규 Case를 읽고 L1/L2 Category를 선택하고 있었다.
AI에게 그 판단을 맡기면 될 것 같았다.
그런데 실제 Salesforce 구조를 보고,
고객이 이메일을 사용하는 방식을 생각하고,
상담원의 업무 상태가 어떻게 움직이는지 따라가고,
Category가 변경됐을 때 무엇을 기록해야 하는지 고민하다 보니 문제의 범위가 달라졌다.
그리고 마지막에는 다시 데이터로 돌아왔다.
AI가 실제로 틀린 것은 무엇이었는가.
왜 틀렸는가.
그 오류는 반복되는가.
업무에 얼마나 영향을 주었는가.
무엇을 바꾸면 나아지는가.
정말 나아졌는가.
이 질문에 답할 수 있는 시스템을 만들려면 AI를 붙인 뒤 생각하는 것이 아니라 AI를 붙일 때부터 데이터를 생각해야 한다.
AX에서 데이터가 쌓인다는 것은 시스템을 운영하면 자연스럽게 생기는 부산물이 아니다. 나중에 무엇을 개선하고 싶은지를 미리 생각하고, 그 판단에 필요한 Signal과 Outcome을 처음부터 남기기로 선택해야 한다.
#1에서 나는 Implementation Scope는 작게 가져가도 되지만 Thinking Scope와 Observability까지 작게 가져가서는 안 된다고 이야기했다.
세 번째 글까지 오고 나니 그 문장의 의미가 조금 더 분명해진다.
Implementation Scope는 작게 가져가도 된다. 하지만 Improvement Scope까지 닫아버릴 필요는 없다.
고객이 오늘 겪고 있는 불편을 해결하는 것은 중요하다. 그러나 잘 설계된 AX라면 거기에서 끝나지 않고, 오늘의 운영이 내일의 더 나은 판단을 만들 수 있는 데이터를 남긴다.
내가 이 작은 Email-to-Case 자동 분류 사례에서 결국 가장 중요하다고 느낀 것도 바로 그 지점이었다.