
ChatGPT로 프로젝트를 오래 진행하다 보면 어느 순간 같은 질문을 하게 된다.
“지난번에 우리가 어디까지 결정했지?”
한두 번의 대화라면 문제가 없다. 하지만 며칠, 몇 주 동안 하나의 프로젝트를 두고 아키텍처를 고민하고, 가설을 세우고, 다시 뒤집고, 무거워진 세션을 다시 열고, 구현 방법을 비교하기 시작하면 이야기가 달라진다.
ChatGPT에는 Memory도 있고 Project도 있다. 필요한 지침을 Project Instructions에 넣어둘 수도 있다.
그런데 프로젝트가 길어질수록 내가 필요했던 것은 더 많은 기억이 아니었다.
지금 어떤 설계를 기준으로 하고 있는지, 왜 그렇게 결정했는지, 어떤 문제는 아직 미확정인지, 다음 세션에서는 어디에서 다시 시작해야 하는지를 확인할 수 있는 현재의 프로젝트 상태가 필요했다.
그래서 질문을 조금 바꿔봤다.
ChatGPT가 대화를 기억하게 만드는 대신, 대화에서 살아남은 지식을 프로젝트 자산으로 남기면 어떨까?
이 글에서는 내가 실제로 사용하는 ChatGPT + GitHub + Obsidian 기반의 개인 LLM Wiki를 최소한의 형태로 만들어본다.
목표는 거대한 지식관리 시스템을 구축하는 것이 아니다.
ChatGPT에서 자유롭게 브레인스토밍하고, 그중 확정된 내용만 Markdown 문서로 승격하고, GitHub가 그 상태를 버전 관리하며, 사람은 Obsidian에서 확인하고, 다음 ChatGPT 세션이 다시 그 상태를 읽는 작은 루프를 만드는 것이다.
Chat History와 Project Knowledge는 다르다
처음에는 ChatGPT Project 안에서 대화를 계속 이어가는 것만으로도 충분하다고 생각했다.
하지만 실제 프로젝트에서는 이런 일이 반복된다.
Session 1
→ 아이디어를 여러 개 비교한다.

Session 2
→ 하나의 아키텍처를 선택한다.

Session 3
→ 실제 구현을 검토하다 설계를 수정한다.

Session 4
→ 새로운 제약조건이 발견된다.

Session 5
→ "현재 기준 구조가 뭐였지?"
문제는 과거 대화가 없어서가 아니다.
오히려 너무 많은 과거 대화가 있다는 것에 가깝다.
초기 가설과 폐기된 설계, 아직 검증되지 않은 생각과 최종 결정이 같은 대화 기록 안에 섞여 있다.
따라서 내 프로젝트에서는 다음 두 개를 구분하기 시작했다.
Chat History
= 어떻게 생각해왔는가

Project Knowledge
= 지금 무엇을 알고 있고 무엇을 기준으로 하는가
Memory 역시 유용하지만, 프로젝트의 Source of Truth와는 역할이 다르다.
내가 원하는 것은 “ChatGPT가 예전에 이야기한 내용을 대략 기억하는 것”보다 다음 질문에 명확히 답할 수 있는 상태였다.
현재 목표는 무엇인가?

현재 아키텍처는 무엇인가?

무엇이 확정되었는가?

무엇이 아직 가설인가?

남아 있는 문제는 무엇인가?

다음 작업은 무엇인가?
이 정보를 ChatGPT의 내부 기억에만 맡기지 않고 외부의 명시적인 문서 상태로 만들기로 했다.
Karpathy의 LLM Wiki에서 가져온 아이디어
이 접근을 정리하면서 흥미롭게 본 것이 Andrej Karpathy가 제안한 LLM Wiki 아이디어였다.
일반적인 문서 기반 AI 사용은 대체로 다음과 비슷하다.
Documents
    ↓
Retrieve
    ↓
LLM
    ↓
Answer
질문이 들어올 때마다 관련 정보를 다시 찾고, 다시 조립하고, 다시 답한다.
LLM Wiki의 흥미로운 지점은 조금 다르다.
LLM이 매번 원자료에서 같은 지식을 재발견하는 대신, 한번 해석하고 정리한 지식을 지속적으로 유지되는 Wiki로 축적한다는 발상이다.
나는 이 아이디어를 그대로 구현하기보다 내가 실제로 겪고 있던 장기 ChatGPT 프로젝트의 연속성 문제에 적용해보기로 했다.
그리고 한 가지 원칙을 세웠다.
대화를 저장하는 것이 아니라, 대화에서 살아남은 지식을 저장한다.
모든 대화를 Wiki로 옮기는 것이 아니다.
브레인스토밍 과정에서 나온 생각 중 현재 프로젝트가 앞으로 의존해야 하는 내용만 외부 Artifact로 승격한다.
이 차이가 중요하다.
내가 만든 최소 구조: ChatGPT + GitHub + Obsidian
내가 원했던 구조는 복잡하지 않았다.
ChatGPT
   ↓
Brainstorming
   ↓
Knowledge Promotion
   ↓
Markdown
   ↓
GitHub
   ↓
Obsidian
   ↓
Next ChatGPT Session
각 도구의 역할도 의도적으로 분리했다.
ChatGPT는 사고하고,
Markdown은 지식을 표현하고,
GitHub는 변경 이력을 가진 Source of Truth가 되고,
Obsidian은 사람이 읽고 검토하는 Workspace가 된다.
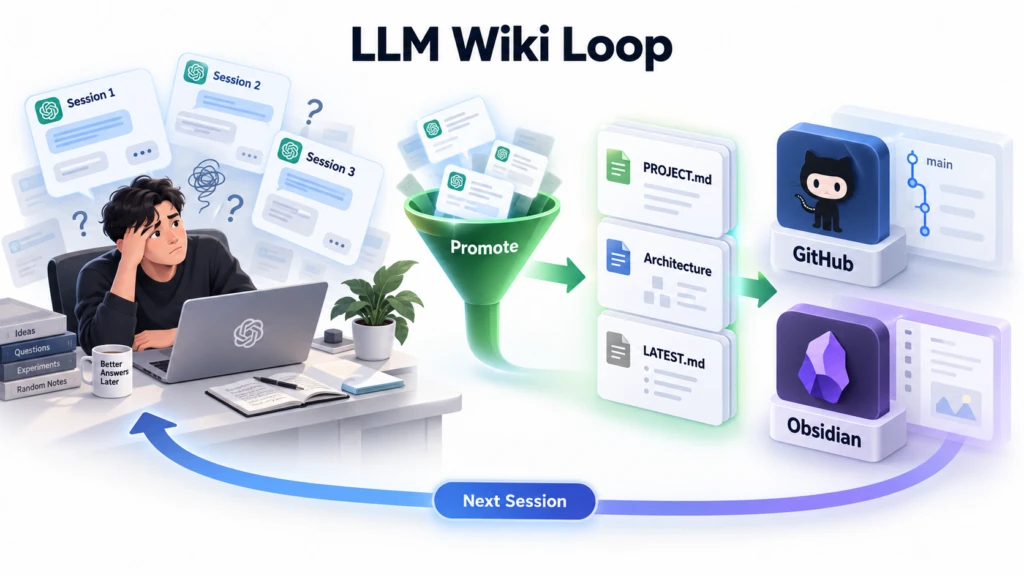
여기서 GitHub를 단순 Backup 용도로 사용하는 것이 아니다.
ChatGPT와 내가 공유하는 지속적인 Project State Layer로 사용한다.
Git을 사용하기 때문에 어떤 문서가 언제 바뀌었는지 확인할 수 있고, 잘못된 변경은 되돌릴 수 있으며, ChatGPT가 작성한 내용과 사람이 수정한 내용도 같은 파일 위에서 계속 발전시킬 수 있다.
Step 1. Obsidian Vault를 Git Repository로 만든다
먼저 Obsidian에서 사용할 Vault를 하나 준비한다.
이미 사용 중인 Vault가 있다면 그대로 사용해도 된다.
나는 프로젝트와 일반 지식을 구분하기 위해 대략 다음과 같은 구조를 사용하고 있다.
my-llm-wiki/
├─ 00-Inbox/
├─ 10-Projects/
├─ 20-Knowledge/
├─ 40-Templates/
└─ README.md
Windows에서 새로 만든다면 예를 들어 다음처럼 시작할 수 있다.
mkdir D:Obsidianmy-llm-wiki
cd D:Obsidianmy-llm-wiki

mkdir 00-Inbox
mkdir 10-Projects
mkdir 20-Knowledge
mkdir 40-Templates

git init
이 폴더를 Obsidian에서 Open folder as vault로 열면 된다.
그다음 GitHub에 Repository를 만들고 연결한다.
git branch -M main
git remote add origin https://github.com/<YOUR_ACCOUNT>/<YOUR_REPOSITORY>.git

git add .
git commit -m "chore: initialize personal llm wiki"
git push -u origin main
여기까지는 특별한 AI 기술이 없다.
중요한 것은 앞으로 ChatGPT와 Obsidian이 동일한 Markdown Repository를 바라보게 만든다는 것이다.
Step 2. 프로젝트마다 최소한의 상태 문서를 만든다
이제 10-Projects 아래에 하나의 프로젝트를 만든다.
처음부터 복잡한 Knowledge Taxonomy를 만들 필요는 없다.
나는 최소 구성으로 다음 정도면 충분하다고 본다.
10-Projects/
└─ my-project/
   ├─ PROJECT.md
   ├─ architecture/
   ├─ decisions/
   └─ handoffs/
       └─ LATEST.md
각 파일의 역할은 다르다.
PROJECT.md는 프로젝트의 비교적 안정적인 정의를 담는다.
예를 들어:
# Project

## Purpose

이 프로젝트가 해결하려는 문제와 최종 목표.

## Current Scope

현재 다루는 범위와 의도적으로 제외한 범위.

## Core Principles

현재까지 확정된 주요 설계 원칙.

## Current Phase

현재 프로젝트가 어느 단계에 있는지.

## Key Artifacts

현재 기준이 되는 Architecture, Decision, Handoff 문서.
반면 LATEST.md는 현재 프로젝트를 다시 시작할 수 있게 해주는 Working Context다.
# Rolling Handoff

## Current Goal

지금 해결하고 있는 목표.

## Current Direction

현재 기준으로 채택된 설계 방향.

## Decisions Made

이번까지 확정된 주요 결정.

## Open Questions

아직 답이 나지 않은 문제.

## Known Risks

현재 알고 있는 리스크나 제약조건.

## Relevant Files

다음 세션에서 읽어야 할 문서.

## Next Actions

다음에 바로 수행할 작업.
여기서 중요한 것은 LATEST.md를 세션 일지로 만들지 않는 것이다.
매번 내용을 뒤에 붙이면 결국 또 하나의 거대한 Chat History가 된다.
나는 이 파일을 현재 상태를 나타내는 Rolling Handoff로 사용한다.
즉 다음과 같다.
Session 1
        ↓
LATEST.md v1

Session 2
        ↓
LATEST.md v2

Session 3
        ↓
LATEST.md v3
과거 내용은 Git History에 남는다.
LATEST.md에는 지금 다시 일을 시작하기 위해 필요한 상태만 남긴다.
Step 3. ChatGPT에 GitHub를 연결한다
이제 ChatGPT가 이 Repository를 읽고 수정할 수 있도록 GitHub를 연결한다.
ChatGPT에서 GitHub Plugin을 연결한 뒤, 사용할 Repository에 접근할 수 있도록 권한을 설정한다.
처음부터 모든 Repository에 접근 권한을 주기보다는 개인 Wiki처럼 용도가 명확한 Repository부터 시작하는 것을 권한다.
연결이 끝났다면 바로 파일을 수정 시키기보다 먼저 읽을 수 있는 지를 확인한다.
예를 들어 이렇게 요청한다.
내 GitHub의 my-llm-wiki Repository를 확인하고

10-Projects/my-project/PROJECT.md
10-Projects/my-project/handoffs/LATEST.md

두 파일을 읽어 현재 프로젝트 상태를 요약해줘.

아직 파일은 수정하지 마.
여기서 중요한 문장은 마지막이다.
“아직 파일은 수정하지 마.”
AI가 Repository에 접근할 수 있다고 해서 모든 대화가 자동으로 Write 작업이 되어야 하는 것은 아니다.
나는 대화와 Knowledge Update 사이에 의도적인 경계를 둔다.
Step 4. Brainstorming 단계에서는 자유롭게 생각한다
이제 평소처럼 ChatGPT와 프로젝트를 논의한다.
예를 들어 새로운 Enterprise AI Architecture를 고민한다고 해보자.
처음부터 Wiki를 수정하지 않는다.
오히려 명시적으로 이렇게 말한다.
지금은 brainstorming 단계다.

현재 PROJECT.md나 architecture 문서를 수정하지 마.

아직 확정되지 않은 가설과 대안까지 포함해서
가능한 구조를 자유롭게 비교해보자.
그러면 대화 안에서는 얼마든지 방향을 바꿀 수 있다.
Idea A
 ↓
문제 발견
 ↓
Idea B
 ↓
반론
 ↓
Idea C
 ↓
새로운 가설
이 단계의 대부분은 최종 Knowledge가 아니다.
이것을 전부 저장하면 Wiki는 금방 오염된다.
내가 유지하려는 경계는 다음과 같다.
Conversation
├─ Exploration
├─ Hypothesis
├─ Rejected Idea
├─ Open Question
└─ Durable Knowledge
           ↓
        Promote
즉 ChatGPT는 자유롭게 생각하되, Wiki는 보수적으로 변경한다.
Step 5. 합의된 내용만 Knowledge로 승격한다
몇 번의 대화 끝에 방향이 어느 정도 정리됐다고 하자.
이때 처음으로 Repository Update를 요청한다.
예를 들면 다음과 같다.
지금까지 논의한 내용 중 확정된 것만 프로젝트 문서에 반영해줘.

기준은 다음과 같다.

- 아직 가설인 내용은 확정 사실처럼 기록하지 않는다.
- 기존 결정과 충돌하는 내용이 있으면 임의로 덮어쓰지 않는다.
- 확정된 Architecture 변경은 관련 문서에 반영한다.
- 해결되지 않은 질문은 Open Questions로 남긴다.
- PROJECT.md는 안정적인 프로젝트 기준만 유지한다.
- handoffs/LATEST.md는 지금 다시 작업을 시작할 수 있는 현재 상태로 갱신한다.

변경 후 어떤 파일을 수정했는지 요약해줘.
여기서 일어나는 변화가 내가 이 구조를 사용하게 된 가장 큰 이유다.
몇십 턴의 Conversation
           ↓
       Synthesis
           ↓
      Promotion
           ↓
몇 개의 명시적 Markdown Artifact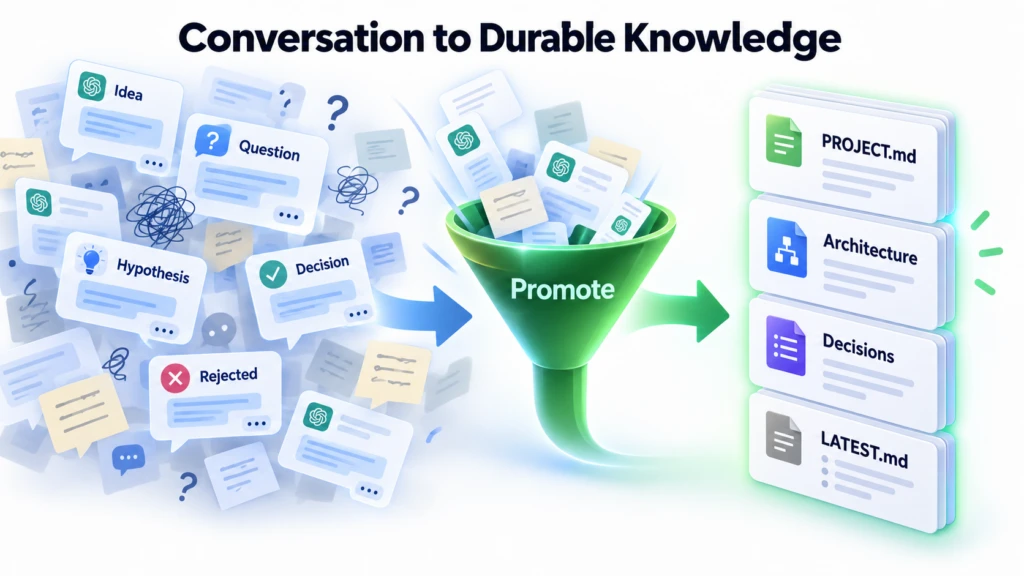
나는 이 과정을 Knowledge Promotion이라고 보고 있다.
중요한 것은 AI가 글을 잘 요약하는지가 아니다.
무엇이 현재 시스템에서 앞으로도 참조해야 할 지식인지, 무엇은 아직 토론 중인지를 분리하는 과정이다.
GitHub를 쓰는 이유는 파일을 저장하기 위해서만은 아니다
Markdown만 필요하다면 Google Drive나 로컬 폴더를 사용해도 된다.
그런데 프로젝트 지식에는 시간이 들어간다.
예를 들어 Architecture 문서가 다음처럼 발전할 수 있다.
v1
Agent가 모든 작업을 수행

        ↓

v2
Agent + Tool 구조로 분리

        ↓

v3
Deterministic Tool + Agent Reasoning 분리
현재 문서만 보면 왜 v3가 되었는지를 놓치기 쉽다.
Git을 사용하면 이 변화 자체가 기록된다.
Current State
+
Diff
+
Commit History
+
Rollback
따라서 GitHub는 단순 Cloud Storage가 아니라 Versioned Project Knowledge의 Source of Truth가 된다.
AI가 작성한 지식 역시 다른 코드나 문서와 마찬가지로 변경 이력을 가지게 된다.
이 지점부터 개인 Wiki가 단순한 메모장과 조금 달라진다.
Step 6. Obsidian에서는 사람이 확인한다
ChatGPT가 Repository를 수정했다면 Windows의 Vault에서 변경사항을 가져온다.
cd D:Obsidianmy-llm-wiki
git pull --ff-only
또는 Obsidian Git Plugin을 사용하고 있다면 Pull 또는 Commit-and-sync 기능을 이용할 수도 있다.
그다음 Obsidian에서 수정된 문서를 직접 읽는다.
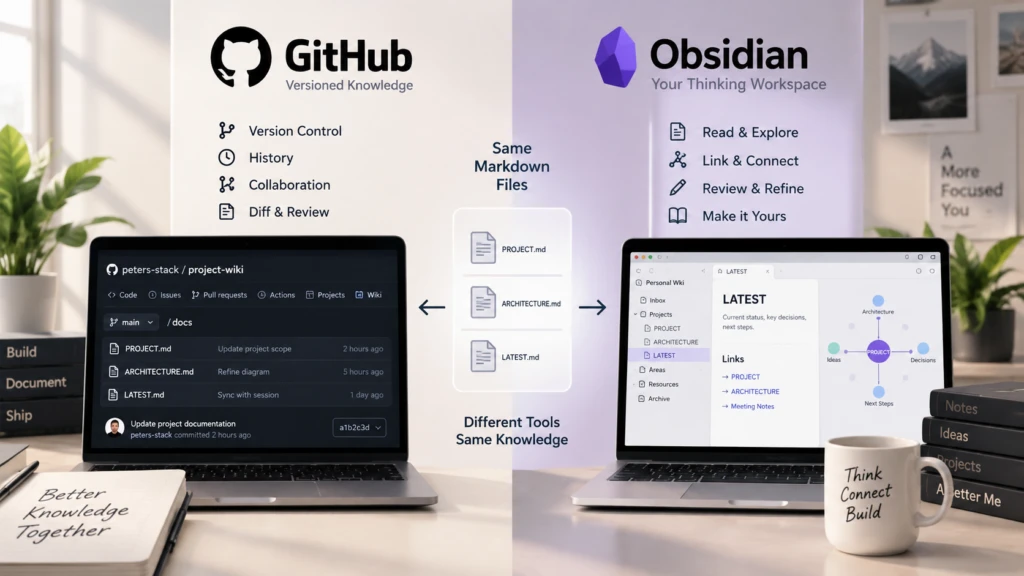
이 구조에서 Obsidian에게 특별한 AI 역할을 맡길 필요는 없다.
오히려 나는 Obsidian을 Human Inspection Layer로 생각한다.
ChatGPT가 생성하거나 수정한 프로젝트 상태를 내가 직접 읽을 수 있고, 필요하면 바로 수정할 수 있으며, Markdown이기 때문에 특정 LLM이나 SaaS에 종속되지 않는다.
LLM
→ Write / Maintain

Human
→ Read / Validate / Correct
이 단순한 역할 분리가 생각보다 중요하다.
AI가 만든 Knowledge가 눈에 보이지 않는 내부 Memory에만 존재한다면 잘못된 내용이 누적돼도 확인하기 어렵다.
Markdown 문서라면 사람이 바로 읽을 수 있다.
Step 7. 새 ChatGPT 세션에서 프로젝트를 다시 시작한다
이제 가장 중요한 테스트를 해본다.
기존 ChatGPT 대화를 계속 이어가지 않고 새로운 세션을 만든다.
그리고 과거 20턴의 내용을 다시 설명하지 않는다.
대신 이렇게 요청한다.
GitHub의 my-llm-wiki Repository에서

10-Projects/my-project/PROJECT.md
10-Projects/my-project/handoffs/LATEST.md

를 읽어줘.

현재 목표, 확정된 설계, 미해결 질문,
다음 작업을 정리한 뒤 그 상태에서 이어가자.
ChatGPT는 프로젝트의 현재 상태를 외부 문서에서 다시 가져온다.
Previous Sessions
       ↓
   Compiled State
       ↓
PROJECT.md
LATEST.md
       ↓
 New Session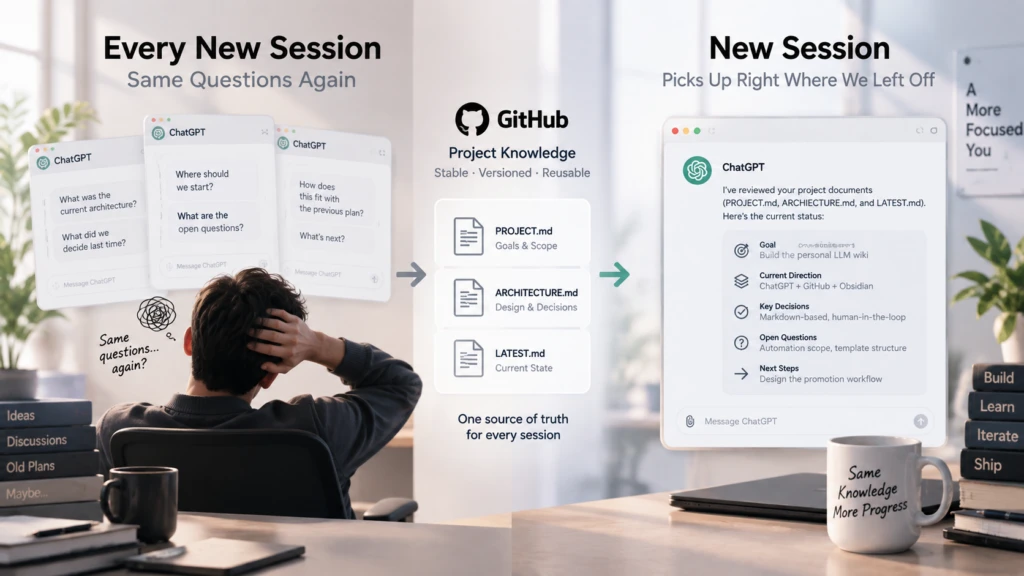
이 순간부터 세션 자체가 프로젝트 상태를 소유하지 않게 된다.
ChatGPT 세션은 언제든 바뀔 수 있다.
반면 프로젝트 상태는 GitHub에 남는다.
이 차이가 장기 프로젝트에서 상당히 컸다.
Project Instructions에는 무엇을 넣어야 할까
이 구조를 사용하기 전에는 장기 프로젝트의 연속성을 유지하기 위해 Project Instructions에 점점 많은 내용을 넣고 싶은 유혹이 있었다.
현재 Architecture, 이전 결정, 주의사항, 파일 위치, 작업 상태까지 넣기 시작하면 Instructions는 계속 커진다.
결국 이런 상태가 된다.
Project Instructions
=
Rules
+ Memory
+ Architecture
+ Current State
+ History
나는 이것을 분리하는 쪽을 택했다.
Project Instructions
= How to work

Project Wiki
= What we know
Instructions에는 비교적 변하지 않는 운영 원칙만 둔다.
예를 들면:
새로운 세션에서는 PROJECT.md와 LATEST.md를 우선 확인한다.

대화 내용만으로 기존 결정을 추정하지 않는다.

확정된 내용과 가설을 구분한다.

사용자의 명시적인 요청이 있을 때 Project Artifact를 갱신한다.
반면 Architecture나 현재 진행 상태처럼 계속 변하는 정보는 Wiki에 둔다.
이렇게 하면 Project Instructions가 프로젝트 전체를 들고 다니는 거대한 프롬프트가 되는 것을 피할 수 있다.
모든 대화를 저장하지 않는 것이 더 중요했다
처음 LLM Wiki라는 말을 들으면 ChatGPT의 모든 대화를 자동으로 저장하는 시스템을 떠올리기 쉽다.
하지만 내가 실제로 사용해보면서 더 중요하다고 느낀 것은 반대였다.
무엇을 저장하지 않을 것인가.
브레인스토밍에서는 잘못된 가설도 필요하다.
극단적인 아이디어를 던져보고, 반박하고, 폐기하면서 더 나은 설계에 도달한다.
이 흔적을 모두 현재 Knowledge처럼 저장하면 Wiki는 오히려 혼란스러워진다.
따라서 내 흐름은 다음에 가깝다.
Think freely
     ↓
Challenge
     ↓
Decide
     ↓
Promote selectively
     ↓
Maintain current knowledge
이것은 Conversation Archive를 만드는 작업이 아니다.
Project Knowledge를 컴파일하는 작업에 가깝다.
개인 LLM Wiki는 Enterprise Knowledge Architecture의 작은 실험이기도 하다
여기까지는 개인 생산성 도구처럼 보인다.
실제로 개인 프로젝트라면 이 정도 구조만으로도 충분히 유용하다.
하지만 이 작은 시스템을 만들고 나니 내가 Enterprise AI에서 고민하고 있던 문제와 상당히 비슷하다는 생각이 들었다.
개인 버전에서는:
Conversation
     ↓
Human Judgment
     ↓
Knowledge Promotion
     ↓
Markdown
     ↓
Reuse
기업에서는 규모가 커질 뿐 본질적인 질문은 비슷하다.
Documents / CRM / Meetings / External Data
                  ↓
              Interpretation
                  ↓
         Reconciliation / Validation
                  ↓
          Knowledge Promotion
                  ↓
        Enterprise Knowledge
                  ↓
             Agent Reuse
개인 Wiki에서는 내가 어떤 내용을 승격할지 결정한다.
Enterprise에서는 그 자리에 더 많은 문제가 들어온다.
누가 이 정보를 볼 수 있는가, 어떤 Source가 더 신뢰할 수 있는가, 새로운 정보가 기존 지식과 충돌하면 어떻게 할 것인가, 오래된 내용은 언제 폐기할 것인가, AI가 자동으로 업데이트할 수 있는 범위는 어디까지인가.
즉 Personal LLM Wiki에서 Governance를 키우기 시작하면 자연스럽게 Enterprise Knowledge Architecture 문제가 된다.
이번 글에서는 그 단계까지 가지 않는다.
우선 가장 작은 단위에서 중요한 원리를 직접 확인하는 것이 목적이었다.
내가 얻은 결론: Memory보다 먼저 State를 설계한다
ChatGPT를 오래 사용할수록 더 좋은 Memory가 필요하다고 생각하기 쉽다.
하지만 프로젝트 관점에서는 질문을 조금 다르게 볼 필요가 있다.
AI가 무엇을 기억해야 하는가보다, 프로젝트가 어떤 상태를 명시적으로 남겨야 하는가가 먼저다.
내가 현재 사용하는 최소 루프는 아주 단순하다.
ChatGPT에서 생각한다.

        ↓

확정된 것만 Markdown으로 승격한다.

        ↓

GitHub가 변경 이력을 가진 상태로 보존한다.

        ↓

Obsidian에서 사람이 확인한다.

        ↓

다음 ChatGPT 세션이 다시 읽는다.
특별한 Vector DB도, Graph DB도, 별도의 Agent Platform도 필요하지 않았다.
Markdown과 Git만으로도 먼저 대화와 프로젝트 지식을 분리하는 습관을 만들 수 있었다.
그리고 지금은 이 단순한 구조가 이후에 더 큰 LLM Wiki를 설계하기 위한 좋은 출발점이라고 보고 있다.
대화를 오래 보관하는 것이 목표가 아니다.
다음 판단에 사용할 수 있는 지식을 남기는 것이 목표다.
다음 글에서는 여기서 한 단계 더 나아가, ChatGPT가 GitHub에 남긴 Project State를 실제 자동화와 연결하는 방법을 다뤄보려고 한다.
Git Commit을 단순한 기록으로 끝내지 않고 n8n과 서버가 받아 실행한다면, GitHub는 Knowledge 저장소를 넘어 AI와 실제 Runtime 사이의 Control Plane으로 확장될 수 있다.