
Reasoning Model의 성능이 빠르게 좋아지고 Coding Agent, MCP, Tool Calling, 다양한 Agent Harness가 등장하면서 나도 한동안 비슷한 실험을 반복했다. Agent에게 더 많은 Tool을 주고, 계획과 실행을 맡기고, 여러 단계를 스스로 이어가게 하면 어디까지 갈 수 있을지 궁금했다. 특히 Vibe Coding에서는 Agent가 Repository를 읽고, 코드를 수정하고, 테스트하고, 실패를 다시 고치는 과정이 실제로 잘 동작한다. 이런 경험을 하고 나면 자연스럽게 다음 질문이 생긴다.
“업무 자동화도 그냥 Agent에게 전체를 맡기면 되는 것 아닐까?”
그런데 실제 고객 업무와 시스템을 연결하기 시작하면 질문이 조금 달라진다.
“잠깐, 이 단계는 애초에 Agent가 판단할 필요가 있었을까?”
내가 지금 더 중요하게 보는 것은 Agent가 얼마나 많은 일을 할 수 있는지가 아니다. 어디에 확률적 판단이 필요하고, 어디부터는 같은 입력과 상태에 같은 결과가 나와야 하는지를 구분하는 것이다. 이 경계를 잘못 잡으면 좋은 모델을 사용하고도 고객에게는 “AI 성능이 낮다”는 평가를 받을 수 있다.
Agent가 좋아질수록 더 많은 일을 맡기고 싶어진다
Agent에 대한 기대가 커지는 이유는 충분하다. Coding Agent는 작업해야 할 파일과 수정 순서를 사전에 모두 정하지 않아도 목표를 보고 계획을 세울 수 있다. OpenClaw 같은 개인 비서형 Agent도 메시징 채널, Workspace, Tool과 연결되어 사용자의 요청을 해석하고 다음 Action을 선택하는 형태로 발전하고 있다. OpenClaw의 공식 문서도 이를 항상 접근 가능한 개인 AI Assistant로 설명하면서, 연결된 Agent가 파일이나 명령, 메시지 같은 Tool을 사용할 수 있기 때문에 Tool Policy와 Sandbox를 보수적으로 설정할 것을 함께 강조한다.
개인 비서 관점에서는 이런 자율성이 꽤 자연스럽다.
- 오늘 온 메일 중 내가 신경 써야 할 것을 골라달라.
- 이번 주 일정을 보고 우선순위를 정리해달라.
- 여러 자료를 읽고 다음에 확인할 질문을 제안해달라.
- 여행 계획을 비교해서 후보를 좁혀달라.
이런 요청에는 실제로 해석과 판단이 들어간다. 정답이 하나로 고정되어 있지도 않다. Agent가 Context를 읽고 선택하는 데 Reasoning Token을 쓰는 이유가 있다.
하지만 개인 비서에게 부탁하는 일도 모두 그렇지는 않다.
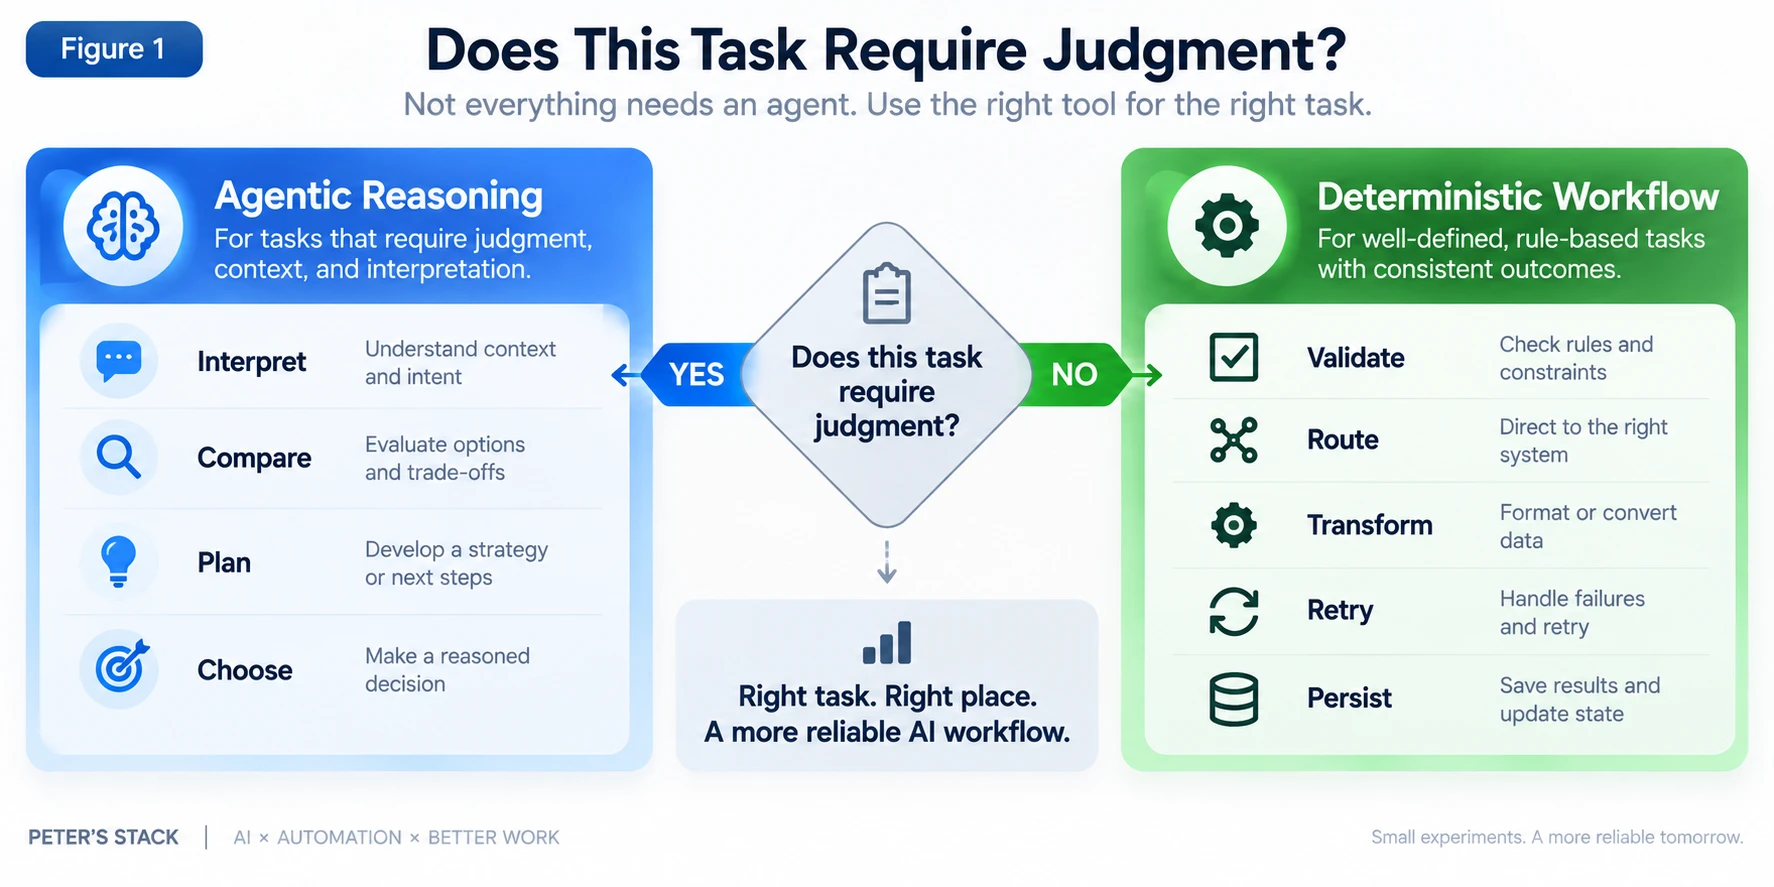
“매일 오전 8시에 특정 API를 호출하고, 결과를 정해진 형식으로 변환해서 저장해줘”라는 요청은 다르다. 한 번 합의된 동작을 계속 반복하기를 원하는 것이다. 매번 LLM이 무엇을 해야 하는지 다시 생각하고 Tool을 고르게 만들 이유가 없다. 이런 경우라면 Schedule Trigger, HTTP Request, Transform, Persist 같은 Workflow가 더 빠르고 싸고 예측 가능하다.
“내 대신 해줘”와 “매번 생각해서 해줘”는 같은 요구가 아니다.
Anthropic도 Agentic System을 설명하면서 이 둘을 구분한다. Building Effective Agents에서는 Workflow를 “미리 정의된 Code Path로 LLM과 Tool을 Orchestrate하는 시스템”, Agent를 “LLM이 자신의 Process와 Tool 사용을 동적으로 결정하는 시스템”으로 나눈다. 그리고 잘 정의된 작업에서는 Workflow의 예측 가능성과 일관성이 유리하고, Agent는 유연성과 Model-driven Decision Making이 필요한 곳에서 가치가 있다고 설명한다.
이 구분은 단순한 용어 차이가 아니다. Architecture를 어디서 나눌 것인지에 대한 실질적인 기준이 된다.
97%가 훌륭한 성능일 때와 실패일 때
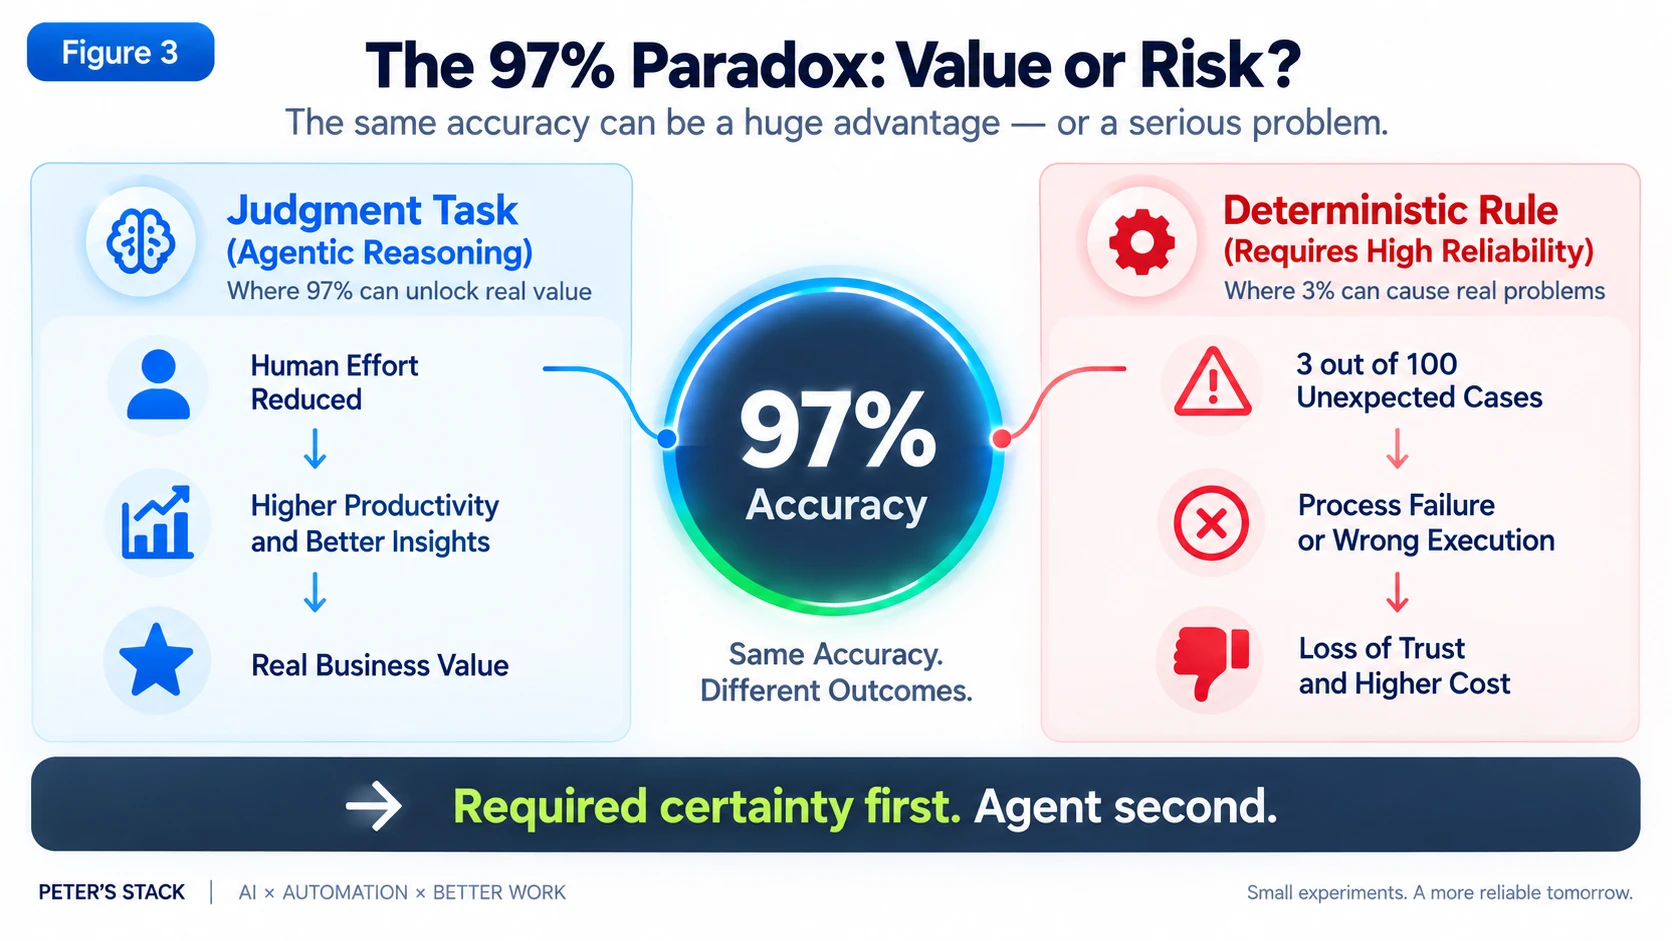
Enterprise AX에서 더 어려운 문제는 Accuracy 숫자 자체가 아니다. 그 업무가 원래 어떤 Certainty를 기대하고 있었는가다.
예를 들어 자연어로 들어온 고객 메일의 실제 의도를 분류한다고 해보자. 규칙 몇 개로 표현하기 어려운 표현이 섞이고, 같은 문장도 고객 상황에 따라 의미가 달라질 수 있다. 이런 영역에서 97%의 정확도는 상당한 가치가 있을 수 있다. 기존에는 사람이 매번 읽고 판단해야 했던 일이기 때문이다.
반대로 고객의 Day-to-Day 업무에서 이미 다음과 같은 규칙이 있다고 하자.
유효한 입력 A
+ 현재 상태 B
+ 업무 규칙 C
→ 결과 D
현업은 이 결과를 경험적으로 “항상 그렇게 동작하는 것”으로 받아들인다. 물론 실제 소프트웨어 시스템에도 장애는 있을 수 있다. 여기서 말하는 100%는 시스템 전체가 절대로 실패하지 않는다는 뜻이 아니다. 동일한 유효 입력과 동일한 상태라면 업무 규칙상 동일한 결과가 나와야 한다는 기대다.
그 영역을 Agent에게 맡겨 결과가 100건 중 97건만 맞았다면 개발자는 이렇게 말할 수도 있다.
“97%면 상당히 좋은 성능 아닌가?”
하지만 고객은 다르게 본다.
“원래 되던 일이 왜 AI를 붙이고 세 번이나 틀리죠?”
이 반응은 충분히 합리적이다. 그 업무는 애초에 확률적 판단의 대상이 아니었을 수 있기 때문이다.
내가 중요하게 보는 포인트는 여기다.
Agent Accuracy가 낮은 것이 아니라, Agent가 필요하지 않은 영역에 확률적 시스템을 넣은 Architecture가 문제일 수 있다.
이 구분을 하지 않으면 고객은 모델 성능이나 구현 기술을 의심하게 된다. 반대로 설계자는 Prompt를 더 길게 만들고, 예외 규칙을 더 추가하고, 모델을 더 큰 것으로 바꾸는 방식으로 문제를 해결하려 한다. 하지만 원인이 Architecture라면 Model Upgrade로는 본질적인 문제가 사라지지 않는다.
확률적 판단이 필요하다는 것과 확률적으로 실행해도 된다는 것은 다르다
직전 글에서는 MCP로 Tool을 연결한 뒤에도 Agent의 Tool Planning과 실제 Execution Authority를 분리해야 한다는 이야기를 했다. Agent가 “무엇을 해야 하는가”를 판단할 수 있다고 해서 실제 Business System에서 “해도 되는가”까지 Agent가 결정할 필요는 없다는 내용이었다.
이번에는 그보다 한 단계 앞의 질문이다.
“그 판단 자체가 정말 LLM의 Reasoning을 필요로 했는가?”
예를 들어 Customer Email을 처리하는 흐름을 생각해보자.
Customer Email
    ↓
Deterministic Intake
Schema / Required Field / Identity / State
    ↓
Agentic Reasoning
Intent Interpretation / Classification
    ↓
Deterministic Control
Routing Rule / Policy / Idempotency
    ↓
Executor
CRM Update / Notification
메일의 의도를 해석하는 부분은 Agent가 잘할 수 있다. 하지만 Intent = Warranty이고 Region = Korea일 때 지정된 Queue로 Routing하는 업무 규칙까지 매번 LLM이 판단할 이유는 없다. 이미 정해진 규칙이라면 Code가 더 적합하다.
이 차이를 한 문장으로 정리하면 다음과 같다.
확률적 판단이 필요한 것과, 확률적으로 동작해도 되는 것은 전혀 다른 문제다.
Agentic Architecture는 시스템 전체를 확률적으로 만드는 설계가 아니다. 불확실성을 해석해야 하는 최소 영역에 Agent를 배치하고, 나머지는 가능한 한 결정론적으로 유지하는 편이 Test, Retry, Audit, Cost, Latency를 모두 관리하기 쉽다.
그래서 나는 빠른 PoC에서 n8n을 적극적으로 쓴다
여기서 n8n 이야기가 나온다.
먼저 오해하지 않았으면 하는 것이 있다. Enterprise AX Production 전체를 n8n으로 구성하자는 이야기가 아니다. 고객의 운영 시스템에서 요구하는 Availability, Security, IAM, Transaction, State, Deployment, Observability 조건에 따라 AWS Step Functions, Lambda, Queue, API Gateway, Application Backend, Integration Layer 같은 구성요소가 더 적합할 수 있다.
내가 n8n을 적극적으로 사용하는 지점은 빠른 PoC와 Architecture Exploration이다.
아이디어가 생겼을 때 다음 요소들을 빠르게 연결해 실제 동작으로 만들어 볼 수 있다.
Trigger
→ Validation
→ API
→ JavaScript / Python
→ LLM / Agent
→ IF / Switch
→ External System
→ Result
특히 Agent를 붙일 때 이 방식의 장점은 무엇이 Agentic이고 무엇이 Deterministic인지 눈에 보인다는 것이다.
최근 n8n도 자신을 단순한 Agent Framework라기보다 “automation engine first”라고 설명한다. 공식 AI Agent 페이지에서는 deterministic automation step과 AI를 섞고, Human-in-the-loop, Error Handling, Fallback Logic을 추가해 Agent를 predictable logic 안에 두는 방식을 강조한다.
이 방향은 내가 PoC에서 n8n을 사용하는 이유와 잘 맞는다.
예전에 GitHub Commit을 n8n과 OCI Runtime으로 연결했던 PoC에서도 비슷한 원칙을 사용했다. AI가 무엇을 변경할지 판단하더라도 Repository, Branch, Commit SHA, Allowed Path, Action Allowlist 같은 조건은 n8n의 Code/IF와 FastAPI에서 결정론적으로 검사했다.
그때도 중요한 것은 n8n 자체가 아니었다.
Reasoning
→ AI

Policy / Routing
→ Deterministic Logic

Execution
→ Controlled Runtime
이라는 경계를 실제로 움직이는 시스템으로 빨리 확인하는 것이 중요했다.
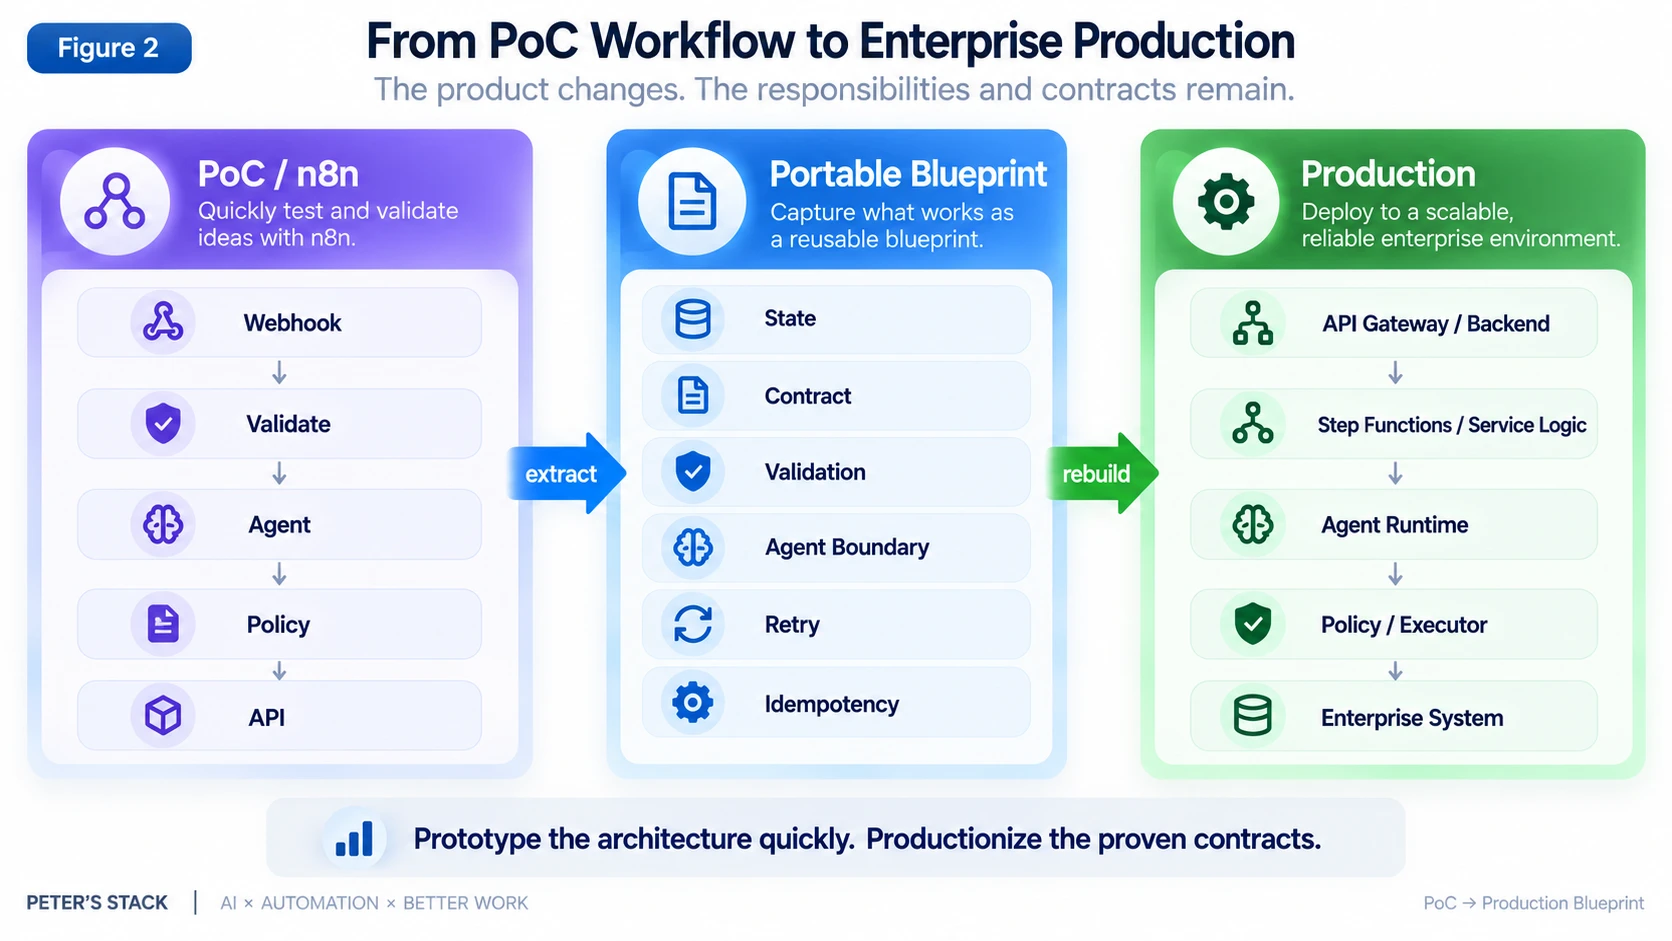
n8n에서 만든 Workflow 자체보다 Blueprint가 남는다
PoC를 Production으로 가져갈 때도 n8n Workflow를 그대로 복사하는 것이 목표는 아니다.
예를 들어 PoC에서 다음처럼 만들었다고 하자.
Webhook
→ Validate Input
→ Lookup Context
→ Agent
→ Parse Result
→ Policy Check
→ CRM API
실제 Enterprise 환경에서는 같은 책임이 다음처럼 재배치될 수 있다.
| PoC에서의 역할 | Enterprise Production의 구현 후보 |
|---|---|
| Webhook / Trigger | API Gateway, Event Bus, Application Backend |
| IF / Switch | Backend Business Logic, State Machine Choice |
| Code Node | Lambda, Container Service, Backend Module |
| Workflow State | Step Functions, Durable Orchestrator, Job Store |
| Credential | IAM, Secret Manager, Workload Identity |
| Retry / Timeout | Step Functions, Queue, Application Runtime Policy |
| Agent Node | Agent Runtime, Model API, Managed Agent Service |
| HTTP Request | Enterprise Integration Layer, Typed API Client |
AWS도 Step Functions와 Lambda를 함께 사용하는 가이드에서 Sequential Processing, Conditional Workflow, Error Handling, Human Approval 같은 흐름을 명시적인 Workflow로 Orchestrate하는 패턴을 제시한다. 반대로 Workflow Logic을 표준 프로그래밍 언어 안에서 관리하는 것이 더 적합한 경우에는 Lambda Durable Functions 같은 Code-first 방식도 선택지로 설명한다.
즉 중요한 것은 “n8n Node를 Step Functions State로 1:1 변환한다”는 것이 아니다.
PoC에서 먼저 검증해야 하는 것은 다음과 같은 책임과 계약이다.
- 어느 단계에서 State가 생기는가.
- 어떤 입력을 Validation해야 하는가.
- 어떤 조건은 정해진 Rule인가.
- 어디에서 Agent의 Reasoning이 실제로 필요한가.
- Agent의 Output은 어떤 Schema를 만족해야 하는가.
- Retry가 발생해도 중복 실행되지 않는가.
- 어떤 Action은 Approval을 거쳐야 하는가.
- 외부 시스템에 전달하는 Payload Contract는 무엇인가.
그래서 나는 n8n Workflow를 Executable Architecture Sketch에 가깝게 본다.
PowerPoint의 화살표와 상자로 Architecture를 논의하는 것보다 실제 API를 호출하고 실제 Payload를 흘려보내 보면 훨씬 빨리 문제를 발견할 수 있다. 그리고 그 과정에서 작성한 JavaScript나 Python도 모두 버리는 코드가 아니다. Validation Logic, Data Transformation, Schema, API Contract, Payload Shaping 같은 부분은 AX 대상 시스템에서 Backend Logic을 구현할 때 작은 Blueprint가 된다.
결정론적 문제를 Agent에게 맡기면 구현이 오히려 더 고통스러워진다
Agent에 모든 것을 맡기는 구조는 처음에는 단순해 보인다.
예를 들어 Prompt에 “고객의 요청을 이해하고 적절한 Tool을 골라 필요한 작업을 수행하라”고 적으면 몇 줄로 많은 일을 해낸다. PoC Demo도 빠르게 나온다.
그런데 고객의 실제 Business Requirement와 Existing Process에 맞추기 시작하면 상황이 달라진다.
A이면 Tool 1을 사용한다.
단 Status가 B이면 실행하지 않는다.
Role C만 변경할 수 있다.
D 값이 없으면 먼저 조회한다.
이미 처리된 요청이면 다시 실행하지 않는다.
실패하면 두 번 Retry한다.
두 번째 실패는 Queue에 남긴다.
금액이 일정 수준 이상이면 Approval을 거친다.
이 조건들이 늘어날수록 Prompt와 Agent Harness는 점점 Workflow Engine과 Policy Engine처럼 변한다.
결정론적 문제를 Agent에게 맡기면 복잡성이 사라지는 것이 아니다. 복잡성이 Prompt와 Harness 내부로 이동한다.
그리고 그 안으로 들어간 규칙은 일반적인 Code보다 Test하기 어렵고, 실행 경로를 설명하기 어렵고, Token을 더 사용하며, Model Update에 따른 Behaviour Change까지 고려해야 한다.
특히 고객의 기존 Process는 여러 시스템과 톱니바퀴처럼 맞물려 있다. Salesforce의 Record State, ERP의 처리 상태, 승인 권한, 기존 Batch, API 호출 순서처럼 “정해진 것”이 많다. 이런 곳에서 Agent가 더 똑똑해지는 것이 반드시 도움이 되는 것은 아니다.
오히려 Architecture가 명확하면 Agent가 처리해야 하는 Context도 줄어든다.
Agent
= Interpret / Compare / Infer / Plan / Choose

Deterministic Layer
= Validate / Route / State / Retry / Policy / Persist
Reasoning Token은 실제 Reasoning이 필요한 곳에 쓰는 편이 낫다.
PoC에서 Production으로 가면 Value의 정의가 바뀐다
빠른 PoC에서 중요한 질문은 비교적 단순하다.
“Can it do this?”
고객이 상상만 하던 기능을 실제 화면과 Workflow로 보여주고, 며칠 단위로 Feedback을 받아 다시 바꿀 수 있다면 그것 자체가 큰 Value다. 그래서 나는 Agent Runtime이나 n8n 같은 도구를 활용해 Feedback Latency를 줄이는 것을 중요하게 생각한다.
하지만 Production으로 가까워질수록 고객이 묻는 질문은 달라진다.
“Can we depend on it?”
이때부터 Value는 Capability만으로 설명되지 않는다.
- 같은 입력과 상태에서 예측 가능한 결과가 나오는가.
- 실패를 탐지하고 원인을 확인할 수 있는가.
- Retry해도 중복 처리되지 않는가.
- 누가 어떤 판단과 실행을 했는지 추적할 수 있는가.
- 기존 Business Process의 State와 정확히 맞물리는가.
- Agent가 틀려도 시스템 전체가 안전한 상태를 유지하는가.
이 질문에 답할 수 있어야 고객은 AI를 Demo가 아니라 Day-to-Day 업무의 일부로 받아들인다.
그래서 Reliability는 기술적인 Non-functional Requirement만이 아니라 고객이 체감하는 Business Value의 일부라고 생각한다.
판단이 필요한 업무에서 97%의 AI Performance는 사람이 하던 일을 크게 줄여주는 Value가 될 수 있다. 반대로 결정론적으로 돌아가던 업무를 AI 때문에 97%로 만들었다면 같은 숫자가 Operational Failure가 된다.
그럼 어디까지 Agent에게 맡겨야 할까
나는 지금 업무의 각 Step을 볼 때 다음 질문을 먼저 던지는 편이다.
1. 결과를 명확한 규칙으로 표현할 수 있는가
가능하다면 우선 Code나 Workflow 후보로 본다. Allowlist, Required Field, Role Check, State Transition, Routing Rule처럼 조건을 명시할 수 있다면 LLM이 매번 새로 판단하게 만들 이유가 적다.
2. 동일한 입력과 상태에서 동일한 결과가 기대되는가
그렇다면 Deterministic하게 유지할 이유가 더 강해진다. 특히 Retry, Idempotency, Permission, Persistence처럼 운영 안정성과 연결되는 영역은 그렇다.
3. 자연어, 문맥, 의미를 해석해야 하는가
여기부터 Agent가 강해진다. 고객의 실제 Intent를 읽거나, 여러 Evidence를 비교하거나, 어떤 정보를 더 찾아야 하는지 결정하거나, 작업 계획을 세우는 문제는 규칙만으로 표현하기 어렵다.
4. 판단이 틀렸을 때 실제 Side Effect가 큰가
그렇다면 Agent가 판단하더라도 Execution은 분리한다. 직전 글에서 이야기했던 Execution Boundary가 다시 등장한다. Agent는 Action을 제안할 수 있지만 Authorization, Policy, Approval, Idempotency를 통과한 뒤에 Controlled Executor가 실제 시스템을 변경하도록 구성한다.
이를 짧게 정리하면 다음과 같다.
| 문제 | 우선 책임 |
|---|---|
| Interpretation / Classification / Planning | Agent |
| Validation / Routing / Retry / State | Workflow / Application |
| Identity / Authorization / Business Policy | Application / Runtime |
| Side Effect | Controlled Executor |
중요한 것은 이 표를 제품 이름으로 외우는 것이 아니다. 시스템마다 기술 스택은 달라진다. n8n일 수도 있고, Step Functions일 수도 있고, Java/Spring이나 Node.js Backend일 수도 있다.
책임의 성격을 먼저 나누고 구현 기술을 나중에 고르는 것이 더 중요하다.
Agent 시대에도 Workflow는 사라지지 않는다
Reasoning Model이 더 좋아지고 Agent Harness가 더 강력해질수록 Workflow가 없어질 것이라고 생각하기 쉽다.
내 경험은 오히려 반대에 가깝다.
Agent가 할 수 있는 일이 늘어날수록, 무엇을 굳이 Agent에게 맡기지 않을 것인지가 더 중요해졌다.
Uncertainty
→ Agentic Reasoning

Certainty
→ Deterministic Control
결정론적인 Layer가 존재한다고 해서 Agent의 자율성을 억제하는 것은 아니다. 오히려 Boundary가 명확할수록 Agent는 실제로 잘하는 일에 더 많은 자유를 가질 수 있다. 불필요한 Tool 선택과 반복적인 Policy 판단에 Token을 쓰지 않아도 되고, 실행 실패를 Reasoning으로 복구하려 하지 않아도 된다.
PoC에서도 마찬가지다. n8n으로 빠르게 연결해 보는 이유는 n8n을 Enterprise Production의 최종 답으로 정하기 위해서가 아니다. 어디가 Reasoning이고, 어디가 Contract이며, 어떤 Rule이 Production에서 Code로 굳어져야 하는지를 빨리 발견하기 위해서다.
처음 Agent를 실험할 때 내 질문은 이랬다.
“Agent에게 어디까지 맡길 수 있을까?”
지금은 먼저 이렇게 묻는다.
“여기에서 Agent의 판단이 정말 필요한가?”
좋은 Enterprise Agent Architecture는 Agent에게 얼마나 많은 일을 맡겼는지로 평가하기 어렵다. 확률적 판단이 필요한 영역과 예측 가능한 동작이 필요한 영역을 얼마나 정확하게 분리했는지, 그리고 그 경계를 빠른 PoC에서 실제 Production Architecture까지 얼마나 일관되게 가져가는지가 더 중요하다.