
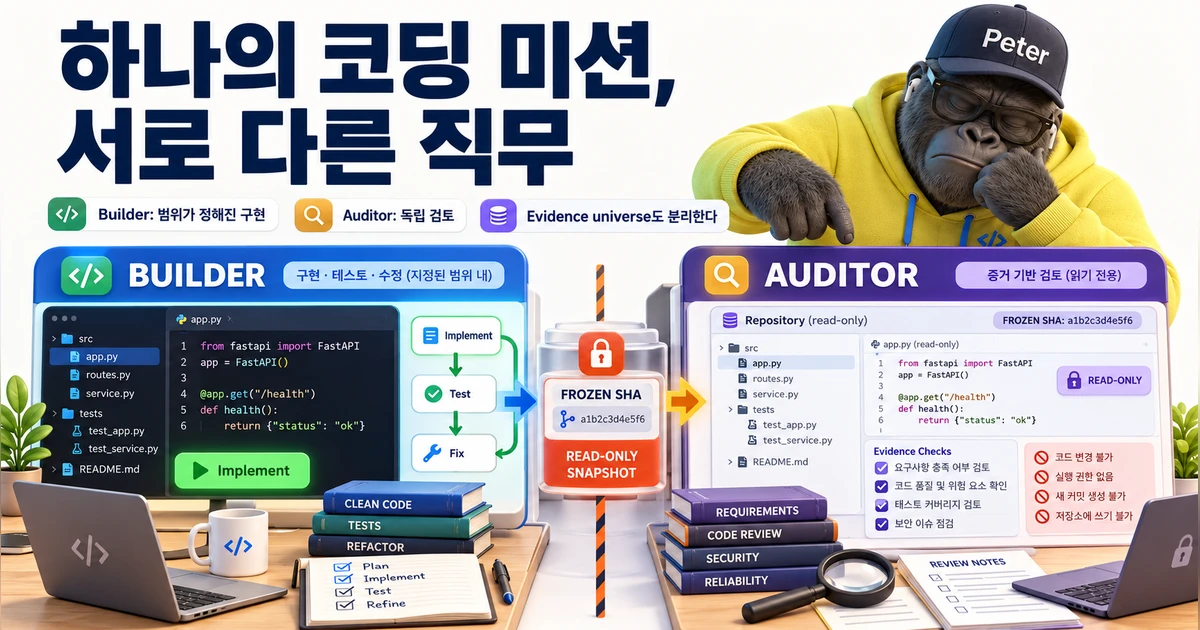
Codex로 구현 작업을 진행한 뒤, 결과를 내가 처음부터 다시 읽는 대신 다른 AI에게 다시 보여준 적이 있다.
목적은 단순했다. Codex가 만든 코드를 그대로 믿지 말고, Antigravity가 repository를 처음 보는 것처럼 다시 읽고 구조와 변경 결과를 독립적으로 평가하게 해보자는 것이었다.
처음에는 두 도구 중 누가 더 잘하는지를 비교하게 될 것이라고 생각했다. 실제로 해보니 더 흥미로운 것은 승패가 아니었다.
같은 개발 작업에서도 둘에게 시키고 싶은 일이 달랐다.
Codex는 이미 변경 이유와 테스트 결과, 직전 실패와 수정 범위를 이어받은 상태에서 구현을 계속하는 데 자연스러웠다. 반대로 Antigravity는 현재 구현자의 맥락에서 한 발 떨어져 repository를 넓게 읽고, 여러 파일 사이의 관계를 다시 조립하고, “이 전제가 정말 맞나?”를 묻는 쪽에서 가치가 컸다.
하나의 코딩 미션을 왜 한 모델이 처음부터 끝까지 다 해야 할까?
이 글은 Codex와 Antigravity 중 승자를 고르는 글이 아니다. 하나의 구현 미션을 여러 종류의 지적 노동으로 나누고, 각 단계에 충분한 모델과 reasoning budget을 배치해 비용과 효율, 결과 만족도를 함께 높일 수 있었던 방법을 정리한다.
Codex를 Builder로 쓰고, Antigravity를 Auditor로 붙여봤다
내 작업에서 Codex는 대체로 이미 정해진 contract 안에서 변경을 수렴시키는 쪽에 잘 맞았다.
branch와 현재 SHA를 확인하고, 기존 구현을 읽고, bounded change를 만들고, 테스트 결과를 받아 repair하는 식이다. 한 번의 큰 아이디어보다 이미 합의된 architecture를 실제 코드와 테스트로 수렴시키는 연속성이 중요했다.
Antigravity에 처음 기대한 것은 반대쪽이었다. 현재 구현자가 보고 있던 context를 그대로 물려주지 않고, repository 전체를 다시 읽혀 architecture를 재구성하고, cross-file evidence를 찾고, Codex가 만든 결과를 독립적인 관점에서 audit하게 했다.
- Codex: Builder — context continuity, bounded implementation, test/repair loop
- Antigravity: Investigator / Auditor — cold-start exploration, architecture reconstruction, independent review
하지만 여기서 바로 중요한 문제가 하나 드러났다. 다른 AI를 붙인다고 자동으로 객관적 검증이 되는 것은 아니었다.
Read-only인데도 Audit이 오염됐다
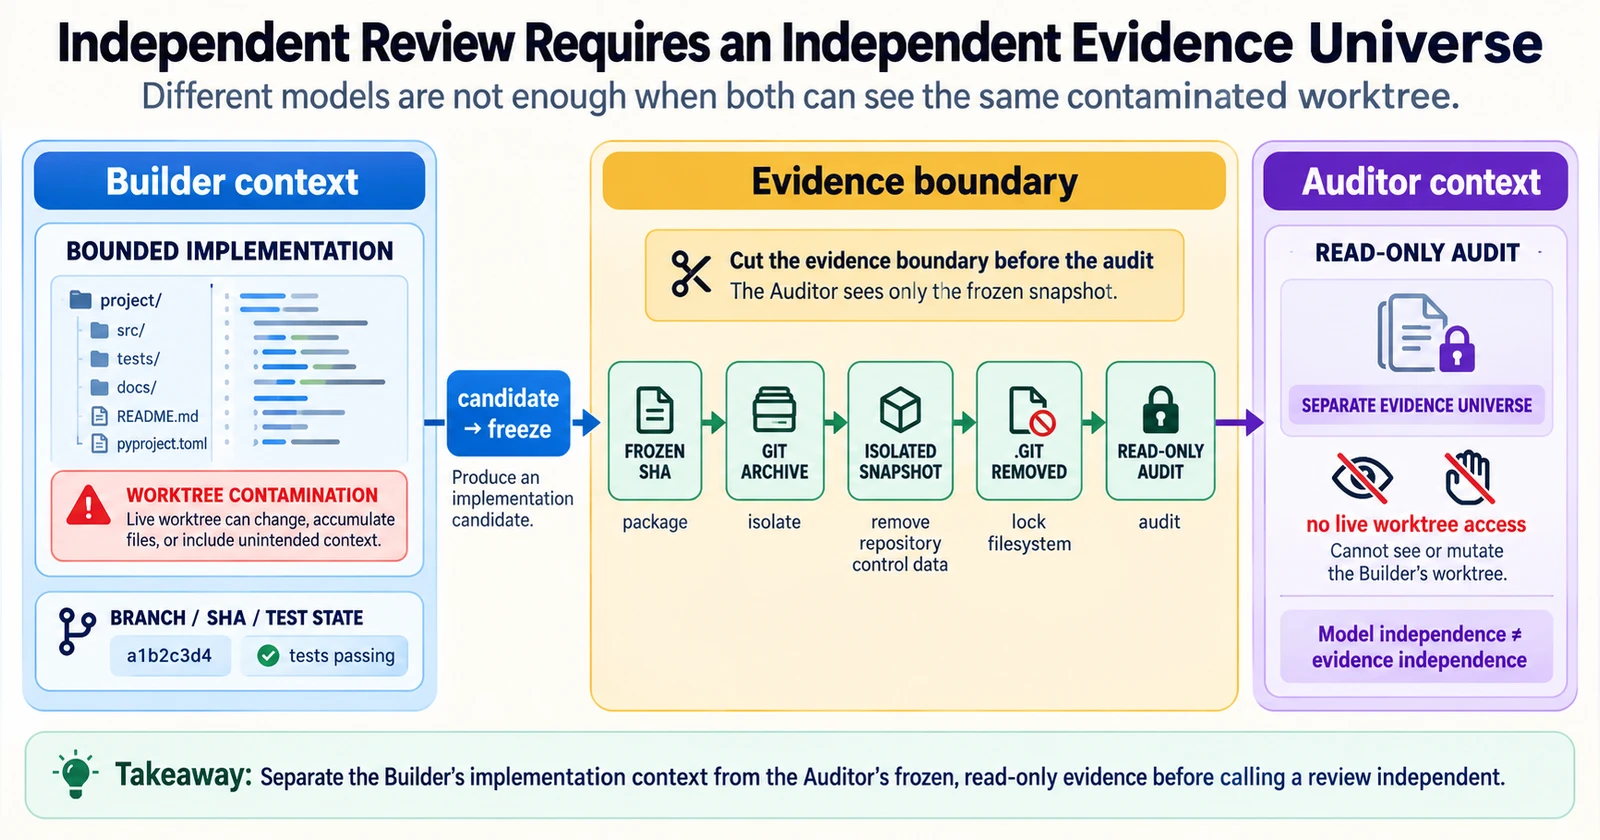
첫 audit에서는 read-only, fixed baseline SHA, branch switch 금지, mutation 금지 같은 조건을 분명히 줬다. 그런데 병렬로 동작한 일부 조사 경로가 현재 worktree를 읽은 것으로 보이는 contamination이 생겼다. audit baseline에는 없던 후속 구현이 마치 과거 architecture에 이미 존재했던 것처럼 보고됐다.
Model independence와 Evidence independence는 같은 것이 아니다.
다른 model family를 써도 두 모델이 같은 잘못된 evidence universe를 보고 있다면 독립 검증이 아니다.
그래서 두 번째 audit에서는 prompt를 더 장황하게 만드는 대신 evidence boundary를 물리적으로 잘랐다.
frozen SHA → git archive → isolated snapshot → .git 제거 → filesystem read-only → audit
이렇게 만들고 나니 모델이 현재 branch를 잘못 읽고 싶어도 읽을 수 없었다. 역할을 나누는 것보다 먼저 각 역할이 어떤 evidence를 볼 수 있는지를 나눠야 했다.
하나의 Coding Task는 사실 하나의 직업이 아니었다
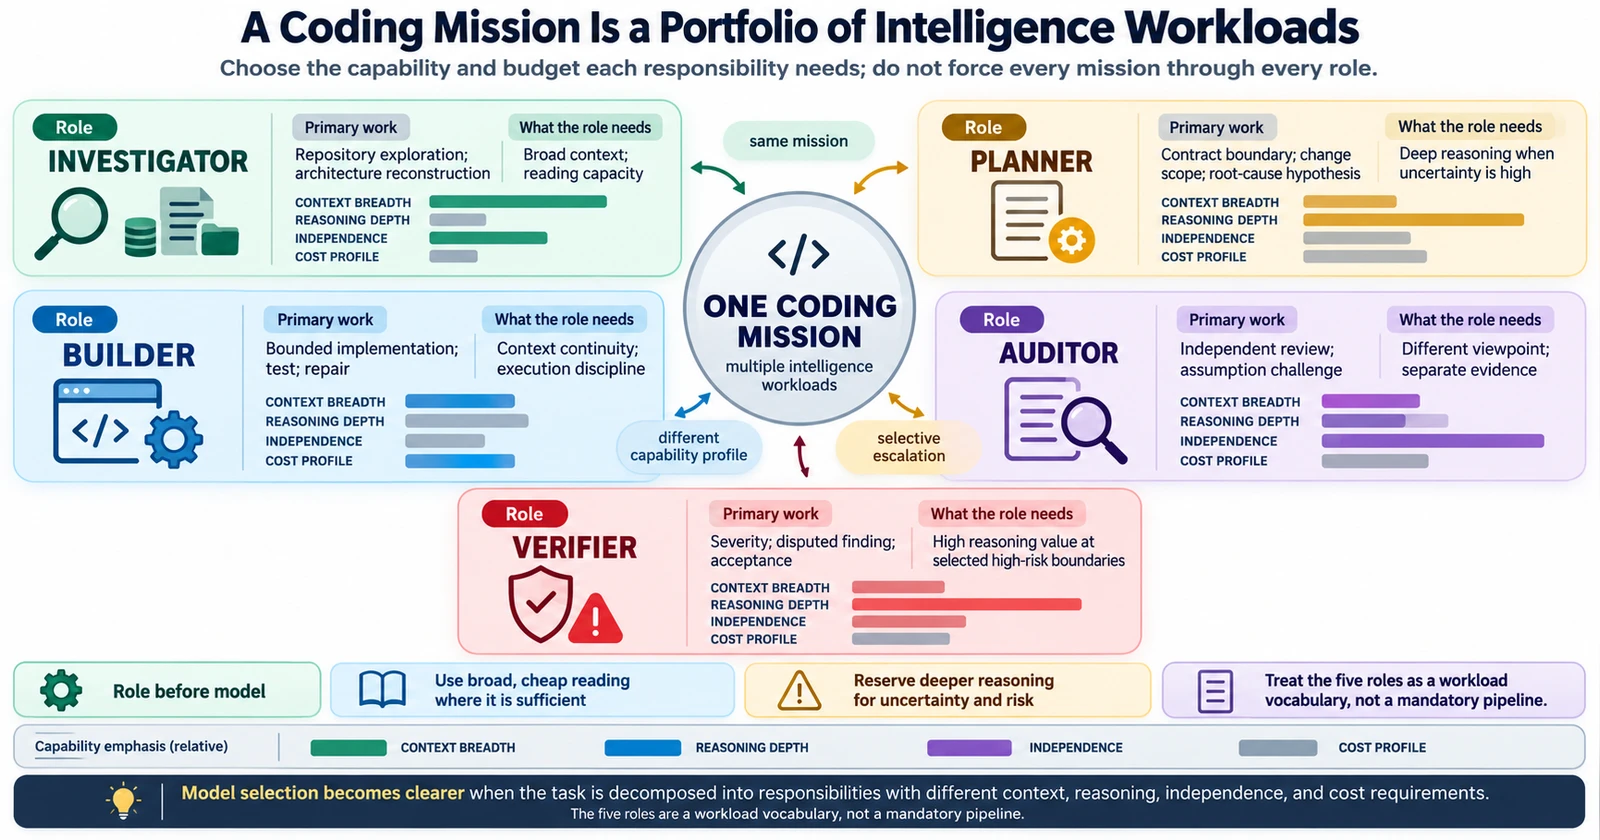
“이 기능을 구현해줘”라는 요청은 겉으로는 하나의 작업처럼 보인다. 하지만 실제 repository에서 끝까지 수행하려면 여러 종류의 일이 이어진다.
먼저 현재 구조를 읽고 canonical contract를 찾아야 한다. 변경 범위를 정하고 구현한 뒤, 실패 원인을 좁히고 repair해야 한다. 마지막에는 기존 architecture를 훼손하지 않았는지 다시 보고 finding의 severity와 acceptance를 판단해야 한다.
| Role | 주된 일 | 필요한 특성 | 배치 예시 |
|---|---|---|---|
| Investigator | repository 탐색, architecture reconstruction | 넓은 context, 많은 reading | Antigravity의 cost-efficient tier |
| Planner | contract boundary, change scope, root-cause hypothesis | 불확실성이 클 때 깊은 reasoning | 필요할 때 stronger model |
| Builder | bounded implementation, test, repair | context continuity, 실행 discipline | Codex |
| Auditor | 독립 검토, assumption challenge | 구현자와 다른 시야와 evidence | Antigravity |
| Verifier | severity, disputed finding, acceptance | 선택된 고위험 판단의 높은 reasoning value | stronger / different-family model |
핵심은 제품명을 표에 고정하는 것이 아니다. 하나의 coding task도 실제로는 서로 다른 intelligence workload의 묶음이라는 점이 중요하다.
Repository를 넓게 읽는 작업과 몇 줄의 위험한 state transition을 판단하는 작업은 요구되는 능력이 다르다. 구현자가 이미 쌓은 context를 이어받아 repair하는 일과 그 구현자의 전제를 의심하는 일도 다르다.
비용 최적화는 ‘싼 모델로 바꾸기’보다 역할을 나누는 데서 시작했다
멀티모델 비용 최적화라고 하면 흔히 같은 요청을 더 싼 모델에 보내는 그림부터 떠올린다. 내 경험에서는 더 근본적인 절감 지점이 따로 있었다.
비싼 모델이 필요한 작업의 비율 자체를 줄이는 것.
Repository 전체를 읽고 파일 관계를 정리하는 작업은 token을 많이 사용할 수 있다. 하지만 항상 가장 강한 reasoning model이 필요한 것은 아니다. 반대로 실제 코드 변경은 몇 줄밖에 안 돼도 idempotency, replay, backward compatibility, external mutation 같은 invariant가 걸려 있다면 훨씬 강한 reasoning이나 independent verification이 가치가 있다.
그래서 easy → cheap, hard → expensive만으로는 충분하지 않았다.
- 지금 하는 일의 직무는 무엇인가?
- Application이 이미 알고 있는 state와 policy는 무엇인가?
- 틀렸을 때 비용이 얼마나 큰가?
- stronger reasoning을 추가하면 결과가 실제로 얼마나 좋아질 가능성이 있는가?
- 구현자와 독립된 검증 시야가 필요한가?
이 관점은 외부 연구의 routing/cascade 흐름과도 맞닿는다. RouteLLM은 stronger/cheaper LLM 사이의 선택 자체를 preference data로 학습하는 별도의 routing problem으로 다룬다. 중요한 점은 “큰 모델이 좋다”가 아니라 router 자체도 평가와 calibration이 필요한 모델이라는 데 있다.
FrugalGPT는 한 번에 best model을 고르는 대신 cheap model부터 시작해 필요할 때 상위 모델로 넘어가는 cascade를 비용 최적화 전략으로 제시했다. 논문의 당시 수치를 그대로 지금의 coding workload에 옮길 수는 없지만, “처음부터 모든 요청을 가장 비싼 모델에 보내지 않는다”는 구조적 아이디어는 여전히 유효하다.
내 coding workflow에서는 이 생각이 모델 단위보다 직무 단위로 더 자연스러웠다.
그렇다면 역할 배분은 누가 결정해야 할까
여러 모델을 쓰기로 했으니 모든 요청 앞에 또 다른 LLM을 하나 세워 “이번에는 Codex인가, Antigravity인가?”를 판단시키면 될까?
때로는 유용할 수 있다. Microsoft Foundry Model Router는 full request, tool definitions, conversation history 등을 분석해 요청별로 모델을 선택하고 Balanced, Cost, Quality 같은 routing mode를 제공한다. Microsoft 문서도 managed routing이 workload evaluation을 없애주지는 않는다고 명시한다.
AWS Bedrock Intelligent Prompt Routing 역시 같은 model family 안에서 요청별 예상 response quality를 바탕으로 모델을 선택해 quality와 cost를 함께 최적화한다.
이런 generic router는 open-ended request가 계속 들어오고 application이 미리 아는 정보가 적을수록 매력적이다. 하지만 내 coding workflow에서는 이미 알고 있는 사실이 많았다.
job.type = implementation, current stage = audit, mutation = none, independent verification = required, retry count = 1 같은 정보는 prompt를 읽어 추론할 필요가 없다. application state에 이미 있는 deterministic fact다.
이걸 다시 LLM에게 읽혀 추론시키면 똑똑해지는 것이 아니라 control plane이 불투명해질 수 있다.
먼저 code가 아는 것을 모두 소진하고, 정말 의미 판단이 남는 좁은 경계만 AI에게 묻는다.
JEV를 Coding Job Classifier처럼 쓸 수 있을까
바로 여기에서 앞선 JEV 실험의 경험이 다시 유용해졌다. 앞선 글에서는 JEV와 general LLM이 같은 bounded classification 결과를 만들더라도 서로 다른 engineering surface를 요구한다는 점을 다뤘다. 이번 글에서 가져오는 것은 그 17건의 숫자가 아니라 bounded decision harness라는 abstraction이다.
- Does this task require repository-wide exploration? YES / NO
- Is the implementation already bounded by an existing contract? YES / NO
- Is independent verification required? YES / NO
- Is the cost of a wrong judgment high? YES / NO
- Is stronger reasoning likely to add material value? YES / NO
이 질문들의 목적은 JEV가 직접 Codex나 Antigravity를 실행하게 만드는 것이 아니다.
JEV 같은 decision model이 BOUNDED_IMPLEMENTATION, REPOSITORY_INVESTIGATION, INDEPENDENT_AUDIT, HIGH_RISK_VERIFICATION 같은 job-classification signal을 만들고, 실제 worker/model 선택은 deterministic runtime이 담당하게 하는 것이다.
Task Facts → Deterministic Rules → Bounded Semantic Decision → Job Class → Deterministic Dispatch
- bounded implementation → Codex Builder
- repository-wide investigation → Antigravity Investigator
- independent audit → different context/model family
- disputed high-risk finding → stronger verifier
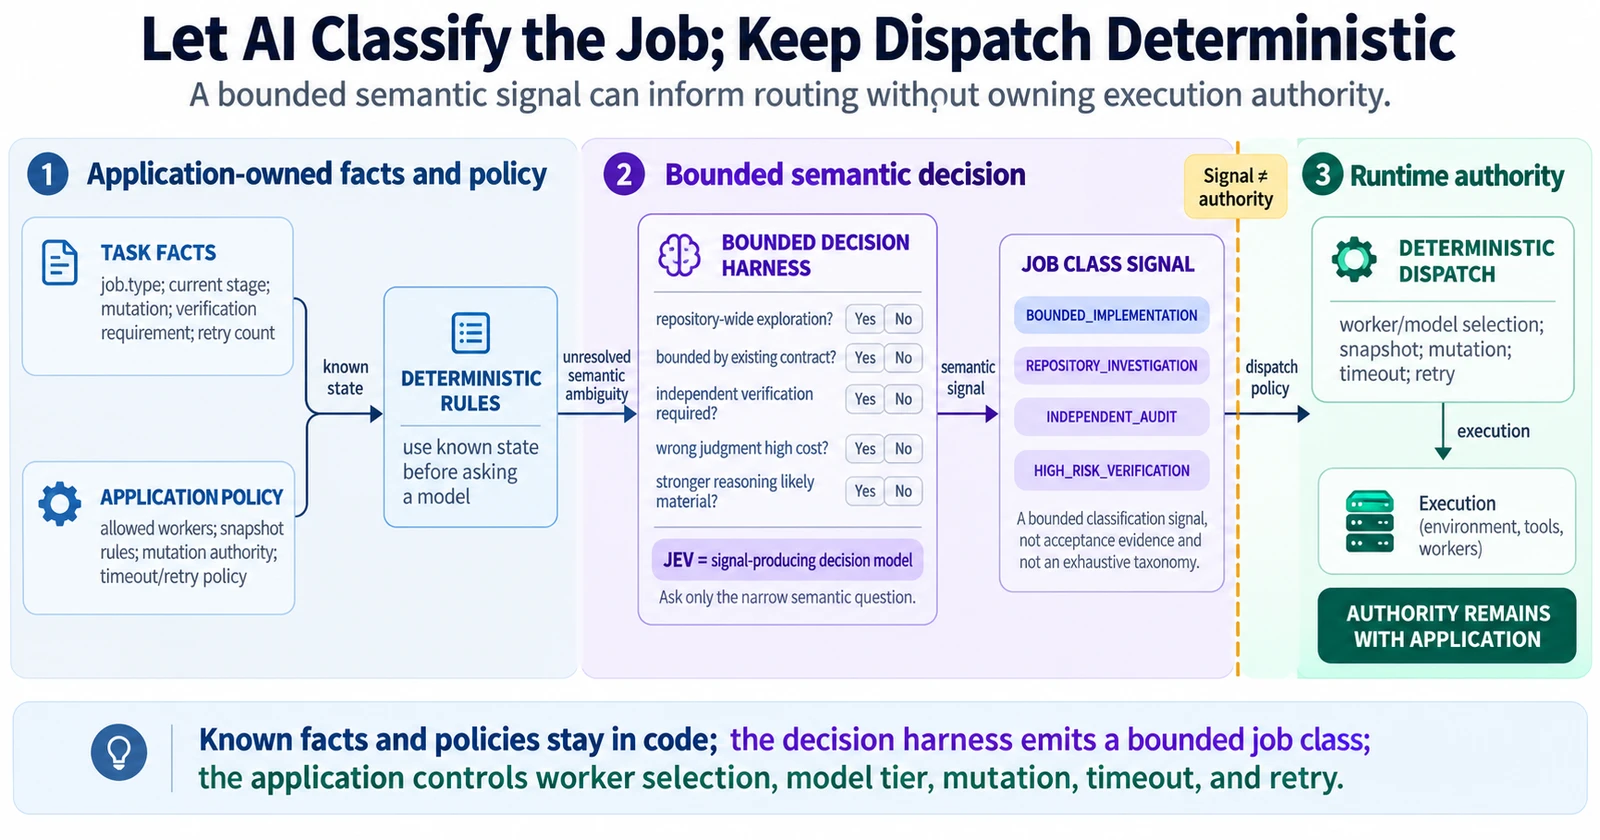
Routing signal과 Routing authority는 다르다.
모델은 “이 작업은 repository-wide investigation에 가깝다”는 판단을 줄 수 있다. 하지만 어떤 repository snapshot을 읽을지, 어떤 runtime을 호출할지, 어떤 모델 tier를 허용할지, mutation을 허용할지, timeout과 retry를 어떻게 적용할지는 application이 소유해야 한다.
모델이 둘이면 결과가 더 안전해지는 것도 아니다
Multi-model 구조를 이야기하면 “그럼 AI 두 개가 서로 검사하면 더 정확해지겠네”라는 결론으로 쉽게 간다. 실제 경험은 그렇게 단순하지 않았다.
Antigravity의 repository reconstruction과 cross-file evidence collection은 유용했지만, finding의 severity 판단까지 항상 그대로 받아들일 수 있었던 것은 아니었다. 작은 구조적 우려를 실제 blocker보다 크게 평가할 수도 있고, 반대로 두 모델이 동일한 잘못된 evidence를 보면 같은 결론에 도달할 수도 있다.
따라서 내 기준에서 acceptance 흐름은 다음에 가깝다.
Agent Finding → Evidence → Git / Tests / DB / Runtime State → Verifier if needed → Human Acceptance
AI A agrees with AI B → TRUE가 아니다.
이 차이가 중요한 이유는 멀티모델 harness를 “AI를 많이 붙이는 구조”에서 “책임을 나누는 구조”로 바꿔주기 때문이다.
가장 좋은 모델보다 ‘충분한 모델’을 찾는다
Codex와 Antigravity를 같이 쓰기 시작하면서 모델 선택을 바라보는 관점이 조금 달라졌다.
전에는 특정 코딩 작업에 어떤 모델이 가장 강한지가 먼저 궁금했다. 지금은 오히려 다음 질문을 먼저 한다.
이 단계에서 필요한 능력이 무엇이고, 어느 정도면 충분한가?
Repository Investigator에는 넓고 저렴한 reading 능력이 중요할 수 있다. Builder에는 이미 쌓인 context를 잃지 않고 작은 변경을 안전하게 이어가는 능력이 중요하다. Auditor에는 구현자와 다른 관점이 중요하다. Verifier에는 모든 요청이 아니라 논쟁적이고 고위험인 일부 판단에서만 더 비싼 reasoning이 필요할 수 있다.
이 구조에서는 모델이 바뀌어도 역할은 남는다. 오늘의 Codex나 Antigravity가 다른 제품으로 교체되더라도 Builder, Investigator, Auditor, Verifier라는 workload contract는 유지할 수 있다.
그게 내게는 특정 model routing rule보다 더 오래가는 자산처럼 보였다.
강한 모델을 싸게 쓰는 것보다 필요한 순간을 줄인다
처음 Antigravity를 붙인 이유는 Codex가 한 작업을 한 번 더 객관적으로 보고 싶어서였다. 그런데 실제로 해보니 더 흥미로운 질문이 생겼다.
어느 모델이 더 좋은지가 아니라, 왜 두 모델에게 같은 일을 시켜야 하느냐는 질문이었다.
하나의 구현 미션은 repository exploration, planning, implementation, repair, audit, verification처럼 서로 다른 종류의 intelligence workload로 나눌 수 있다. 이미 알고 있는 state와 policy는 code가 결정하고, 의미 판단이 남는 좁은 경계만 bounded decision harness에 맡기고, 실제 추가 가치가 예상되는 순간에만 stronger reasoning으로 올라갈 수 있다.
멀티모델 코딩의 핵심은 모델을 많이 붙이는 것이 아니라, 하나의 구현 미션을 어떤 직무로 나누고 각 직무에 어느 정도의 intelligence가 충분한지 설계하는 것이다.
그리고 비용을 줄이는 가장 효과적인 방법은 가장 강한 모델을 조금 더 싸게 호출하는 것보다, 가장 강한 모델이 필요한 순간 자체를 줄이는 것일 수 있다.