
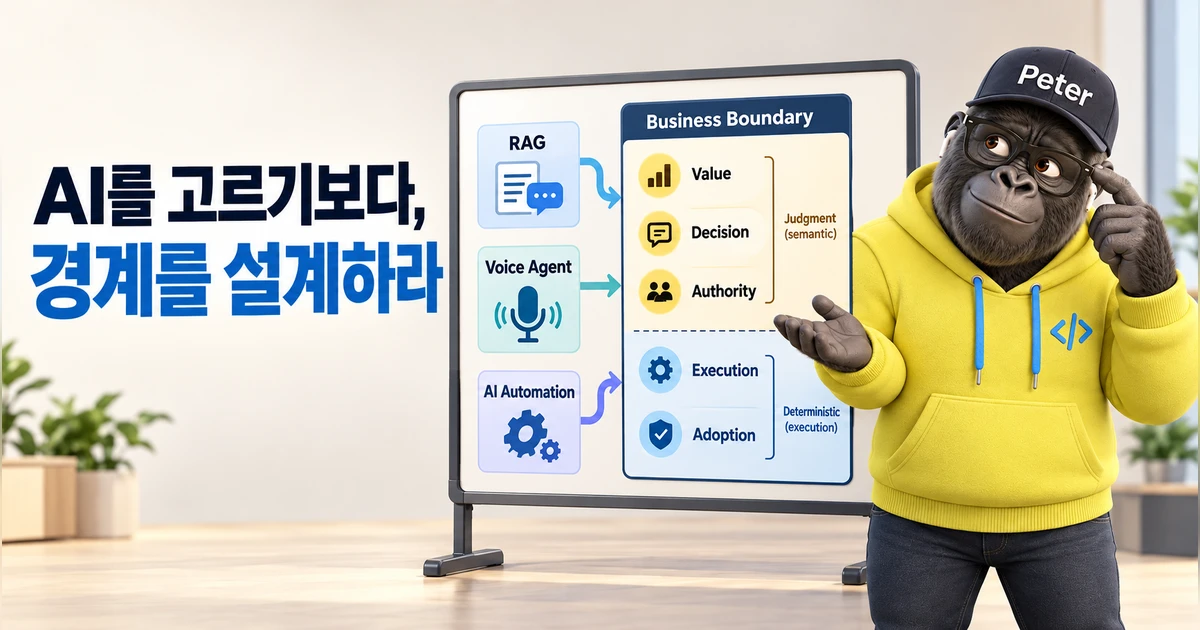
몇 년 전만 해도 AI 프로젝트 미팅에서 가장 먼저 나오는 질문은 꽤 기술적이었다. 어떤 모델을 쓸지, RAG를 붙일지, Agent로 만들지, Workflow를 어디까지 자동화할지 같은 질문이었다.
지금은 모델도 좋아졌고 선택지도 훨씬 많아졌다. 오히려 그래서 나는 첫 질문을 기술에서 시작하지 않게 됐다.
프로젝트마다 고객이 쓰는 표현은 달랐지만, 요구를 한 줄로 줄이면 비슷했다.
“RAG를 붙이면 영업에 필요한 정보를 알아서 잘 찾을 수 있죠?”
“Voice Agent가 통화하고 CRM까지 업데이트하면 사람 손이 거의 안 가는 것 아닌가요?”
“분류 정확도가 90%가 넘었으면 이제 자동화해도 되지 않나요?”
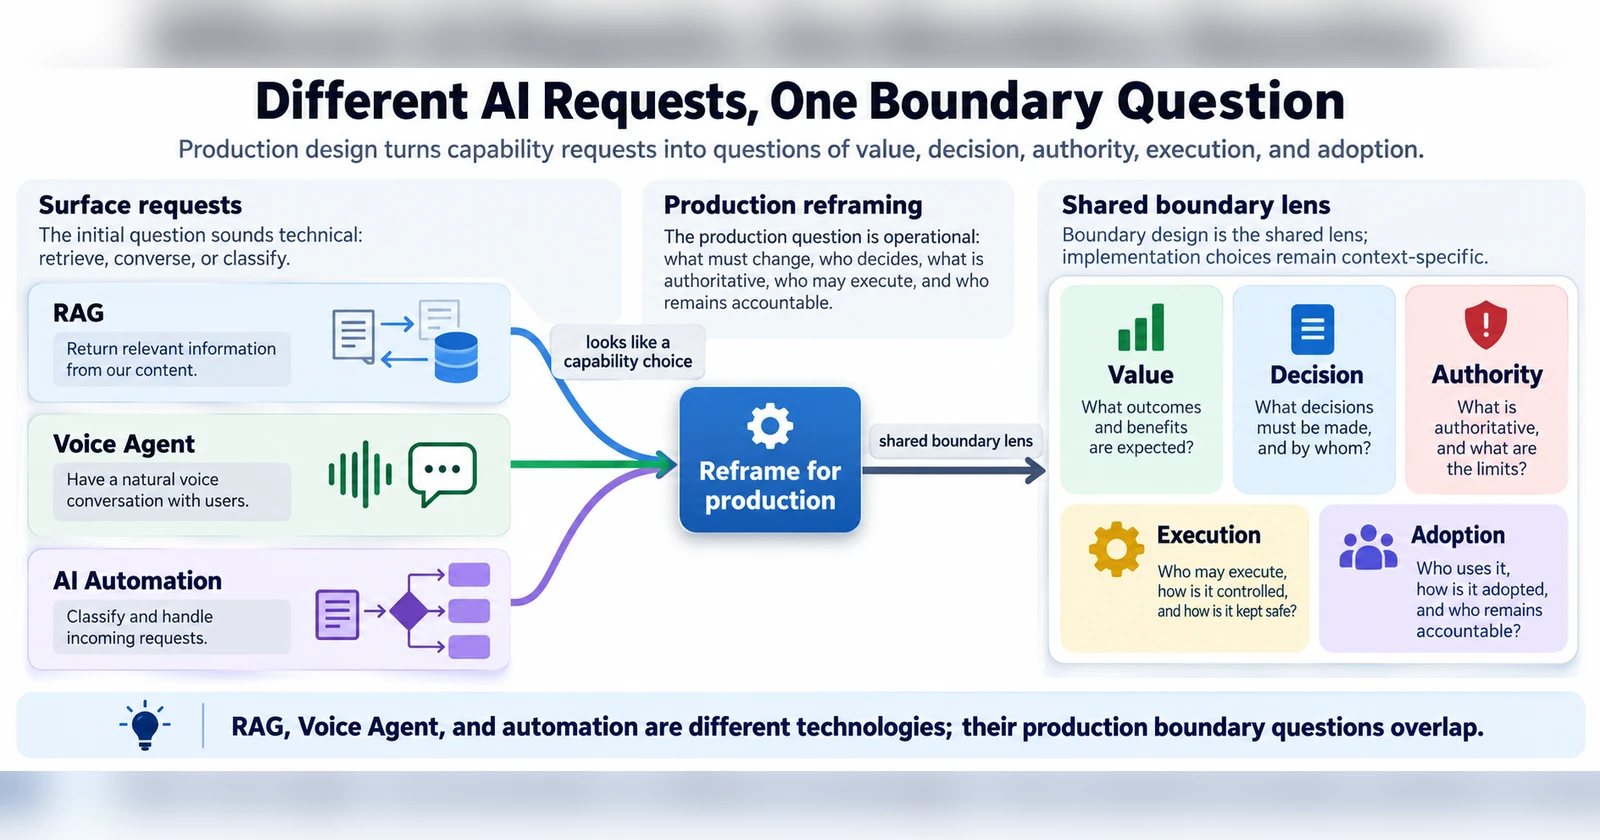
셋 다 처음 들으면 기술 질문처럼 보인다. Retrieval 품질, 음성 모델, 분류 정확도 문제로 보인다. 그런데 실제 설계에 들어가면 곧 다른 질문이 튀어나온다.
이번 Deal에서 어떤 정보까지 검색할 자격이 있는가. 통화가 성공했는지 애매할 때 CRM의 상태는 누가 결정하는가. 90%가 맞는 모델이 틀린 10%에서 고객정보나 계약 관련 상태를 잘못 바꿔도 되는가.
나는 이 지점부터 기술 선정 회의가 AX 설계 회의로 바뀐다고 생각한다.
RAG 프로젝트에서 먼저 해결해야 했던 것은 검색이 아니었다
B2B 영업을 오래 해보면 정보가 부족해서만 일이 어려운 것이 아니라는 걸 알게 된다. 자료는 오히려 넘친다. 시장 보고서, 제품 자료, 과거 제안서, CRM 기록, 고객 이메일, 경쟁사 자료가 계속 쌓인다.
문제는 그중 무엇이 지금 이 Deal의 판단을 바꿀 만큼 중요한지다.
나도 Enterprise RAG를 처음 볼 때는 검색 품질부터 생각했다. 검색 recall을 높이고, 문서를 잘 chunking하고, embedding을 잘 선택하면 답이 좋아질 거라고 생각하기 쉽다. 물론 필요하다. 하지만 실제 업무에 붙이면 한 단계 앞의 문제가 나온다.
어떤 고객의 RFP를 보고 있는데 시스템이 관련성이 높은 시장 보고서와 과거 제안서를 찾아왔다고 해보자. 둘 다 문맥상 그럴듯하다. 그런데 현재 계약 조건은 ERP나 계약 저장소에 있고, 고객의 최신 조직 정보는 CRM에 있다. 검색 결과와 System of Record가 다르면 무엇을 믿어야 할까.
여기서 top-1 retrieval 결과를 곧바로 사실로 취급하면 RAG는 검색은 잘하면서 업무는 틀릴 수 있다.
그래서 질문이 바뀌었다.
“어떤 vector DB가 좋은가?”가 아니라 “이번 업무에서 어떤 정보가 결정을 바꿀 자격이 있고, 충돌할 때 어떤 source가 이기는가?”
내가 최근 Deal Context와 Market Lens를 따로 설계하게 된 이유도 비슷하다. 모든 지식을 많이 가져오는 것이 목적이 아니라, 지금 의사결정에 필요한 정보의 범위를 먼저 줄이고 그 안에서 authority와 relevance를 구분하는 것이 더 중요했다.
이 경험을 지금의 언어로 다시 정리하면 두 가지 계약이 빠져 있었다.
첫째는 Value다. 성공은 “RAG가 답을 생성했다”가 아니라 영업이나 제안 담당자가 material한 evidence를 찾고 판단하는 시간이 실제로 줄어드는 것이다.
둘째는 Authority다. Search relevance는 business truth가 아니다. CRM, 계약 저장소, approved corpus, 외부 Web evidence는 서로 다른 authority를 가진다.
이 경계가 정해지고 나면 retrieval 방식은 오히려 두 번째 문제가 된다.
Voice Agent는 통화가 끝난 뒤부터 더 어려워졌다
음성 AI는 변화 속도를 체감하기 좋은 분야다.
2년쯤 전 Whisper와 n8n을 엮어 음성 Agent PoC를 만들 때는, 사람이 말한 내용을 인식하고 그 결과로 Workflow가 움직인다는 것만으로도 꽤 재미있었다. 지금은 직접 speech-to-speech로 대화하고 tool까지 호출하는 Realtime 계열이 일반적인 선택지가 됐다. OpenAI의 현재 Realtime 문서도 stateful speech-to-speech session과 tool calling을 기본 capability로 설명한다. Ultravox 역시 Telnyx 같은 telephony provider와 직접 연결해 outbound call을 구성할 수 있다.
그런데 최근 실제 아웃바운드 Voice Agent를 CRM 프로세스와 연결하면서 가장 오래 본 것은 음질이나 latency가 아니었다.
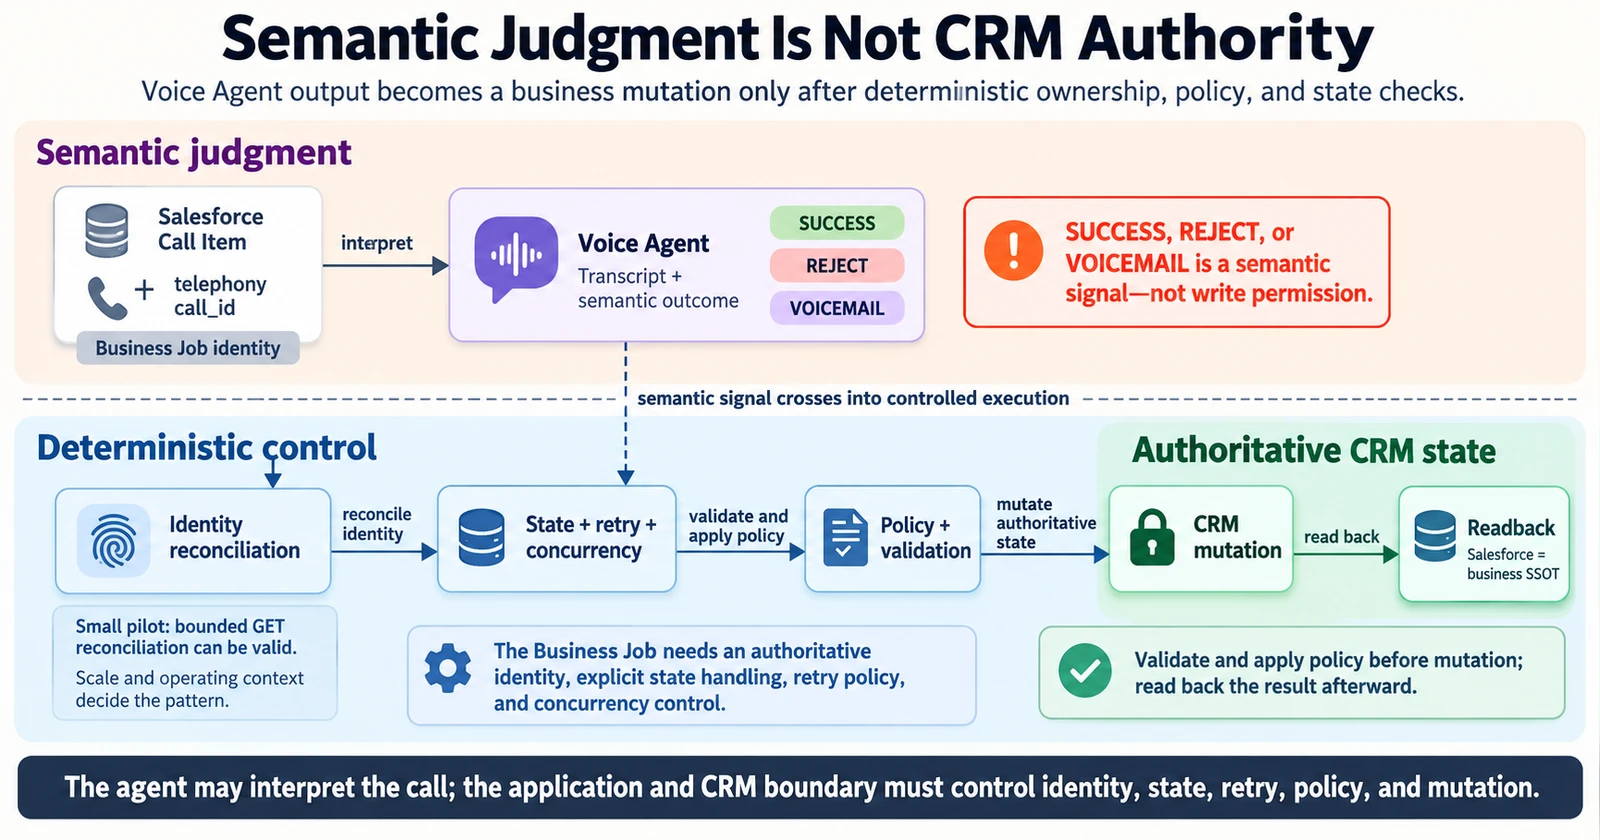
Salesforce에 Call Item이 하나 있다. Scheduler가 실행을 시작한다. 실제 통화가 만들어지면 telephony와 Voice Agent 쪽에는 또 다른 call identity가 생긴다.
그때부터 질문이 쏟아진다.
Salesforce의 어떤 Call Item과 실제 call_id가 같은 업무라는 것을 어떻게 보장할 것인가.
통화는 연결됐는데 transcript가 거의 없다. 상대가 바로 끊은 것인지, voicemail인지, 네트워크 문제인지 애매하다. 이 상태를 실패로 볼 것인가.
다시 전화를 걸어야 한다면 언제 가능한가. 이전 호출은 정말 끝났는가. timeout 때문에 응답만 못 받은 것이라면 같은 side effect를 두 번 만들지 않는다고 어떻게 보장할 것인가.
그리고 가장 중요한 질문이 하나 더 있다.
LLM이 transcript를 보고 SUCCESS라고 판단했다는 사실이 CRM을 업데이트할 권한까지 의미하는가.
내 결론은 아니었다.
LLM은 대화의 의미를 판단하는 데 유용했다. 실제로 SUCCESS, REJECT, VOICEMAIL 같은 semantic classification은 모델이 잘할 수 있는 영역이다. 하지만 canonical Call Item, retry eligibility, concurrency, CRM mutation은 Salesforce와 deterministic runtime이 소유하는 쪽이 훨씬 명확했다.
여기서 재미있는 판단도 있었다.
통화량이 매우 큰 Contact Center라면 event-driven webhook과 전용 middleware가 맞을 수 있다. 하지만 하루 몇 건에서 수십 건 수준의 pilot에서 굳이 public inbound endpoint, webhook authentication, 재전송 처리까지 새로 운영해야 하는지는 다른 문제다.
우리는 Salesforce를 SSOT로 두고 필요한 시점에 API GET으로 상태와 transcript를 reconciliation하는 구조를 택할 수 있었다. “더 실시간이고 더 agentic한 구조”보다 현재 업무 규모와 보안 경계에 맞는 구조가 더 나았다.
Voice Agent를 설계하면서 내가 보게 된 질문은 결국 이것이었다.
Agent가 말을 얼마나 자연스럽게 하는가?
그보다 먼저,
이 통화가 하나의 Business Job이라면 identity, state, retry, final mutation은 누가 소유하는가?
정확도가 좋아졌는데 자동화 범위는 오히려 줄여야 했던 순간
분류 PoC는 성공을 보여주기 쉽다.
샘플 데이터를 넣고 결과를 보면 꽤 잘 맞는다. 90%, 95%, 때로는 그 이상이 나온다. 그러면 자연스럽게 이런 질문이 나온다.
“이 정도면 이제 자동으로 처리해도 되지 않나요?”
하지만 Enterprise 업무에서 accuracy와 automation coverage는 같은 숫자가 아니다.
FAQ 문의를 잘못 분류한 것은 다시 라우팅하면 끝날 수 있다. 반면 계약 조건을 잘못 판단하거나 CRM의 중요한 field를 잘못 바꾸면 이야기가 달라진다. 고객에게 잘못된 안내가 나갈 수도 있고, 다음 프로세스가 틀린 상태를 사실로 믿고 움직일 수도 있다.
같은 5% 오류라도 business consequence가 다르다.
그래서 어느 순간부터 모델의 confidence를 자동화 권한으로 직접 사용하지 않게 됐다.
모델은 판단 결과와 signal을 준다. Application은 validation evidence와 business risk를 보고 AUTO, VERIFY, REVIEW 같은 operational authority를 부여한다.
이 차이는 작아 보이지만 운영 구조를 크게 바꾼다.
정확도는 모델의 성능지표다.
자동화율은 업무의 위험정책이다.
둘은 같은 숫자가 아니다.
여기서 사람의 역할도 달라진다.
Human-in-the-loop를 “AI가 틀리면 사람이 대신한다” 정도로 두면 오래 운영하기 어렵다. 누가 어떤 risk class를 검토할지, override할 수 있는지, 왜 override했는지, correction을 어디에 남길지까지 정해야 한다.
NIST AI RMF가 human-AI configuration의 역할과 책임, human oversight를 명시적으로 정의하고 문서화해야 한다고 보는 것도 이 지점과 닿아 있다. 중요한 것은 사람을 마지막 안전장치로 써 놓는 것이 아니라, 사람의 책임을 운영 구조 안에 넣는 것이다.
프로젝트는 달랐는데 질문은 비슷했다
RAG, Voice Agent, AI classification은 기술적으로 전혀 다른 프로젝트다.
그런데 몇 번 반복해서 설계하다 보니 내가 던지는 질문은 비슷해졌다.
RAG에서는 “무엇을 검색할까?”보다 “무엇이 지금 의사결정에 material하고 어떤 source가 authority인가?”를 묻게 됐다.
Voice Agent에서는 “얼마나 자연스럽게 말할까?”보다 “통화라는 Business Job의 상태와 mutation을 누가 소유하는가?”를 묻게 됐다.
분류 자동화에서는 “몇 % 맞는가?”보다 “어떤 오류까지 자동 실행할 수 있는가?”를 묻게 됐다.
뒤늦게 이 질문들을 정리해 보니 다섯 묶음으로 수렴했다.
나는 이것을 Value, Decision, Authority, Execution, Adoption이라고 부르고 있다.
업계 표준 방법론이라는 뜻은 아니다. 여러 PoC와 productionization 과정에서 같은 실수를 반복하지 않기 위해 내가 사용하는 실전 체크 프레임에 가깝다.
1. Value — 무엇을 만들지가 아니라 무엇이 달라져야 하는가
“Agent를 만든다”는 성공 기준이 아니다.
처리시간을 얼마나 줄일 것인지, 사람의 triage effort를 얼마나 줄일 것인지, 오류 비용을 얼마나 줄일 것인지가 먼저다.
여기서 baseline과 target이 없으면 PoC는 쉽게 데모 성공으로 끝난다.
2. Decision — AI가 정말 판단해야 하는 지점은 어디인가
모든 단계를 Agent에게 넘기기 전에 업무를 쪼개 본다.
문장을 해석하고, 비교하고, 분류하고, 요약하고, 애매한 선택지 중 하나를 고르는 일에는 LLM의 semantic judgment가 도움이 된다.
반면 schema validation, 권한 확인, 계산, persistence, serialization, state transition처럼 같은 valid input/state에서 같은 결과가 나와야 하는 일은 deterministic하게 두는 편이 낫다.
핵심은 Agent를 많이 쓰는 것이 아니라 uncertainty가 실제로 존재하는 decision grain을 찾는 것이다.
3. Authority — 정보의 위치보다 충돌할 때 누가 이기는가
Enterprise 시스템에는 항상 여러 source가 있다.
CRM, ERP, SharePoint, 이메일, RAG, Web Search가 같은 대상을 서로 다르게 말할 수 있다.
그래서 “데이터가 어디에 있나?”보다 “충돌하면 무엇을 authoritative fact로 볼 것인가?”가 중요하다.
Read authority와 Write authority도 같지 않을 수 있다.
Agent가 읽을 수 있다고 해서 바꿀 수 있는 것은 아니다.
4. Execution — 판단을 어떻게 안전한 상태전이로 바꿀 것인가
AI가 JSON을 잘 만들었다고 업무가 완료된 것이 아니다.
판단 결과가 validation을 통과하고, policy와 approval을 확인하고, legal state transition을 거쳐 mutation되고, 다시 readback되어야 한다.
여기에는 business identity, idempotency, concurrency, precondition, retry, resume, replay, partial failure recovery가 들어간다.
PoC에서 잘 보이지 않지만 Production에서 가장 많은 시간을 쓰게 되는 부분이다.
5. Adoption — 사람을 fallback이 아니라 operating model에 넣는다
“최종적으로 사람이 확인합니다”라는 문장은 설계가 아니다.
누가 확인하는가. 언제 확인하는가. 어떤 risk는 AUTO이고 어떤 경우 VERIFY나 REVIEW인가. 누가 override할 수 있고 어떤 evidence를 남기는가.
그리고 그 correction이 다음 evaluation과 policy 개선에 다시 사용되는가.
이 정도가 정해져야 Human-in-the-loop가 실제 운영 모델이 된다.
그래서 Discovery 미팅에서 요구 문장을 그대로 받지 않는다
고객이 이렇게 말한다고 해보자.
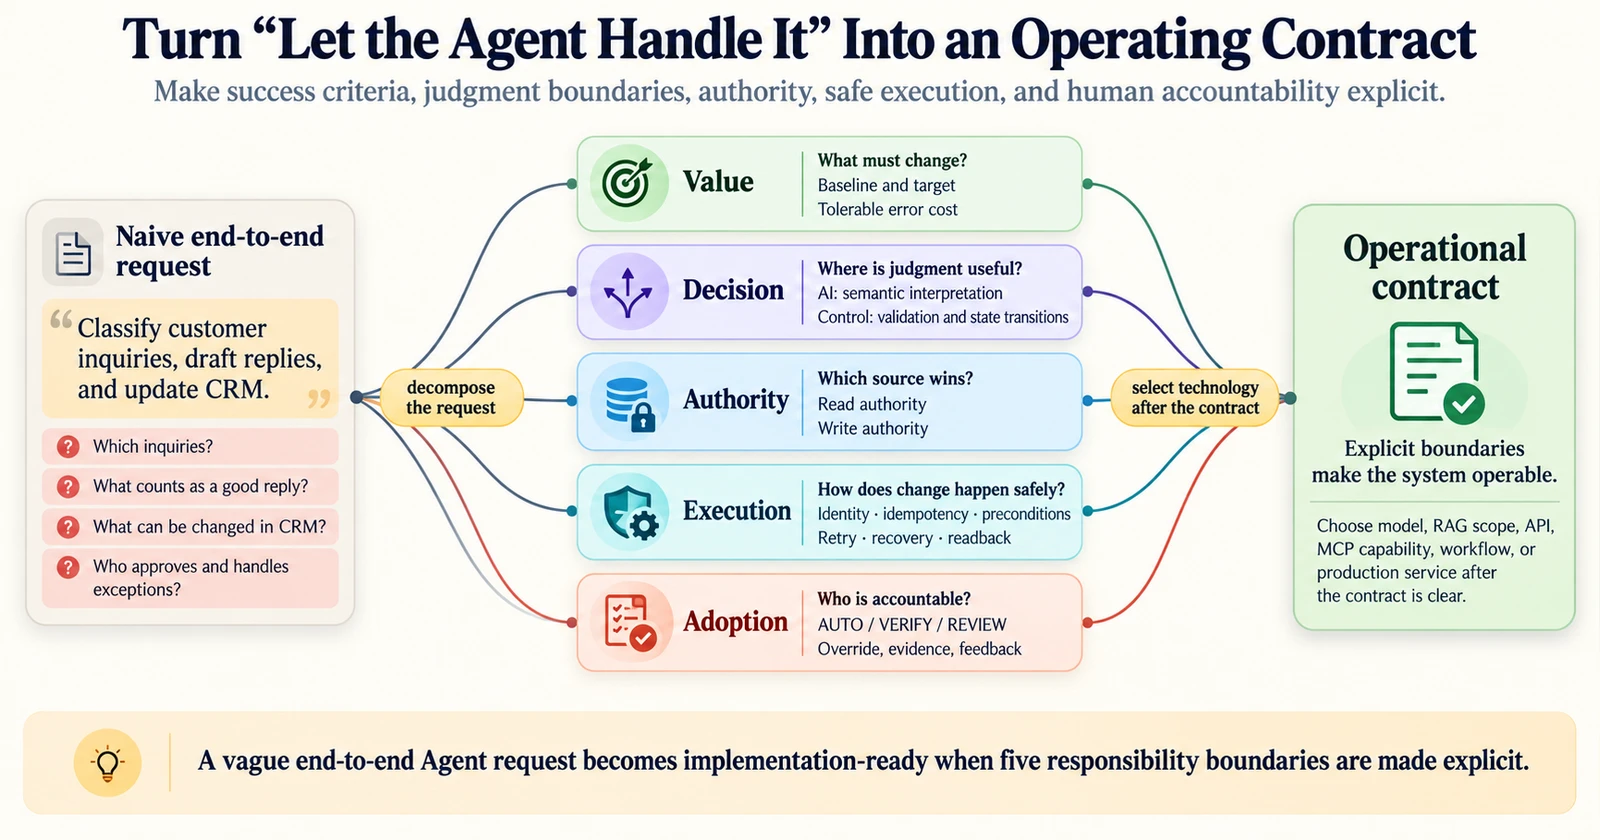
“고객 문의를 Agent가 자동으로 분류하고 답변하고 CRM까지 업데이트하게 해주세요.”
이 문장을 그대로 backlog에 넣으면 너무 많은 것이 생략된다.
Value부터 다시 묻는다. 처리시간이나 triage effort를 얼마나 줄여야 성공인가. Wrong CRM mutation은 어느 정도까지 허용 가능한가.
Decision을 나눈다. Intent classification과 답변 초안은 AI가 맡을 수 있다. Known routing rule, schema validation, permission check, CRM mutation은 deterministic하게 남길 수 있다.
Authority를 정한다. Customer master는 CRM, 제품 스펙은 approved corpus, 계약과 가격은 ERP나 contract authority가 가진다. 이메일 본문은 request context이지 자동으로 canonical customer fact가 되는 것이 아니다.
Execution을 만든다. Case identity와 idempotency를 정의하고 mutation 전에 current state를 확인한다. write 후 readback한다. timeout 뒤에는 blind retry부터 하지 않고 실제 side effect를 먼저 확인한다.
Adoption을 정한다. Low-risk FAQ는 AUTO, 애매한 intent는 VERIFY, 계약이나 가격 관련 mutation은 REVIEW에 둘 수 있다. 사람이 교정한 결과는 evaluation dataset 후보로 남긴다.
같은 요구인데 완전히 다른 설계가 된다.
그리고 이 단계까지 오면 재미있게도 모델 선택은 쉬워진다.
LLM이 필요한 위치가 보이고, RAG가 필요한 범위가 보이고, MCP나 API가 노출해야 할 capability가 보인다. 무엇을 n8n 같은 workflow로 빠르게 검증하고 무엇을 production service로 옮겨야 하는지도 명확해진다.
새 AI가 나올수록 경계 설계가 더 중요해진다
예전에는 새 모델이나 Agent 기능을 보면 “이걸 어느 업무에 넣을 수 있을까?”부터 생각했다.
지금은 질문 순서가 조금 달라졌다.
무엇이 성공인가.
무엇을 AI가 판단해야 하는가.
무엇을 사실로 믿을 것인가.
누가 실행 권한을 가지는가.
실패했을 때 업무가 어떻게 살아남는가.
사람은 어디에서 책임지고 무엇을 다시 시스템에 돌려주는가.
이 질문에 답하고 나면 모델, Agent, RAG, MCP, Workflow를 고르는 일은 오히려 단순해진다.
AX 컨설턴트의 가치는 최신 AI를 가장 많이 아는 데 있지 않다.
새로운 AI를 기존 업무가 감당할 수 있는 경계 안에 넣고, 그 경계가 실제 운영에서도 유지되게 만드는 데 있다.