
Voice Agent를 테스트할 때 처음 본 것은 당연히 대화 품질이었다. 얼마나 빨리 받아치는지, 말을 끊었을 때 제대로 멈추는지, 사람처럼 들리는지를 봤다.
그런데 실제 outbound call을 몇 차례 만들어 보고 나니 관심사는 금방 다른 곳으로 옮겨갔다.
이 번호에 지금 전화를 걸어도 되는가?
생각보다 이 질문이 먼저였다.
고객이 이미 연락을 원하지 않는다고 했는지, 이번 전화가 marketing인지 service call인지, 현지 시간이 허용 범위인지, 어떤 동의를 근거로 연락하는지, 녹음이나 transcript를 남겨도 되는지. 이런 조건을 확인하지 않은 채 일단 scheduler에 번호를 넣고 Voice Agent에게 “규정을 잘 지켜”라고 말하는 것은 production architecture라고 보기 어려웠다.
전화 한 통을 만든다는 것은 이미 외부 세계에 side effect를 발생시키는 일이다.
Part 1에서는 Voice AI의 대화 능력이 빠르게 좋아지면서 Enterprise의 어려운 문제가 speech 자체에서 CRM context, telephony, durable state와 business authority 쪽으로 이동했다고 썼다. 이번에는 그 경계에서 한 단계 더 내려가 보려 한다.
Voice Agent에게 대화할 능력이 있다는 것과 실제 고객에게 연락할 권한이 있다는 것은 다른 문제다.
그리고 통화가 연결된 뒤에는 또 하나의 권한이 생긴다.
고객이 말한 요청을 실제 시스템에 반영해도 되는가?
이 두 질문을 분리하지 않으면 Voice Agent는 금방 “말을 잘하는 모델”에서 “너무 많은 권한을 가진 실행 주체”로 변한다.
Chatbot보다 Voice Agent에서 먼저 보게 되는 것
Text chatbot은 보통 사용자가 먼저 화면을 열고 대화를 시작한다. 물론 chatbot도 개인정보를 다루고 Tool을 실행할 수 있기 때문에 보안 경계가 필요하다.
Outbound Voice Agent는 한 가지가 더 붙는다.
기업이 먼저 실제 사람에게 접촉한다.
PSTN이나 SIP를 통해 전화가 만들어지고, 상대방의 하루에 실제로 끼어든다. Live audio에는 이름, 주소, 주문번호처럼 개인을 식별할 수 있는 정보가 자연스럽게 섞인다. 고객은 대화 흐름 안에서 예약 변경, 서비스 취소, 배송지 수정처럼 실제 업무 상태를 바꾸는 요청도 한다.
그래서 나는 Voice Agent의 권한을 세 덩어리로 보는 편이 편했다.
- Contact authority — 이 사람에게 지금 연락해도 되는가
- Data authority — 이 대화에서 어떤 정보를 읽거나 노출해도 되는가
- Action authority — 어떤 업무 mutation까지 실행해도 되는가
이 셋은 같은 권한이 아니다.
전화할 수 있다고 계정 정보를 보여줘도 되는 것은 아니고, 고객과 자연스럽게 대화하고 있다고 주소 변경까지 허용된 것도 아니다.
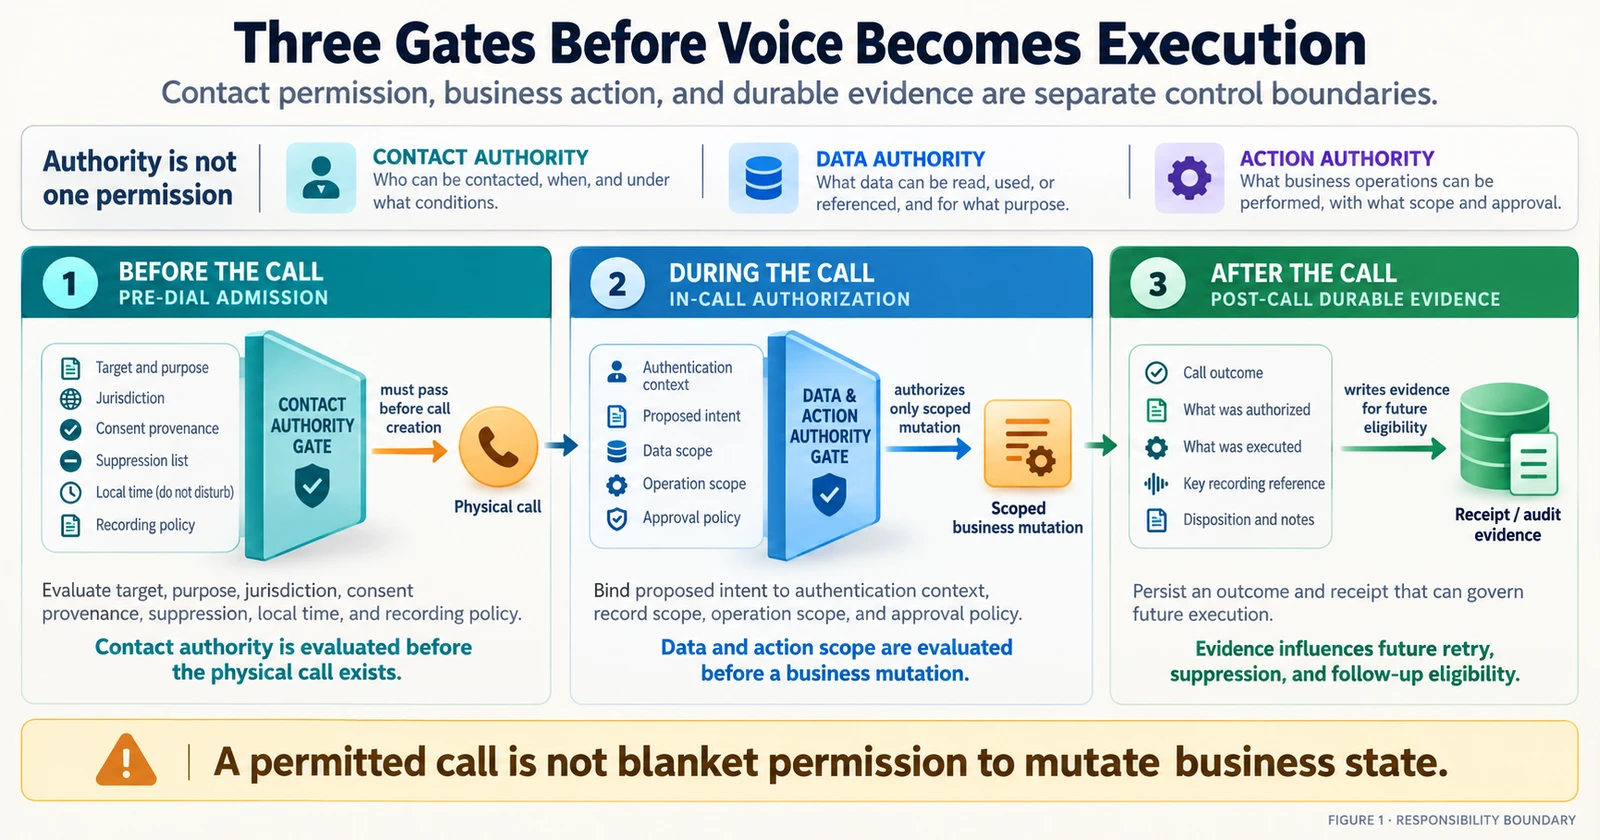
“전화해도 되는가?”와 “행동해도 되는가?”는 다른 Gate다
실제 설계에서는 세 단계로 나누는 것이 가장 명확했다.
첫 번째는 Pre-dial Compliance Admission이다.
개념적으로는 다음과 같은 질문을 call 생성 전에 끝낸다.
Target → Purpose → Jurisdiction → Consent Provenance → External DNC → Internal Suppression → Local Calling Window → Recording Policy → ELIGIBLE
두 번째는 In-call Business Authorization이다.
통화가 허용되었다고 해서 Agent가 모든 business action을 수행할 수 있는 것은 아니다.
Speech → Semantic Intent → Authentication Context → Record / Operation Scope → Policy / Approval → Mutation
세 번째는 Post-call Durable Evidence다.
통화 결과가 다음 실행에 영향을 준다면 transcript만 저장해서는 부족하다.
Outcome → Durable State → Receipt / Audit Evidence → Retry / Suppression / Follow-up Eligibility
여기서 가장 중요한 구분은 간단하다.
Agent가 정책을 알고 있는 것과 Runtime이 정책을 강제하는 것은 전혀 다른 문제다.
Prompt에 “Do Not Call 규정을 준수하라”고 넣으면 모델은 그 문장을 이해할 수 있다. 하지만 번호가 scheduler로 넘어가기 전에 실제 DNC 조회가 수행됐는지, 동의 근거가 아직 유효한지, 현지 시간이 허용되는지, 내부 suppression이 걸려 있지 않은지를 보장하는 것은 모델의 기억력이 아니라 시스템의 책임이다.
전화가 만들어진 뒤에 “사실 이 번호는 부르면 안 됐네”라고 알게 되는 것은 너무 늦다.
국가별 규정을 외우기보다 Rule Shape를 봤다
이 부분은 법률 자문이 아니다. 실제 서비스라면 대상 국가와 업무 목적에 맞는 법무·컴플라이언스 검토가 별도로 필요하다.
내가 아키텍처를 볼 때 흥미로웠던 것은 국가마다 숫자와 예외는 달라도, 결국 call admission에 필요한 input이 하나의 boolean으로 끝나지 않는다는 점이었다.
호주의 ACMA 안내를 보면 telemarketing call은 Do Not Call Register뿐 아니라 허용 시간, caller identification, 통화 목적 고지 같은 규칙도 함께 가진다. 2026년 9월 업데이트된 안내 기준으로 telemarketing은 평일 오전 9시부터 오후 8시, 토요일 오전 9시부터 오후 5시까지 허용되고 일요일과 national public holiday에는 허용되지 않는다. ACMA의 2026 enforcement 목록에도 DNC 등록 번호 호출, 금지 시간 호출, 시작 시 필수 정보 미제공이 한 investigation 안에서 함께 다뤄진 사례가 있다.
ACMA — Dealing with telemarketing
ACMA — Investigations into spam and telemarketing
미국에서는 또 rule shape가 달라진다. FCC는 2024년 AI-generated voice가 TCPA의 “artificial” voice에 해당한다고 명확히 했다. 즉 “녹음된 음성을 재생한 것이 아니라 모델이 실시간으로 말했으니 기존 artificial/prerecorded voice 규칙과 무관하다”고 단순화하기 어렵다. 동시에 FTC의 Telemarketing Sales Rule은 National Do Not Call Registry와 별도로 각 seller의 entity-specific Do Not Call 요청도 관리하도록 한다.
FCC — AI-Generated Voices in Robocalls
FTC — Complying with the Telemarketing Sales Rule
영국 ICO 안내에서는 live marketing call과 automated call을 구분하고, live marketing call에서도 TPS/CTPS와 기존 objection을 확인한다. 현재 ICO는 Data (Use and Access) Act 변화에 따라 관련 guidance 일부가 검토 중이라고 명시하고 있다. 이 역시 “AI Voice = 어느 법적 카테고리 하나”로 고정해서 구현하기보다 purpose와 modality를 policy input으로 보존해야 하는 이유다.
한국에도 공정거래위원회가 주관하고 한국소비자원이 운영하는 전화권유판매 수신거부의사 등록시스템이 있다. 공식 FAQ는 수신동의 분쟁에서 광고전송자가 입증할 수 있도록 동의 시점과 내용 같은 증빙을 확보하는 것이 필요하다고 안내한다. 동시에 이 제도 하나를 금융, B2B, 서비스 안내, 자동화된 발신까지 모든 전화의 보편 규칙으로 확대해서는 안 된다.
결국 내가 runtime에 남기고 싶은 것은 각 국가의 법률 문장을 prompt에 복사한 텍스트가 아니었다.
country + purpose + modality + consent provenance + suppression + local time 같은 사실을 policy input으로 보존하는 구조였다.
“다시 전화하지 마세요”는 Transcript가 아니다
이 문장이 Voice Agent 운영에서 가장 좋은 테스트 케이스라고 생각한다.
고객이 통화 중 이렇게 말했다고 하자.
“다시는 전화하지 마세요.”
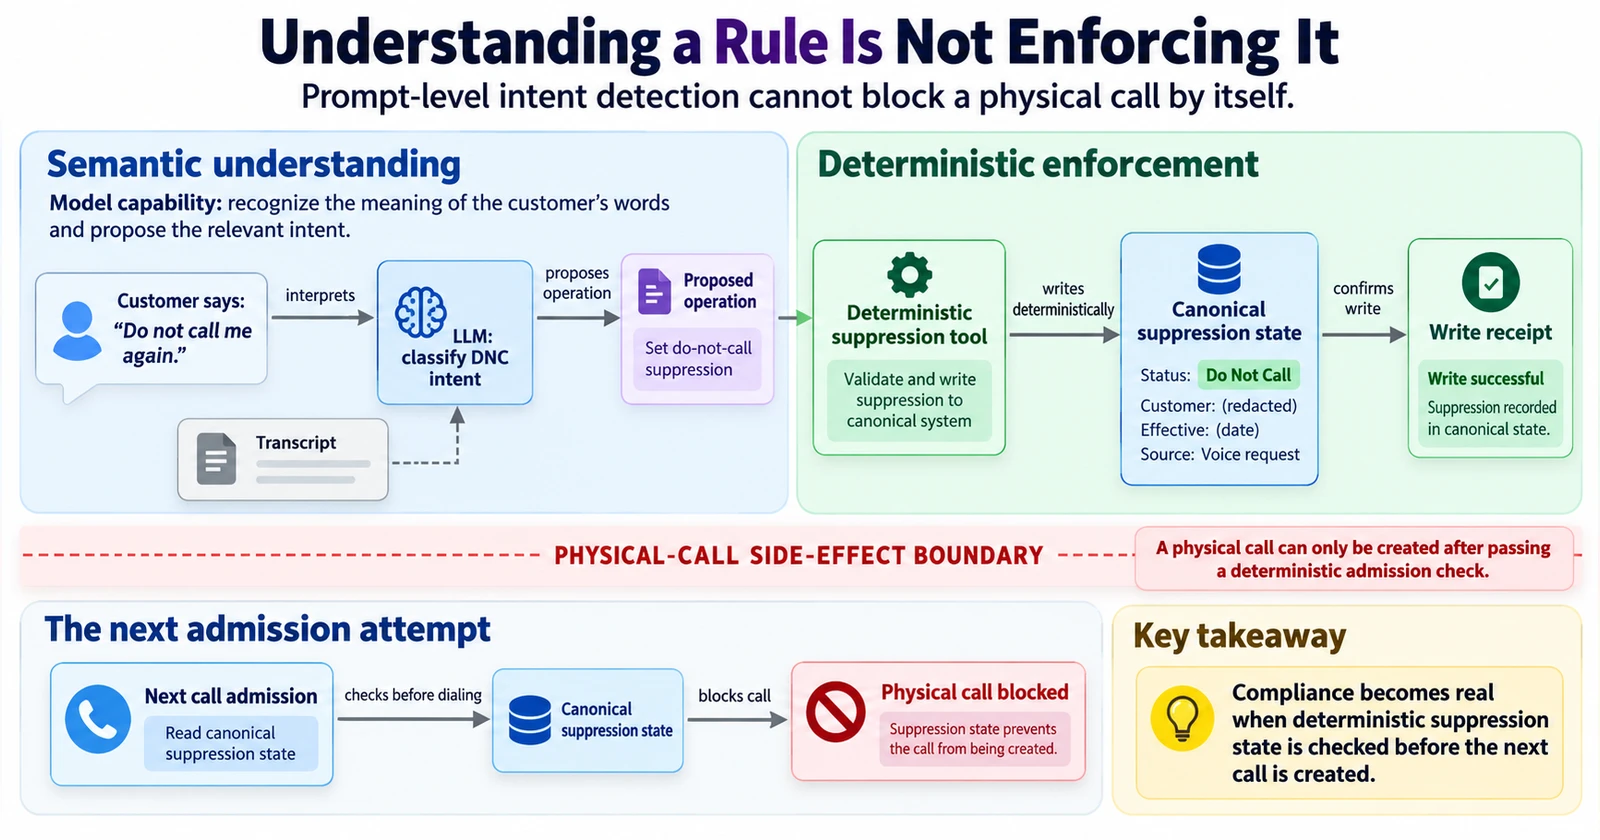
LLM은 이 문장을 꽤 잘 이해한다. DNC intent라고 분류할 수도 있고 transcript에도 정확히 남길 수 있다.
그런데 거기서 끝나면 아무 업무도 완료되지 않은 셈이다.
다음날 같은 고객이 campaign 대상에 다시 들어오고 scheduler가 번호를 가져가면 또 전화할 수 있기 때문이다.
그래서 필요한 흐름은 이런 쪽에 가깝다.
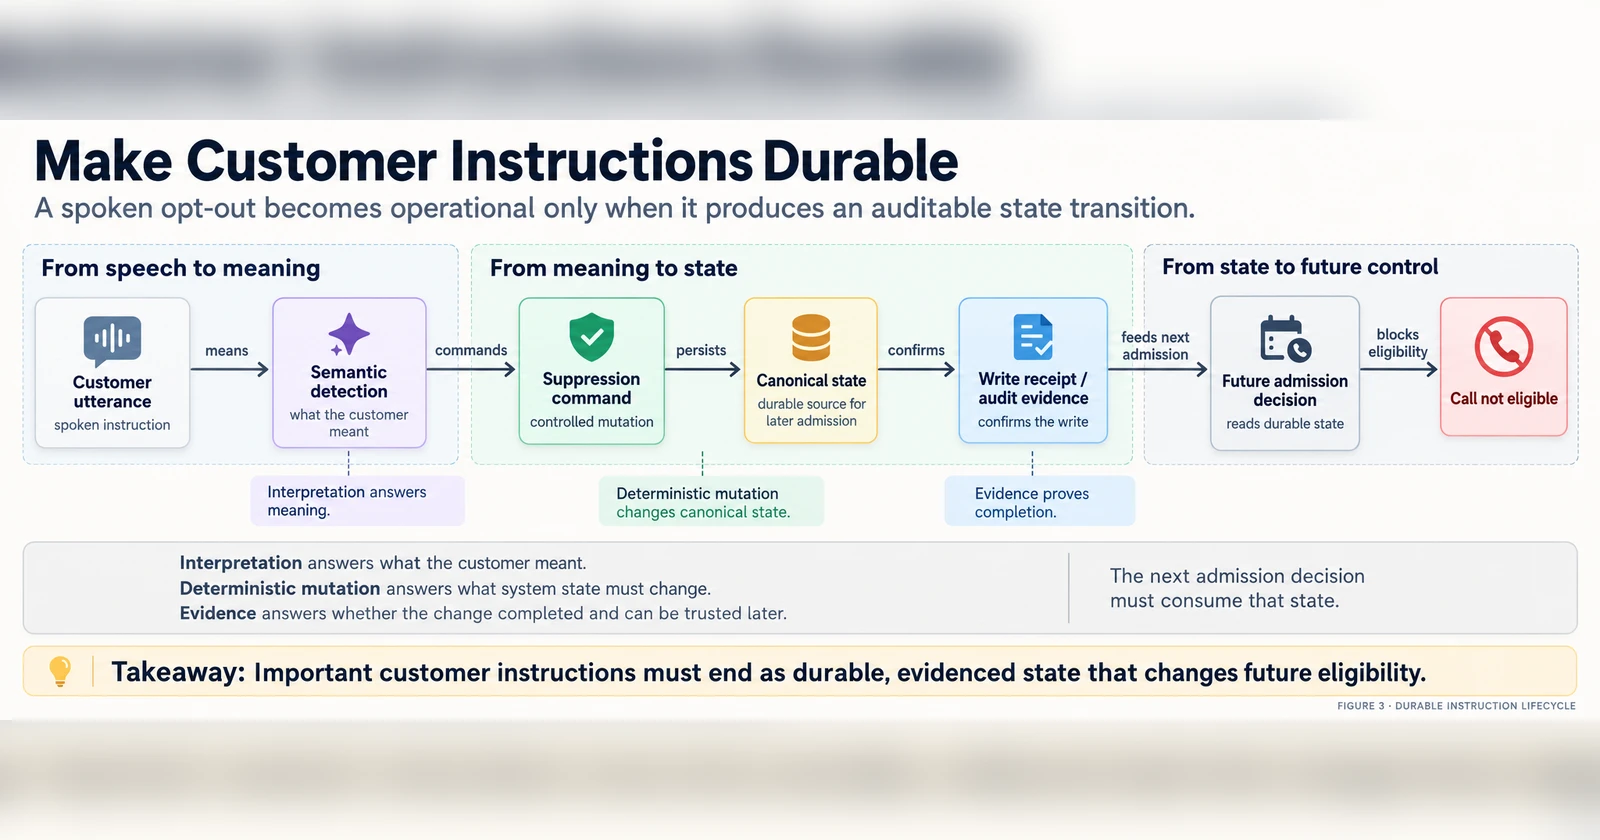
Customer Speech → DNC Intent → Deterministic Suppression Tool → Canonical CRM / Suppression State → Write Receipt → Future Admission Block
여기서 LLM이 잘하는 것은 “이 발화가 더 이상 연락하지 말라는 의미인가?”를 판단하는 일이다.
그 판단을 실제 suppression state로 바꾸고, 성공 여부를 확인하고, 다음 call admission이 그 상태를 반드시 읽도록 만드는 일은 deterministic runtime이 맡는 편이 낫다.
말을 이해한 것이 업무가 끝난 것은 아니다.
CallAllowed 하나로는 부족했다
이런 시스템을 처음 단순화하면 CallAllowed = true/false 같은 flag 하나를 만들고 싶어진다.
그런데 실제 요구사항을 조금만 펼쳐보면 금방 분리된다.
- 전화를 걸 수 있는가
- 통화를 녹음할 수 있는가
- 녹음 사실을 별도로 고지해야 하는가
- transcript를 얼마 동안 보관할 것인가
- 특정 민감정보를 대화에서 받아도 되는가
- 데이터가 어느 지역에서 처리되어도 되는가
CallAllowed = true라고 해서 RecordingAllowed = true가 되는 것은 아니다.
이런 lifecycle decision을 하나의 boolean으로 압축해 버리면 처음 PoC에서는 편하지만 국가나 use case가 하나만 추가돼도 조건문이 빠르게 꼬인다.
그래서 compliance를 “전화 가능 여부”라는 하나의 값보다 서로 다른 정책 결과의 묶음으로 보는 편이 운영하기 좋았다.
목소리는 대화 채널이지 신원 증명이 아니다
Voice가 자연스러워질수록 오히려 authentication boundary가 흐려질 수 있다.
상대방이 자기 이름을 말한다. 생년월일이나 주문 정보를 일부 알고 있다. 통화 흐름도 자연스럽다. 그러면 사람 상담에서도 그렇듯 “이 정도면 본인이겠지”라는 느낌이 생긴다.
하지만 conversation fluency와 identity assurance는 다른 문제다.
NIST SP 800-63B의 현재 guidance는 biometrics를 물리 authenticator와 결합된 제한된 방식으로 다루고 있으며, 특히 voice를 이용한 biometric comparison은 사용하지 말아야 한다고 명시한다.
NIST SP 800-63B — Authenticators
Enterprise Voice Agent에서 내가 가져갈 원칙도 간단하다.
Voice는 conversation channel이지 proof of identity가 아니다.
일반 안내는 대화를 계속할 수 있다. 하지만 민감한 계정 정보 조회, 배송지 변경, 계약 변경, 결제와 같이 영향이 큰 작업에서는 별도의 authenticated context나 step-up authentication이 필요할 수 있다.
Tool 권한은 대화 능력보다 좁아야 한다
고객은 Agent에게 무엇이든 말할 수 있다.
그렇다고 Agent가 무엇이든 실행할 수 있어야 하는 것은 아니다.
Voice Agent가 backend Tool을 사용할 때 내가 선호하는 경계는 다음과 같다.
Voice Agent → Proposed Intent / Action → Deterministic Tool Gateway → Business API
Agent는 “고객이 무엇을 원하는 것 같다”는 semantic proposal을 만든다.
Gateway는 그 다음을 확인한다.
- 현재 인증 수준에서 이 operation이 허용되는가
- 이 고객이 이 record를 변경할 권한이 있는가
- 현재 business state에서 이 transition이 가능한가
- 금액이나 위험도 때문에 추가 승인이 필요한가
- 같은 operation이 이미 성공한 적은 없는가
상대방의 speech는 자연스럽지만, security 관점에서는 어디까지나 untrusted semantic input이다. Prompt injection도 결국 이 경계를 통과해야 한다.
모델의 지능을 낮게 평가해서가 아니다.
모델에게 굳이 가져야 할 이유가 없는 authority까지 줄 필요가 없기 때문이다.
위험한 데이터는 잘 처리하는 것보다 안 받는 편이 낫다
결제 정보가 좋은 예다.
Voice Model이 카드 번호를 더 정확하게 알아듣게 만들고, transcript에서 CVV를 더 정교하게 masking하는 것도 방법일 수 있다.
하지만 가능하다면 더 강한 설계는 애초에 그 데이터를 Voice Agent의 working surface 밖으로 보내는 것이다.
결제 단계에서 secure DTMF나 PCI-compliant payment flow, 또는 별도의 authenticated channel로 넘기고 Agent에는 PAYMENT_SUCCESS처럼 제한된 결과만 돌려주는 방식이다.
이 원칙은 결제에만 해당하지 않는다.
민감한 데이터를 모델이 잘 다루게 만드는 것보다, 모델이 그 데이터를 볼 필요가 없도록 경계를 만드는 것이 더 단순할 때가 많다.
Security Review는 모델 평가표가 아니다
Enterprise에서 Voice AI vendor를 볼 때도 같은 생각이 든다.
대화 품질과 latency, tool calling 성능은 물론 중요하다. 하지만 production review에서는 결국 다른 질문이 남는다.
데이터는 어디에서 처리되는가. Audio와 transcript는 얼마나 보관되는가. 삭제는 어떻게 되는가. Subprocessor는 누구인가. Credential scope는 얼마나 좁힐 수 있는가. Recording을 켜고 끄는 통제는 어디에 있는가. Incident가 발생했을 때 audit evidence를 확보할 수 있는가.
Vendor의 privacy page나 security page는 좋은 출발점이다.
그 자체가 security acceptance는 아니다.
이 부분은 Voice AI에만 특별한 이야기도 아니다. Enterprise SaaS를 넣을 때 원래 하던 검토다. 다만 Voice Agent는 실시간 대화 + 전화 + 개인정보 + Tool execution이 한 session 안에서 만나는 만큼, 빠뜨렸을 때의 영향이 눈에 더 잘 보인다.
사람처럼 말하기 시작한 다음에 생기는 문제
Voice AI가 몇 년 사이 놀랄 만큼 자연스러워진 것은 사실이다.
2년 전 내가 음성 PoC에서 만지던 문제와 지금의 문제는 꽤 다르다. 예전에는 어떻게 말을 듣고, 언제 답하고, 어떻게 끊김 없이 이어 붙일지가 먼저였다.
지금은 그 중 많은 부분을 Voice Runtime이 맡을 수 있다.
그래서 오히려 바깥의 경계가 더 선명해졌다.
무엇을 말할 수 있는가보다 무엇을 할 수 있게 둘 것인가.
좋은 Voice Agent는 규정을 많이 외운 Agent라기보다, 자신이 가져서는 안 되는 권한을 애초에 갖지 않는 Agent에 가깝다고 생각한다.
그리고 여기까지 통제하면 다음 질문은 보안보다 운영에 가까워진다.
허용된 전화 한 통을 어떻게 중복 없이, 실패해도 복구 가능하게, 하나의 business job으로 운영할 것인가?
다음 글에서는 그 문제를 Salesforce의 business state, Ultravox Scheduler, Telnyx telephony, GET reconciliation, retry와 replay 경계까지 내려가서 다뤄보려 한다.