
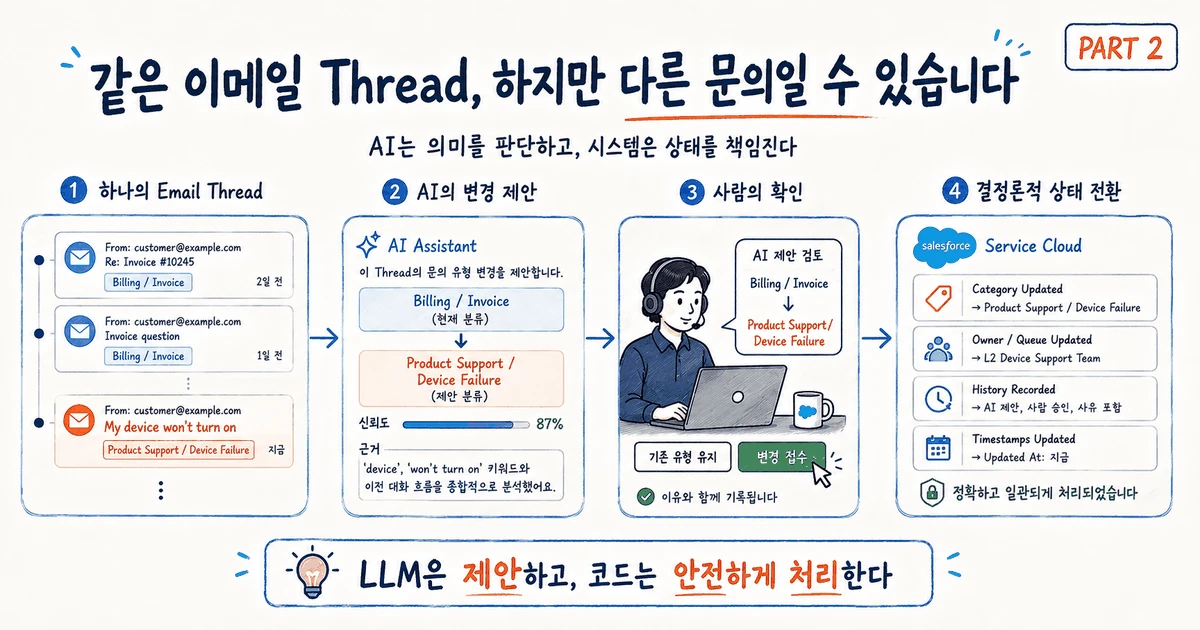
지난 글에서는 고객의 요구사항을 최대한 단순하게 유지했다.
최초 이메일이 Salesforce Email-to-Case를 통해 Case로 생성되면 AI가 내용을 읽고 Level 1과 Level 2 Category를 판단한다. Category가 정해진 이후의 Assignment는 이미 존재하는 Salesforce의 규칙에 맡긴다.
여기까지만 보면 꽤 깔끔하다.
그런데 실제 상담 업무를 생각하기 시작하면 문제는 최초 분류 이후부터 생긴다.
처음에는 Billing 문의였던 고객이 같은 이메일 Thread에서 이렇게 답할 수 있다.
“청구 건은 해결됐습니다. 그런데 장비 전원이 들어오지 않습니다.”
Salesforce 입장에서는 여전히 이어지는 이메일 대화다.
하지만 상담 업무의 관점에서도 이것을 계속 같은 문의라고 봐야 할까?
이 질문을 따라가다 보니 단순한 Category 자동 분류보다 훨씬 흥미로운 문제가 보이기 시작했다.
어디까지 AI에게 판단을 맡길 것인가.
AI의 판단이 달라졌을 때 Case의 상태와 담당 조직까지 자동으로 바꿀 것인가.
그리고 기존 Salesforce가 이미 관리하고 있는 Email Thread와 Case 관계는 어디까지 건드리는 것이 맞을까.
결론부터 말하면, 모든 복잡성을 LLM이나 Agent에게 넘기는 것이 답은 아니었다.
자연어의 의미처럼 애매한 것을 판단하는 일과, 상태·권한·정합성·트랜잭션처럼 결과가 정확해야 하는 일은 성격이 다르기 때문이다.
1. 같은 Email Thread라고 같은 문의는 아니다
고객은 Salesforce의 데이터 모델을 생각하면서 이메일을 보내지 않는다.
처음에는 청구 문제를 문의하다가 몇 번의 이메일이 오간 뒤 전혀 다른 문제를 이야기할 수 있다.
예를 들어 이런 식이다.
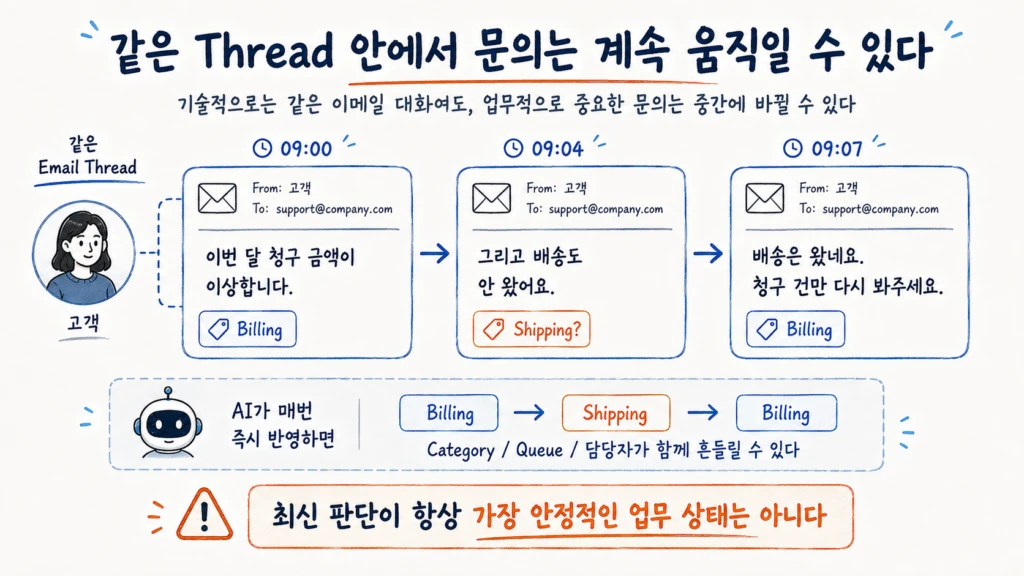
09:00
“이번 달 청구 금액이 잘못된 것 같습니다.”
09:04
“그리고 주문한 장비도 아직 도착하지 않았습니다.”
09:07
“배송은 방금 확인했습니다. 청구 건만 다시 봐주세요.”
조금 더 극단적으로는 기존 문의가 해결된 뒤 같은 Thread를 그대로 사용해 새로운 장애를 접수할 수도 있다.
기술적으로는 하나의 이메일 대화가 계속 이어지고 있지만, 업무적으로 중요한 Intent는 중간에 여러 번 움직일 수 있다.
여기서 내가 먼저 구분할 필요가 있다고 생각한 것이 있었다.
Email Thread의 연속성과 Business Intent의 연속성은 같은 개념이 아니다.
Salesforce가 이미 잘하고 있는 것은 이메일이 어떤 Case와 연결되어 있는지 관리하는 일이다.
우리가 AI로 새롭게 풀고 싶은 문제는 그 Thread 자체를 다시 만드는 것이 아니라, 그 안에서 고객이 지금 무엇을 요구하고 있는지를 해석하는 것에 더 가깝다.
이 둘을 처음부터 같은 문제로 취급하면 작은 자동 분류 기능이 금세 Email Threading 자체를 다시 설계하는 프로젝트로 커질 수 있다.
2. 그럼 새 이메일이 올 때마다 다시 분류하면 되지 않을까?
가장 먼저 떠오르는 해결책은 단순했다.
새로운 EmailMessage가 들어올 때마다 최근 대화를 다시 AI에게 보여주고 최신 Category를 계산하는 것이다.
처음에는 상당히 합리적으로 보인다.
최신 Context를 계속 반영할 수 있고, 고객의 문의가 바뀌었다면 빠르게 담당 조직을 바꿀 수도 있다.
그런데 실제 업무 흐름에 넣어보면 이야기가 달라진다.
앞의 예시처럼 고객이 몇 분 간격으로 추가 이메일을 보낸다면 AI가 모두 정확하게 판단하더라도 Case의 Category는 이렇게 움직일 수 있다.
Billing → Shipping → Billing
Category 이후에 Assignment Rule이 연결되어 있다면 단순히 필드 값 하나가 바뀌는 것으로 끝나지 않을 수도 있다.
담당 Queue가 바뀌고, 누군가 이미 Case를 Pickup했다면 새로운 담당자와 기존 담당자의 업무가 겹칠 수도 있다.
고객은 불과 몇 분 동안 생각나는 내용을 추가했을 뿐인데 시스템은 세 번의 업무 상태 변경으로 해석할 수 있다.
가장 최신의 Category를 가장 빨리 맞히는 것과, 상담 업무를 안정적으로 운영하는 것은 같은 목표가 아니다.
여기서부터 문제를 모델 정확도만으로 볼 수 없었다.
LLM이 더 똑똑해진다고 이 문제가 자동으로 해결되는 것도 아니다.
오히려 AI의 판단을 언제 실제 업무 상태에 반영할 것인지를 따로 설계해야 했다.
3. Confidence가 높으면 자동으로 바꿔도 될까?
그다음 자연스럽게 생각할 수 있는 방법은 Confidence threshold다.
예를 들어 AI가 다음과 같은 결과를 반환했다고 해보자.
{
  "category_key": "product_support_device_failure",
  "confidence": 0.97,
  "reason": "The customer states that the previous billing issue is resolved and reports a new device malfunction."
}
그러면 이런 Rule을 만들고 싶어진다.
Confidence가 0.9 이상이면 Category를 자동 변경한다.
하지만 여기서 0.97이라는 숫자가 실제로 의미하는 것이 무엇인지 생각해볼 필요가 있다.
모델은 현재 Context를 보고 Product Support 문의라고 꽤 확신하고 있을 수 있다.
그렇다고 해서 기존 담당자의 업무를 종료하고, Case의 Category를 바꾸고, 담당 조직과 SLA를 변경해도 된다는 의미까지 포함하는 것은 아니다.
Model Confidence는 Workflow Authority가 아니다.
이 구분은 생각보다 중요하다.
AI가 어떤 의미라고 판단하는 문제와, 그 판단 때문에 실제 시스템에서 어떤 행위를 허용할 것인지는 서로 다른 층위의 결정이다.
나는 전자는 LLM에게 맡길 수 있지만 후자는 가능한 한 애플리케이션과 업무 규칙이 책임지는 편을 선호한다.
4. LLM에게 계층 구조까지 직접 풀게 할 필요도 없었다
여기서 Category 분류 자체에서도 한 가지 실무적인 고민이 있었다.
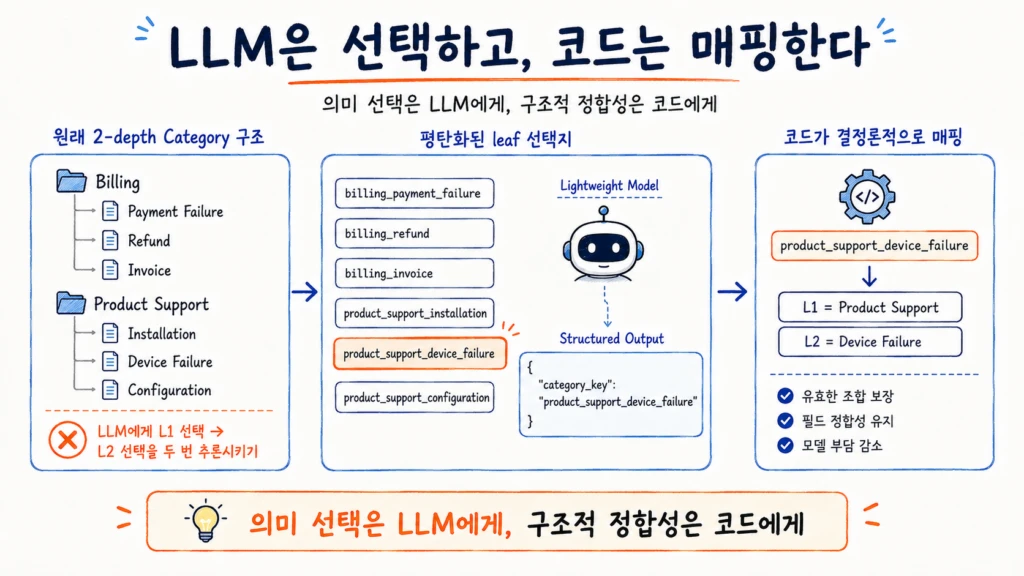
이번 고객의 Category는 Level 1과 Level 2의 2-depth 구조였다.
예를 들어 이런 식이다.
General Support
- Account
- Login
- Usage
Billing
- Payment Failure
- Refund
- Invoice
Product Support
- Installation
- Device Failure
- Configuration
처음에는 LLM이 Level 1을 먼저 고른 뒤 그 아래 Level 2를 다시 고르게 만드는 방식을 생각할 수 있다.
하지만 굳이 그렇게 할 필요는 없다.
Level 1 판단과 Level 2 판단을 따로 시키면 모델 입장에서는 두 번의 계층 판단을 해야 한다. 상황에 따라 부모와 자식의 기준이 흔들릴 수도 있고, 애플리케이션 입장에서도 조합의 정합성을 다시 확인해야 한다.
그래서 나는 선택지를 아예 leaf 단위로 펼쳐놓는 방식을 더 선호한다.
예를 들면:
general_support_account
general_support_login
general_support_usage

billing_payment_failure
billing_refund
billing_invoice

product_support_installation
product_support_device_failure
product_support_configuration
분류 목적이라면 처음부터 큰 모델을 사용할 이유도 없다. 비교적 가벼운 모델부터 검토하고, 응답 역시 자유로운 자연어가 아니라 Structured Output으로 제한하는 편이 운영하기 쉽다.
AI에게는 유효한 선택지 중 하나만 고르게 한다.
{
  "category_key": "billing_refund",
  "confidence": 0.91
}
그리고 애플리케이션이 이를 정확한 필드 값으로 매핑한다.
billing_refund
        ↓
Level 1 = Billing
Level 2 = Refund
의미 선택은 LLM에게 맡기고, 계층 관계와 필드 정합성은 코드가 책임지게 한다.
LLM은 자연어의 의미를 비교하고 가장 적절한 항목을 고르는 데 집중한다.
이미 확정된 부모-자식 관계를 다시 추론하거나 시스템 필드의 정합성까지 책임질 필요는 없다.
이런 작은 분리가 LLM이 해야 할 일을 줄이고, 애플리케이션은 더 예측 가능하게 만든다.
5. AI에게 변경이 아니라 변경 제안을 맡기기로 했다
Category를 바꿔야 할 가능성이 높다고 판단했다고 해서 AI가 실제 Case를 바로 변경하도록 만들 필요는 없었다.
AI가 잘하는 것은 이런 일이다.
- 현재 대화의 의미를 이해한다.
- 이전 문의와 지금 문의가 같은지 비교한다.
- 고객이 새로운 문제를 이야기하고 있는지 판단한다.
- 그리고 왜 그렇게 판단했는지를 짧게 설명한다.
반대로 AI가 굳이 직접 책임질 필요가 없는 일도 있다.
- Case를 Close하는 것.
- Owner나 Queue를 변경하는 것.
- SLA의 시작과 종료 시점을 기록하는 것.
- 고객에게 이관 안내 이메일을 보내는 것.
그래서 AI의 Output을 State Change가 아니라 Transition Proposal로 보는 쪽으로 생각을 바꿨다.
예를 들면 상담원에게는 이렇게 보일 수 있다.
현재 Category
Billing
AI 제안
Product Support → Device Failure
Reason
기존 Billing 문의의 해결을 명시하고 새로운 장비 장애를 문의하고 있습니다.
[기존 유형 유지] [변경 접수]
여기까지가 AI의 역할이다.
AI는 “무슨 일이 일어난 것 같은지” 판단하고, 시스템은 “그래서 실제로 무엇을 바꿀 것인지” 결정한다.
6. Human Accept를 실제 상태 전환의 경계로 봤다
그렇다면 Transition Proposal을 누가 확정해야 할까.
이 사례에서는 새로운 AI 운영 담당자를 만드는 것보다 실제 Case를 처리하는 상담원이 가장 자연스러웠다.
상담원은 이미 고객과 대화를 보고 있고, 현재 Case를 실제로 처리하고 있다.
그래서 변경 접수(Accept)를 단순한 확인 버튼이 아니라 Business State가 바뀌는 Commit Point로 생각했다.
흐름은 이런 식이다.
AI Interpretation
        ↓
Transition Proposal
        ↓
Human Accept
        ↓
----------------------
Transaction Boundary
----------------------
        ↓
Deterministic Logic
        ↓
Category Update
Owner / Queue Update
History / Timestamp
Notification
AI가 높은 Confidence를 반환했다고 해서 바로 아래 단계로 넘어가지 않는다.
사람이 Accept한 뒤에는 반대로 LLM에게 다시 묻지 않는다.
그 시점부터는 이미 결정된 업무 상태를 시스템이 정확하게 처리하면 된다.
이런 구조에서는 Human-in-the-loop도 단순히 “AI가 틀릴 수 있으니 사람이 검사한다”는 의미와 조금 다르다.
Human Accept는 업무 상태를 변경할 실제 권한을 행사하는 Transaction Boundary가 된다.
그 앞에서는 확률적인 판단이 가능하다.
그 뒤에서는 가능한 한 결정적으로 움직이는 편이 낫다.
7. 기존 Case를 어떻게 남길 것인가에서 다시 현실적인 제약을 만났다
여기까지 오면 또 다른 문제가 생긴다.
Billing을 처리하던 Case가 Product Support로 바뀐다면 기존 Billing 담당자의 처리 기록은 어떻게 남길 것인가.
아키텍처만 놓고 보면 Conversation과 Business Case를 별도 객체로 분리해 훨씬 깔끔한 모델을 만들 수도 있다.
하지만 실제 고객 환경에서는 그렇게 자유롭지 않은 경우가 많다.
이번 경우에도 사용자는 이미 Case 중심으로 일하고 있었다.
Case 화면과 Assignment 구조는 다른 조직에서 구축한 영역이었다.
고객이 원하는 것도 새로운 Case Management Platform이 아니었다.
“기존 환경에서 이 기능이 잘 돌아가면 된다.”
이런 조건에서 기존 시스템 전체를 다시 설계하는 것은 좋은 Architecture일 수는 있어도 좋은 프로젝트 판단은 아닐 수 있다.
그래서 하나의 현실적인 방법으로 기존 Case는 Email Thread의 중심으로 계속 유지하면서, Category 전환이 확정되는 시점에 이전 업무 구간을 별도의 종결 이력으로 남기는 방식을 생각할 수 있었다.
예를 들어:
Original Case
Billing
09:10 업무 시작
        ↓
10:03 Transition Accept
        ↓
Previous Billing handling
→ Closed historical record

Original Case
→ Product Support
→ 새로운 담당 조직
→ Email Thread 계속 유지
이 방식이 모든 Salesforce 환경의 정답이라는 이야기는 아니다.
기존 Case 기반 업무와 Email-to-Case 구조를 최대한 건드리지 않아야 한다는 제약 안에서 선택할 수 있는 하나의 pragmatic option에 가깝다.
여기에서도 이상적인 데이터 모델보다 고객의 현재 시스템과 업무를 먼저 봐야 했다.
8. 레코드가 생성된 시간과 실제 업무가 시작된 시간도 달랐다
이전 업무 구간을 별도 종결 Case나 Historical Record로 남긴다고 하면 또 하나 놓치기 쉬운 문제가 있다.
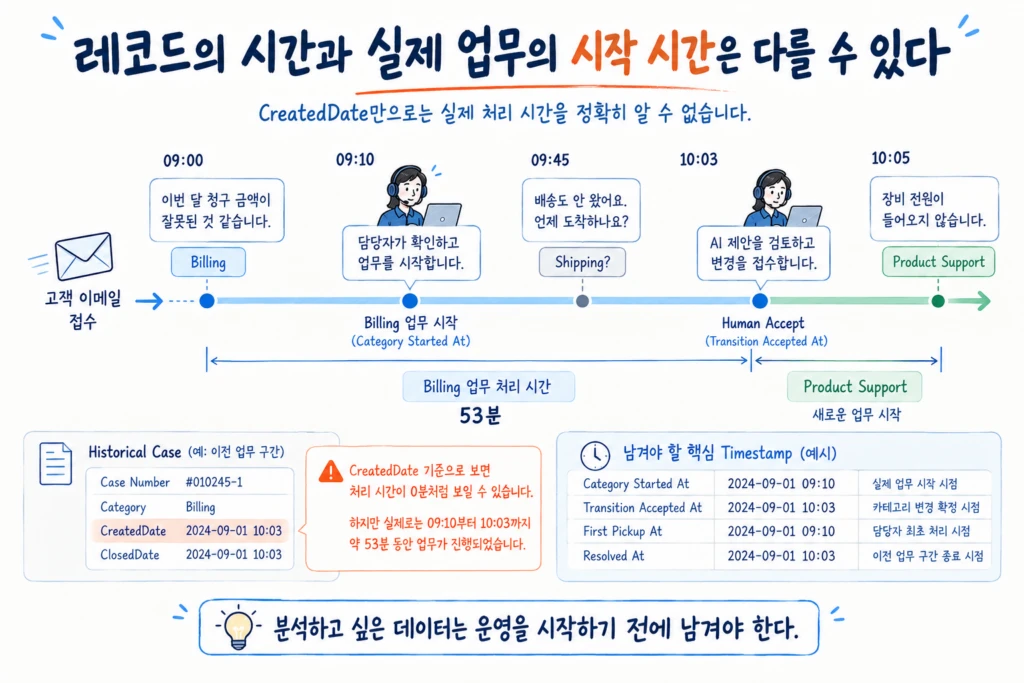
새로운 Historical Case가 10시 3분에 만들어졌다고 해보자.
그렇다고 Billing 담당자가 10시 3분부터 업무를 시작한 것은 아니다.
실제로는:
09:10 — Billing 업무 시작
10:03 — Category Transition Accept
일 수 있다.
그렇다면 실제 처리 시간은 53분이다.
Historical Case의 CreatedDate만 보면 이 업무의 Resolution Time을 제대로 계산할 수 없다.
그래서 시스템이 업무적으로 의미 있는 Timestamp를 별도로 남길 필요가 있다.
예를 들면:
Category Started At
Transition Accepted At
First Pickup At
Resolved At
같은 값이다.
레코드의 생성 시각과 실제 업무의 시작 시각은 같은 것이 아닐 수 있다.
지금 당장 이 데이터를 분석하지 않더라도 이런 이벤트를 처음부터 남겨두는 것은 중요하다.
나중에 어떤 Category에서 처리 시간이 길었는지, 잘못된 Routing 때문에 얼마나 지연됐는지, Category 전환이 많이 발생하는 유형은 무엇인지 보고 싶어졌을 때 과거로 돌아가 데이터를 다시 만들 수는 없기 때문이다.
이 부분은 세 번째 글에서 다시 다루려고 한다.
9. Category가 갈렸다고 EmailMessage까지 옮길 필요가 있을까
Category 전환을 이야기하다 보면 EmailMessage도 이전 Case와 새로운 Case로 깔끔하게 분리하고 싶어진다.
겉으로 보기에는 자연스럽다.
Billing 시점의 이메일은 Billing Case에 남기고, Product Support 문의부터는 새로운 Case에 연결하는 식이다.
하지만 그렇게 하기 시작하면 우리가 책임져야 하는 범위가 크게 달라진다.
기존 Reply는 어떤 Case를 기준으로 해야 하는가.
과거 이메일에 고객이 다시 Reply하면 어디로 들어가야 하는가.
새로운 inbound email의 technical thread를 어떤 기준으로 다시 연결할 것인가.
Salesforce가 이미 Email-to-Case에서 관리하고 있던 영역을 업무 Category 전환 때문에 우리가 다시 구현하기 시작하는 셈이다.
Business State를 나눴다고 Technical Thread까지 같은 방식으로 나눠야 하는 것은 아니다.
이번 사례에서는 Email-to-Case가 이미 안정적으로 관리하는 Email Thread의 관계는 최대한 그대로 두는 쪽이 더 현실적이라고 생각했다.
Part 1에서도 비슷한 결론에 도달했다.
기존 시스템이 이미 잘하고 있는 것은 그대로 사용한다.
AI를 넣는다고 해서 시스템의 모든 경계를 다시 그릴 이유는 없다.
10. 담당자가 Accept하기 전에 이메일이 더 들어오면?
마지막으로 꽤 현실적인 문제가 하나 더 남는다.
고객이 새로운 장비 문제를 이야기했고 AI가 Product Support로의 전환을 제안했다고 해보자.
그런데 담당자가 아직 그 Proposal을 확인하지 않았다.
그 사이 고객이 다시 이메일을 보낸다.
Email #5
“장비가 켜지지 않습니다.”
AI
Product Support 전환 제안
아직 담당자 미확인
Email #6
“전원 케이블을 다시 연결했습니다.”
Email #7
“그래도 동일합니다. 빠르게 확인 부탁드립니다.”
이때 이메일 하나가 올 때마다 새로운 Transition Proposal을 만들어버리면 다시 같은 문제가 발생한다.
판단은 세 번 일어났지만 업무적으로는 하나의 새로운 문제에 대한 연속적인 설명일 가능성이 높다.
따라서 이미 Pending 상태의 Transition이 있다면 새로운 메시지를 같은 후보에 추가하면서 Context를 보강하는 방식도 생각할 수 있다.
Pending Transition
Product Support
    ├─ Email #5
    ├─ Email #6
    └─ Email #7
이런 곳에서는 단순한 Classification Accuracy만으로 문제를 풀기 어렵다.
debounce, pending state, 상황에 따라서는 hysteresis 같은 개념이 필요한 이유도 여기에 있다.
비정형 이벤트를 처리할 때는 판단의 정확도만큼 상태가 불필요하게 흔들리지 않도록 만드는 것도 중요하다.
그리고 고객에게 Category 변경이나 담당 조직 변경을 안내하는 시점 역시 AI가 Proposal을 만든 직후가 아니라, 실제 업무 상태가 확정된 이후가 자연스럽다.
AI Proposal
      ↓
Human Accept
      ↓
Committed Business State
      ↓
Customer Notification
고객에게 전달되는 것은 모델의 추론 결과가 아니라 회사가 실제로 확정한 업무 상태여야 하기 때문이다.
11. 결국 LLM이 잘하는 것과 코드가 잘하는 것을 다시 나누게 됐다
처음에는 고객의 이메일을 읽고 Category만 결정하면 되는 문제였다.
그런데 실제 운영 상황을 하나씩 따라가면서 설계는 조금씩 구체화됐다.
중요한 것은 그 과정에서 모든 새로운 문제를 LLM의 기능으로 해결하려 하지 않았다는 점이다.
LLM이 잘하는 일
- 자연어의 의미 해석
- 최근 Context 비교
- 현재 Intent 판단
- Category 후보 선택
- Intent 변화 감지
- 변경 이유 요약
코드와 Salesforce가 더 잘하는 일
- 유효한 Category 조합 보장
- L1/L2 필드 매핑
- Case 상태 확인
- 권한 확인
- Transition 상태 관리
- Owner / Queue 변경
- Timestamp 기록
- Audit
- 후행 Notification
사람이 책임지는 일
- 실제 업무 맥락에서 Transition Accept / Reject
- Business State 변경 권한 행사
결국 내가 선호하게 된 구조는 꽤 단순하다.
애매한 의미 판단은 LLM에게 맡기고, 정확해야 하는 상태 변화는 코드와 기존 업무 시스템이 책임진다.
Agent가 기술적으로 할 수 있는 일이 많아졌다고 해서 모든 것을 Agent에게 맡기는 것이 좋은 Architecture는 아니다.
반대로 모든 판단을 코드로 만들려고 하면 비정형적인 고객 언어의 경우의 수를 끝없이 규칙으로 작성하게 된다.
둘 중 하나를 선택하는 문제가 아니다.
각자가 잘하는 일을 정확하게 나누는 문제에 가깝다.
Part 1에서는 무엇을 AI에게 맡길 것인지 고민했다.
이번 글에서는 그 AI의 판단을 실제 업무 상태로 어떻게 안전하게 연결할 것인지를 따라가봤다.
이제 이 구조가 운영되기 시작하면 새로운 데이터가 쌓인다.
AI가 무엇을 예측했는지.
어떤 Category Transition을 제안했는지.
사람은 Accept했는지 Reject했는지.
실제로 Category가 다시 변경됐는지.
언제 담당자가 Pickup했고 언제 업무가 종료됐는지.
그리고 어떤 문의에서 같은 문제가 반복되는지.
이 데이터는 단순한 로그 이상으로 사용할 수 있다.
다음 글에서는 이 운영 결과를 Closed Loop로 연결해 분류의 오탐을 어떻게 찾아내고 보정할지, 그리고 이번에 남겨둔 Pickup·Transition·Resolution Timestamp를 향후 업무 분석의 기반으로 어떻게 활용할 수 있을 지를 이어서 살펴보려고 한다.