
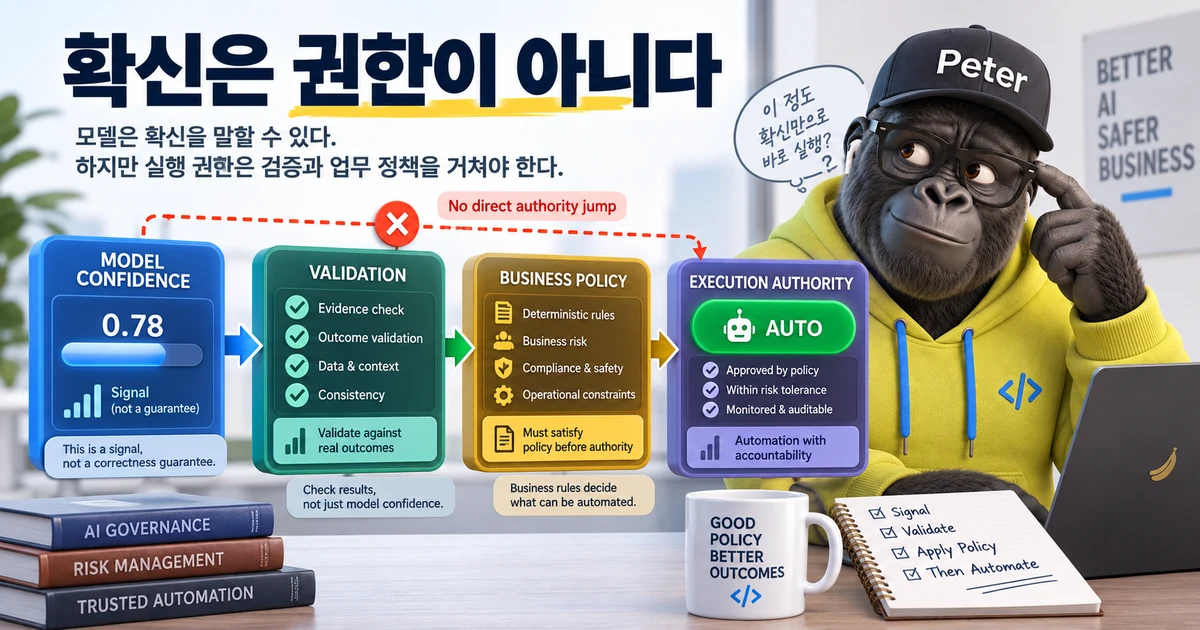
AI 분류 PoC를 만들다 보면 아주 자연스럽게 한 줄짜리 규칙을 떠올리게 된다. confidence ≥ 0.90 → AUTO. 숫자도 명확하고, workflow로 옮기기도 쉽다. 90% 이상 자신 있다고 하면 자동으로 처리하고, 그 아래만 사람이 보면 될 것 같다.
나도 이메일 분류 PoC를 만들면서 비슷한 지점에 도달했다. JEV를 이용한 n8n workflow에서는 L1과 L2 판단마다 winner와 runner-up, probability 또는 score, margin을 기록할 수 있었다. 관측 가능한 숫자가 생기니 이제 threshold만 정하면 production policy가 완성될 것처럼 보였다.
그런데 실제 구조를 다시 보면 중요한 한 단계가 빠져 있었다. 현재 PoC는 uncertainty signal을 측정하고 있었지만, 그 signal을 근거로 AUTO와 REVIEW를 나누는 검증된 운영 정책은 아직 없었다. margin이 좁아도 winner는 그대로 final classification이 됐다.
Model confidence는 관측 신호이지 업무 권한이 아니다.
Enterprise AI에서 더 중요한 질문은 “모델이 얼마나 자신 있다고 말했는가?”가 아니다. 그 숫자를 근거로 어디까지 자동 처리를 허용할 것인가?
0.90이라는 숫자는 무엇을 뜻하는가
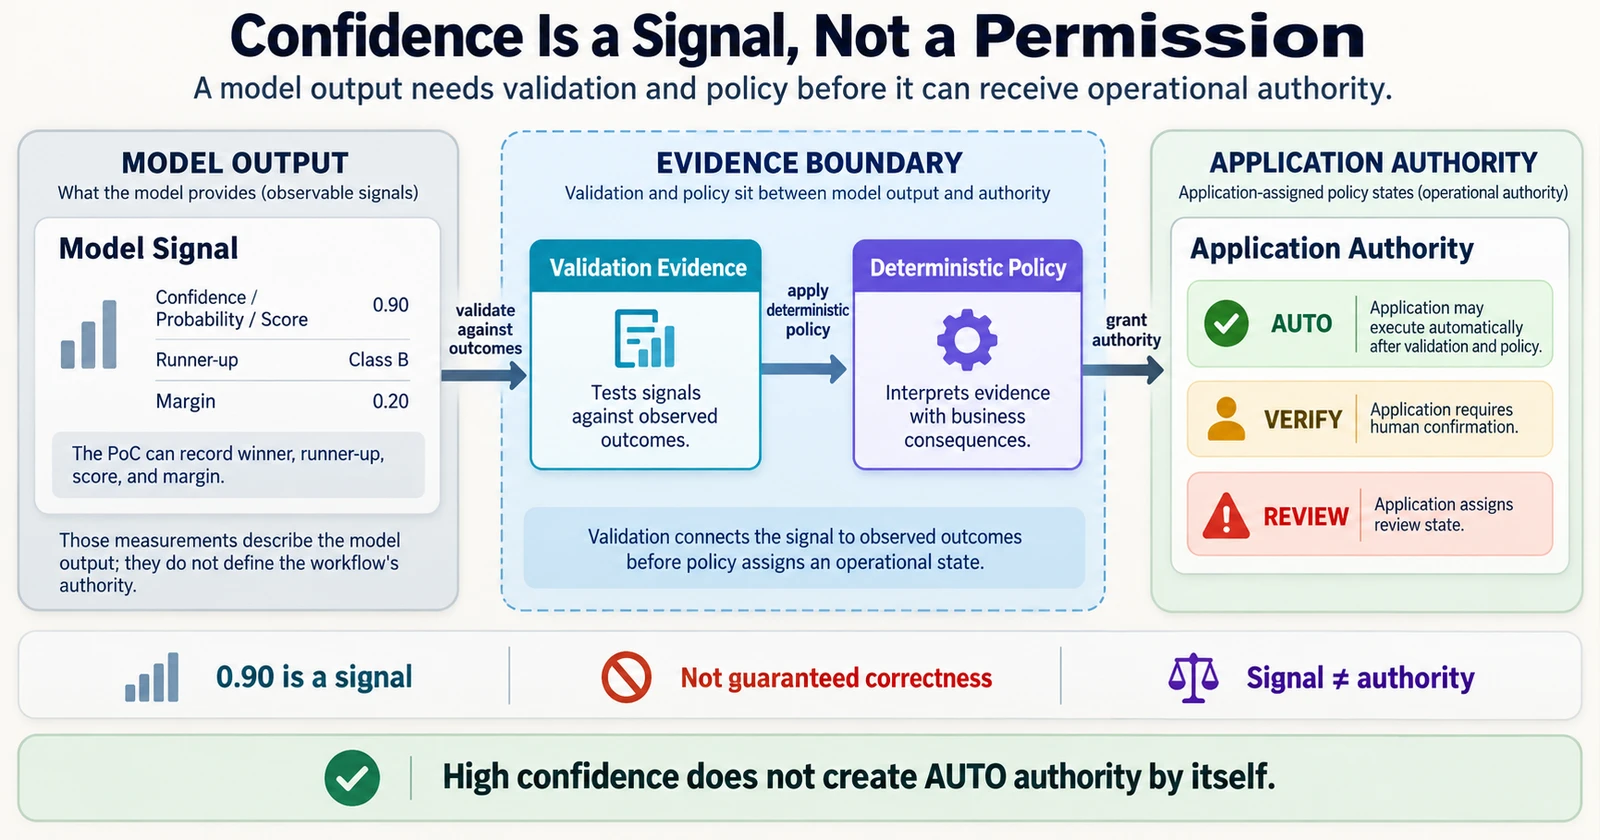
분류 결과가 ON_SITE_TECHNICAL_SUPPORT이고 confidence가 0.90이라고 가정해보자. 여기서 가장 위험한 해석은 “90% 확률로 정답이다”라고 받아들이는 것이다.
모델이 반환하는 confidence, probability, score, margin은 모델과 방법에 따라 의미가 다르다. 특히 LLM에서는 입력의 모호성, reasoning 과정의 변동, decoding의 stochasticity처럼 불확실성이 여러 층에서 생긴다. 2025년 KDD의 Uncertainty Quantification and Confidence Calibration in Large Language Models: A Survey도 LLM uncertainty를 하나의 단순한 probability 문제로 다루기 어렵다는 점을 정리한다.
하지만 이 글에서 중요한 것은 uncertainty taxonomy 자체가 아니다. Enterprise workflow 입장에서 필요한 질문은 훨씬 현실적이다. confidence 0.90 이상이라고 나온 과거 사례들을 모았을 때 실제로 얼마나 맞았는가?
예를 들어 특정 validation set에서 confidence 0.90 이상인 사례 100건 중 90건 정도가 맞았다면, 그 구간의 숫자는 실제 correctness와 어느 정도 정렬되어 있다고 볼 수 있다. 이것이 calibration을 이해하는 가장 실용적인 출발점이다.
반대로 confidence 0.90 이상인 사례가 실제로는 70%만 맞았다면, 숫자가 높아 보인다는 이유만으로 AUTO 권한을 줘서는 안 된다. 즉 threshold를 정하기 전에 해야 할 일은 threshold를 고르는 것이 아니라 그 숫자가 실제 운영 결과와 어떤 관계를 갖는지 측정하는 것이다.
JEV PoC에서 이미 숫자는 있었지만 정책은 없었다
내가 만든 JEV 이메일 분류 workflow에서는 L1에서 selected probability, runner-up probability, margin, confidence를 기록했고, L2에서도 winner score, runner-up score, margin을 남겼다.
단순히 최종 category 하나만 저장하는 것보다 이런 signal을 함께 남기면 category pair별 margin, 특정 domain의 반복 오분류, 경계가 가까운 category의 runner-up 패턴, 사람이 수정한 사례의 공통 signal을 나중에 분석할 수 있다.
uncertainty measurement = 있음
uncertainty-based operational policy = 아직 없음
winner를 계산할 수 있다고 해서 winner에게 business authority까지 자동으로 부여할 수 있는 것은 아니다. 모델은 prediction, score/probability, runner-up, margin, evidence 같은 signal을 제공할 수 있지만 Application이 결정해야 하는 것은 AUTO, VERIFY, REVIEW, REJECT 같은 operational state다.
앞의 값은 signal이고, 뒤의 값은 policy다. 두 가지를 같은 것으로 취급하면 모델 구현은 간단해지지만 운영 리스크는 Application 밖으로 새어나간다.
Accuracy 하나로는 AUTO 정책을 만들 수 없다
여기서 흔히 또 하나의 숫자를 찾게 된다. “전체 accuracy가 95%라면 자동화해도 되지 않을까?” 하지만 전체 accuracy 역시 충분하지 않다. Enterprise 환경에서는 어떤 오류가 발생했는지가 중요하기 때문이다.
예를 들어 이메일을 단순한 내부 문의 category로 잘못 보낸 경우에는 사람이 다시 Queue를 옮기는 정도로 끝날 수 있다. 반면 잘못된 분류가 RMA 생성, 현장 엔지니어 배정, 고객 안내, 비용 승인 같은 downstream action으로 이어진다면 같은 오분류 1건의 의미가 전혀 다르다.
어느 정도의 업무를 자동화하면서, 어떤 종류의 오류를 어느 수준까지 허용할 것인가?
- Coverage: 전체 요청 중 사람이 개입하지 않고 자동 처리하는 비율
- Risk: 그 자동 처리 영역 안에서 잘못된 결정이 발생하는 위험
AUTO 범위를 좁히면 일반적으로 coverage는 낮아지고 사람이 더 많이 개입한다. 반대로 threshold를 낮춰 AUTO 범위를 넓히면 운영 비용은 줄 수 있지만 잘못된 자동 처리의 위험이 커질 수 있다.
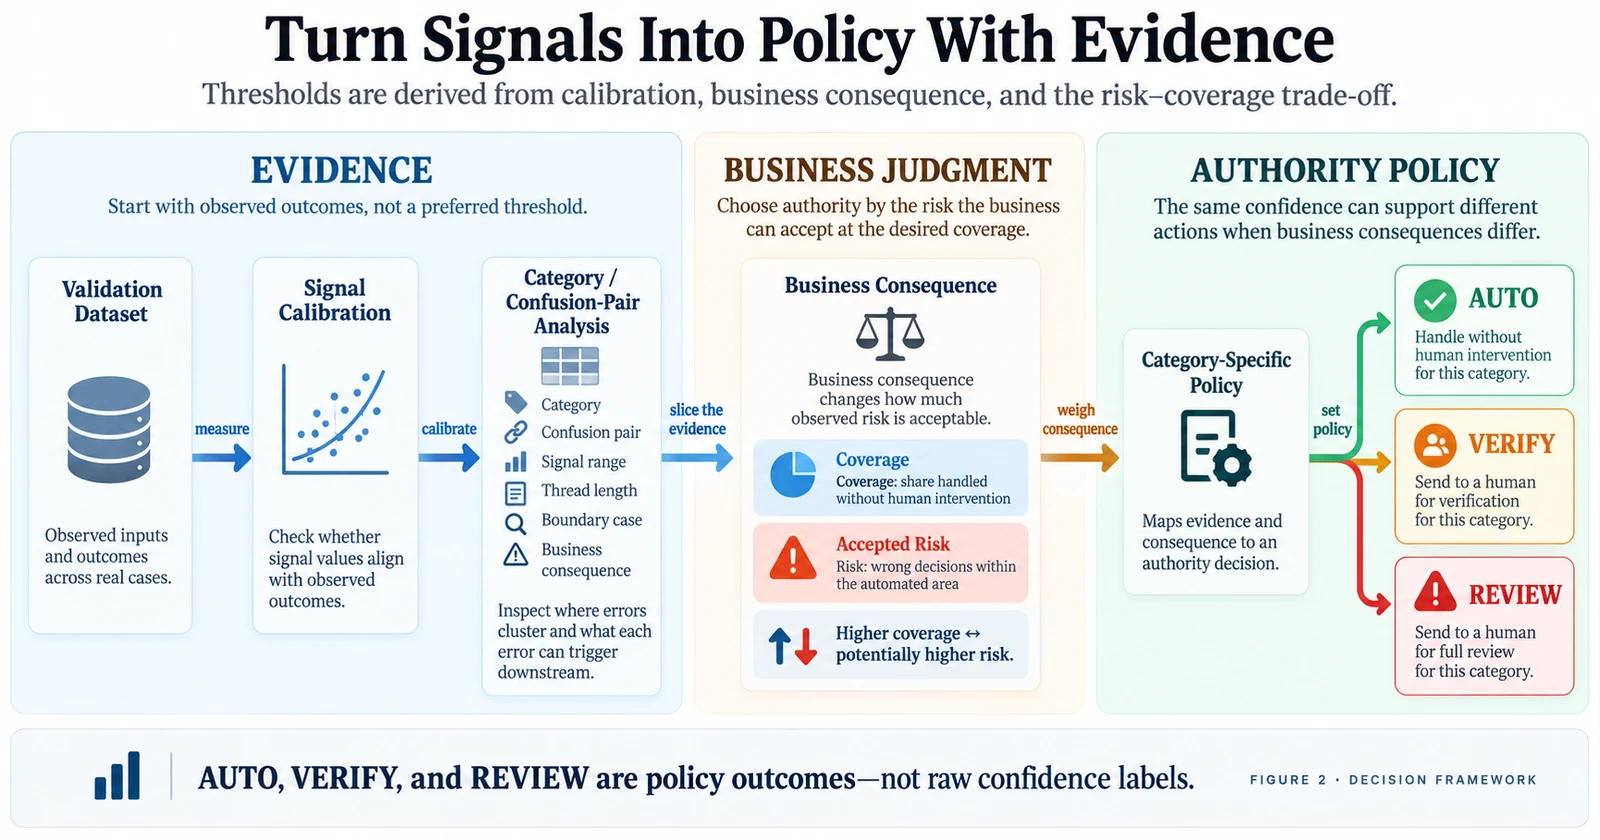
validation dataset → signal calibration → category/confusion-pair analysis → business error consequence → risk-coverage policy → AUTO/VERIFY/REVIEW
같은 0.90이라도 같은 권한을 줄 필요는 없다
global threshold 하나로 모든 category를 처리하는 것도 다시 생각해야 한다. 두 분류 결과가 모두 confidence 0.90이라고 해도, 하나는 잘못 분류되어도 재배정으로 끝나는 내부 정보 요청이고 다른 하나는 실제 엔지니어 일정이나 리소스가 움직이는 On-site Support일 수 있다.
모델 입장에서 confidence가 같더라도 business consequence는 다르다. low-impact category에서는 충분한 calibration evidence가 있을 때 AUTO 범위를 넓힐 수 있고, high-impact category에서는 동일 confidence라도 VERIFY를 요구할 수 있다. critical side effect라면 별도 human approval을 둘 수 있다.
모델 신뢰도와 업무 권한을 서로 다른 좌표로 관리해야 한다. Enterprise AI에서 confidence threshold는 모델 parameter라기보다 policy configuration에 가깝다.
따라서 model version뿐 아니라 question contract version, validation dataset version, policy version도 함께 추적할 필요가 있다. 모델이 그대로여도 taxonomy가 바뀌거나 validation distribution이 달라지면 threshold policy는 다시 검토해야 한다.
REVIEW는 실패가 아니다
AI 자동화를 설계할 때 REVIEW가 많으면 시스템이 덜 완성된 것처럼 느껴질 수 있다. 하지만 production에서는 불확실한 요청을 억지로 AUTO 처리하지 않고 REVIEW로 보내는 것도 정상적인 의사결정이다.
통계적 machine learning에서는 모든 입력에 반드시 답을 내는 대신 충분히 신뢰할 수 있는 영역에서만 prediction을 수용하고 나머지는 abstain하는 selective prediction 또는 reject option을 다룬다. Enterprise workflow에서는 이를 operational state로 표현하면 충분하다.
- AUTO: 현재 policy가 자동 결정을 허용
- VERIFY: AI 제안을 보여주되 사람이 짧게 확인
- REVIEW: 사람의 판단이 주 경로
- REJECT / FAIL-CLOSED: 현재 contract로 처리할 수 없음
중요한 것은 REVIEW를 OTHER 같은 business category와 섞지 않는 것이다. JEV PoC에서도 OTHER는 실제 업무 taxonomy이고, REVIEW는 현재 model decision에 operational authority를 주지 않는 상태로 분리해야 했다.
OTHER를 불확실성 쓰레기통으로 사용하면 taxonomy가 시간이 지날수록 망가진다. 반대로 REVIEW를 정상 workflow state로 두면 model uncertainty를 business taxonomy와 분리해서 관리할 수 있다.
Human-in-the-loop는 fallback이 아니라 measurement system이다
HITL을 단순히 “AI가 틀릴 수 있으니까 사람이 확인한다”로 설명하면 production에서 가장 중요한 절반을 놓친다. 사람이 최종적으로 승인하거나 수정한 결과는 다음 calibration을 위한 핵심 데이터가 된다.
AI prediction → AUTO/VERIFY/REVIEW policy → human-approved outcome → evaluation dataset → calibration/regression → next policy version
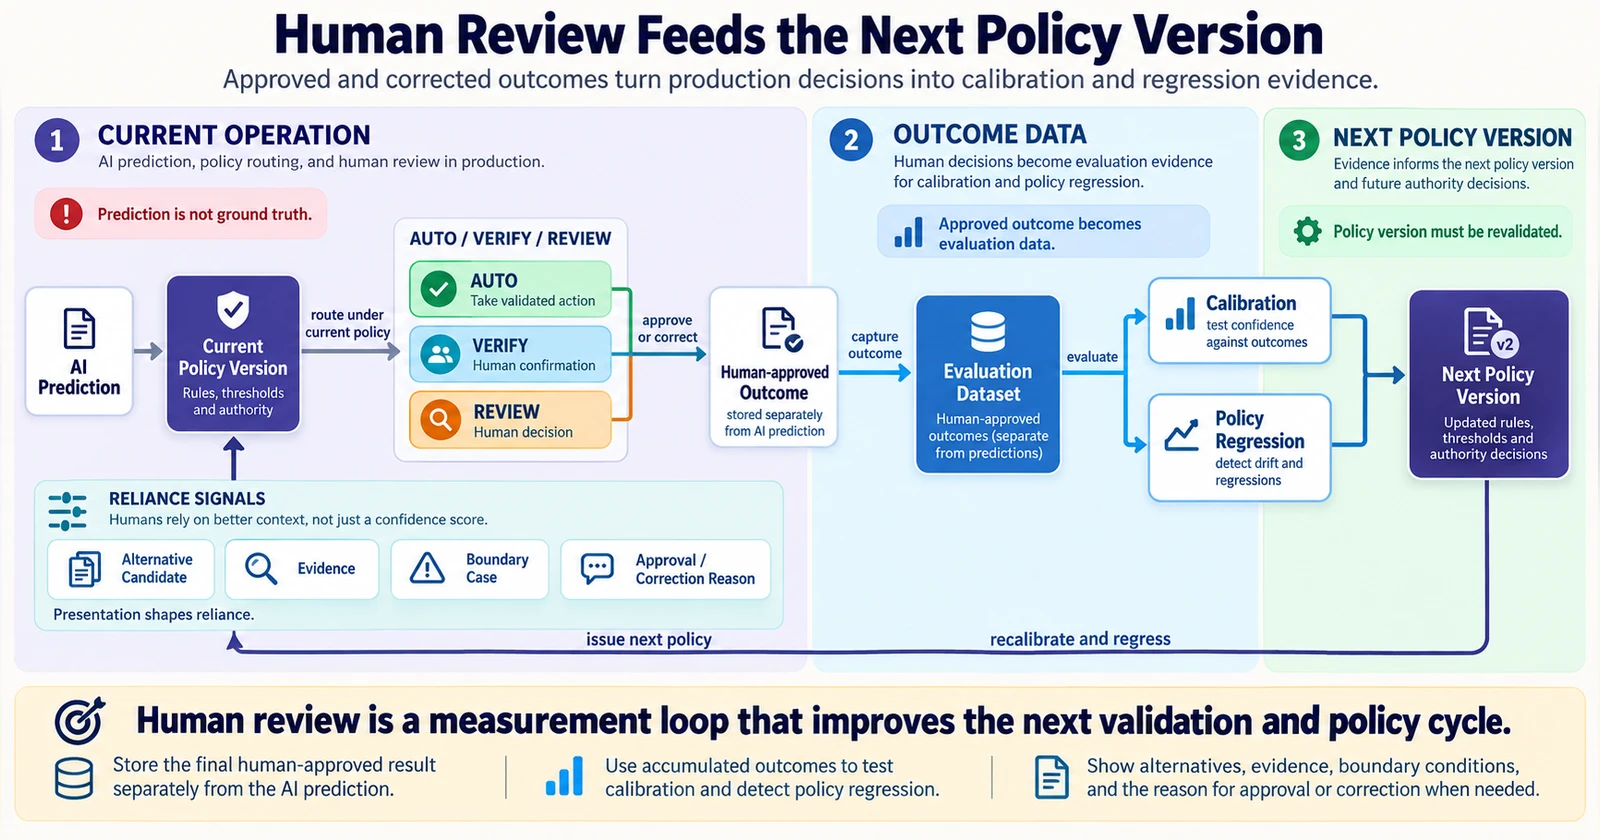
AI confidence가 잘 calibrated되었다고 해서 사람이 그 숫자를 항상 올바르게 사용하는 것도 아니다. Human-Aligned Calibration for AI-Assisted Decision Making은 단순히 AI confidence를 correctness probability에 맞추는 것만으로는 인간 의사결정자가 언제 AI를 믿어야 하는지 쉽게 판단하지 못할 수 있다는 문제를 다룬다.
Enterprise UI에서는 confidence = 97%라는 숫자를 크게 보여주는 순간, 사용자가 그것을 단순한 signal이 아니라 “거의 확정”이라는 권고로 읽을 수 있다. 따라서 confidence, alternative candidate, evidence, boundary case, 승인·수정 이유를 어떻게 보여주고 기록할지까지 설계해야 한다.
좋은 calibration은 backend metric으로 끝나지 않는다. 사람과 AI 사이의 reliance를 어떻게 설계할 것인가까지 이어진다.
내가 production에 넣는다면 먼저 이것부터 쌓을 것이다
1. Prediction과 함께 signal을 남긴다
최종 category만 저장하지 않는다. 가능한 범위에서 prediction, runner-up, score/confidence, margin, boundary signal, model/contract version을 함께 남긴다.
2. Human-approved outcome을 분리해 저장한다
AI prediction을 ground truth로 사용하면 calibration 자체가 불가능하다. 사람이 실제로 승인하거나 수정한 최종 결과를 별도의 outcome으로 남긴다.
3. 전체 accuracy보다 slice를 본다
category별, confusion pair별, confidence/margin 구간별, thread 길이별, boundary case 여부별, business consequence별 결과를 따로 본다. 전체 95%가 실제로는 한 쉬운 category에 의해 만들어진 숫자일 수 있다.
4. AUTO policy를 validation 결과에서 도출한다
0.90이나 0.80을 먼저 정하고 맞추지 않는다. 어느 signal 구간에서 어느 수준의 risk가 관측됐고, 그 risk를 해당 업무가 감당할 수 있는지를 보고 AUTO 범위를 정한다.
5. Production drift를 다시 측정한다
새 제품, 새 고객 유형, taxonomy 변경, prompt/question 변경이 생기면 과거 calibration을 그대로 믿지 않는다. 정책은 한 번 만든 threshold가 아니라 재검증해야 하는 운영 자산이다.
결국 필요한 것은 Confidence가 아니라 Authority Contract다
모델이 category와 confidence를 내놓으면 threshold 하나를 정해서 높은 값은 자동 처리하고 낮은 값은 사람이 보면 될 것 같았다. 하지만 실제 Enterprise workflow에서는 Model Signal → Validation Evidence → Business Risk Policy → Execution Authority라는 계층이 더 필요하다.
모델은 자신이 무엇을 선택했는지 말할 수 있고 score나 margin을 제공할 수도 있다. 하지만 그 숫자에 얼마만큼의 업무 권한을 부여할지는 Application과 운영 정책이 결정해야 한다.
AUTO / VERIFY / REVIEW는 모델의 confidence label이 아니다. 검증된 evidence와 business consequence를 바탕으로 Application이 부여한 authority state다.
Confidence는 권한이 아니다.
좋은 Enterprise AI는 모델이 항상 확신하도록 만드는 시스템이 아니다. 모델이 확신하는 순간조차, 어디까지 믿고 어떤 행동을 허용할 것인지 측정하고 통제할 수 있는 시스템이다.
참고한 연구
- Xiaoou Liu, Tiejin Chen, Longchao Da, Chacha Chen, Zhen-Yu Lin, Hua Wei. Uncertainty Quantification and Confidence Calibration in Large Language Models: A Survey. KDD 2025.
- Manuel Gomez Rodriguez. Human-Aligned Calibration for AI-Assisted Decision Making. 2023.