
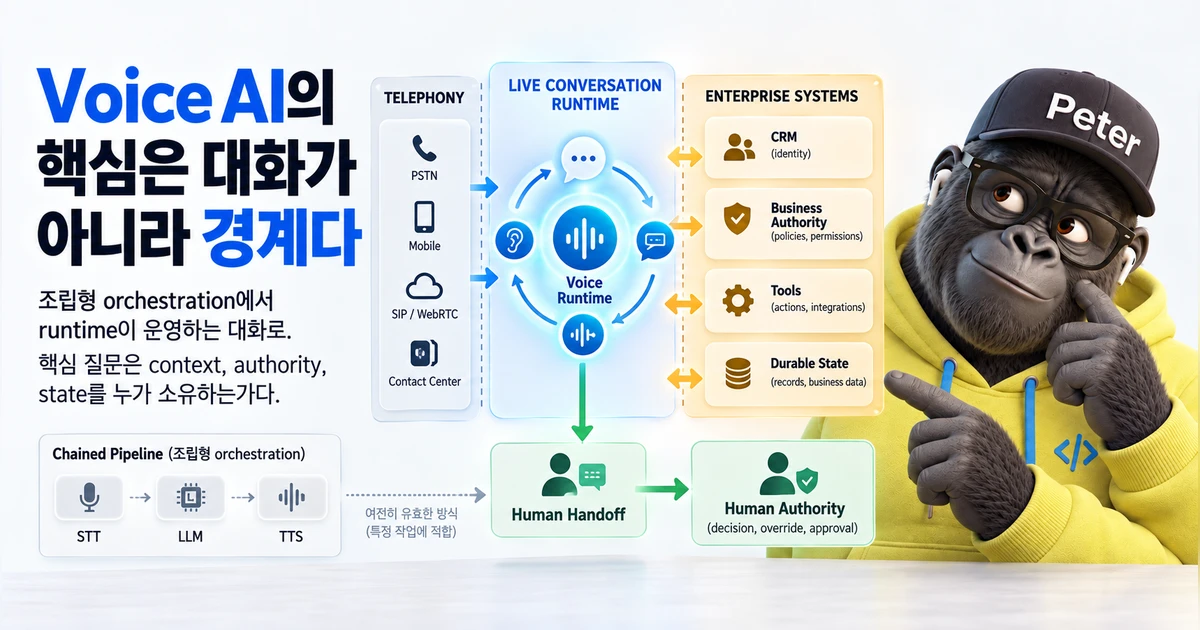
2년쯤 전, 나는 n8n으로 음성 Agent를 오케스트레이팅하는 PoC를 만들고 있었다.
시작은 Whisper였다. 사람이 말하면 음성을 텍스트로 바꾸고, 그 텍스트를 LLM과 workflow에 넘기고, 필요하면 Tool을 실행한 다음 다시 음성으로 바꿔 상대방에게 들려줬다. 결과 화면만 보면 지금의 Voice Agent와 크게 다르지 않았다. 말을 듣고, 판단하고, 대답했다.
실제로 만들어보면 느낌은 달랐다.
대화를 만드는 일보다 대화 사이의 빈틈을 연결하는 일이 더 많았다. 언제 사용자가 말을 끝냈다고 볼지, 몇 초를 기다릴지, STT가 잘못 들으면 어디서 복구할지, LLM 응답이 늦어지면 무엇을 할지, 사용자가 답변 중간에 끼어들면 어떻게 할지 같은 문제를 하나씩 orchestration으로 메워야 했다.
OpenAI가 Whisper를 공개한 것은 2022년 9월이었다. 당시 Whisper 같은 ASR, LLM, TTS를 조합하면 이전보다 훨씬 쉽게 음성 PoC를 만들 수 있었다. 다만 내 경험에서 그 시스템은 하나의 Voice Model이라기보다 여러 기술을 이어 붙인 실시간 pipeline에 가까웠다.
음성 Agent를 만들고 있었지만, 실제로 가장 많이 만지고 있던 것은 Agent보다 orchestration이었다.
그보다 더 전으로 가면 전화 시스템 자체가 지금보다 훨씬 전문적인 영역이었다. ACD, IVR, CTI, SIP 같은 기술은 일반적인 Web/API 개발자가 가볍게 붙여보는 기능이라기보다 Contact Center와 Telephony의 영역에 가까웠다. IVR도 수십 년 전부터 self-service와 routing을 제공해 왔지만, 고객 입장에서 만나는 자동화는 메뉴나 정해진 발화 흐름을 따라가는 경우가 많았다.
당시 사용자 입장에서 느낀 콜봇은 꽤 단순했다. 사람은 자연스럽게 말했지만, 시스템은 자신이 예상한 문장을 기다리고 있는 느낌이었다.
그런데 몇 년 사이 이 전제가 빠르게 바뀌었다.
2년 전 Voice Agent는 왜 이렇게 복잡했을까?
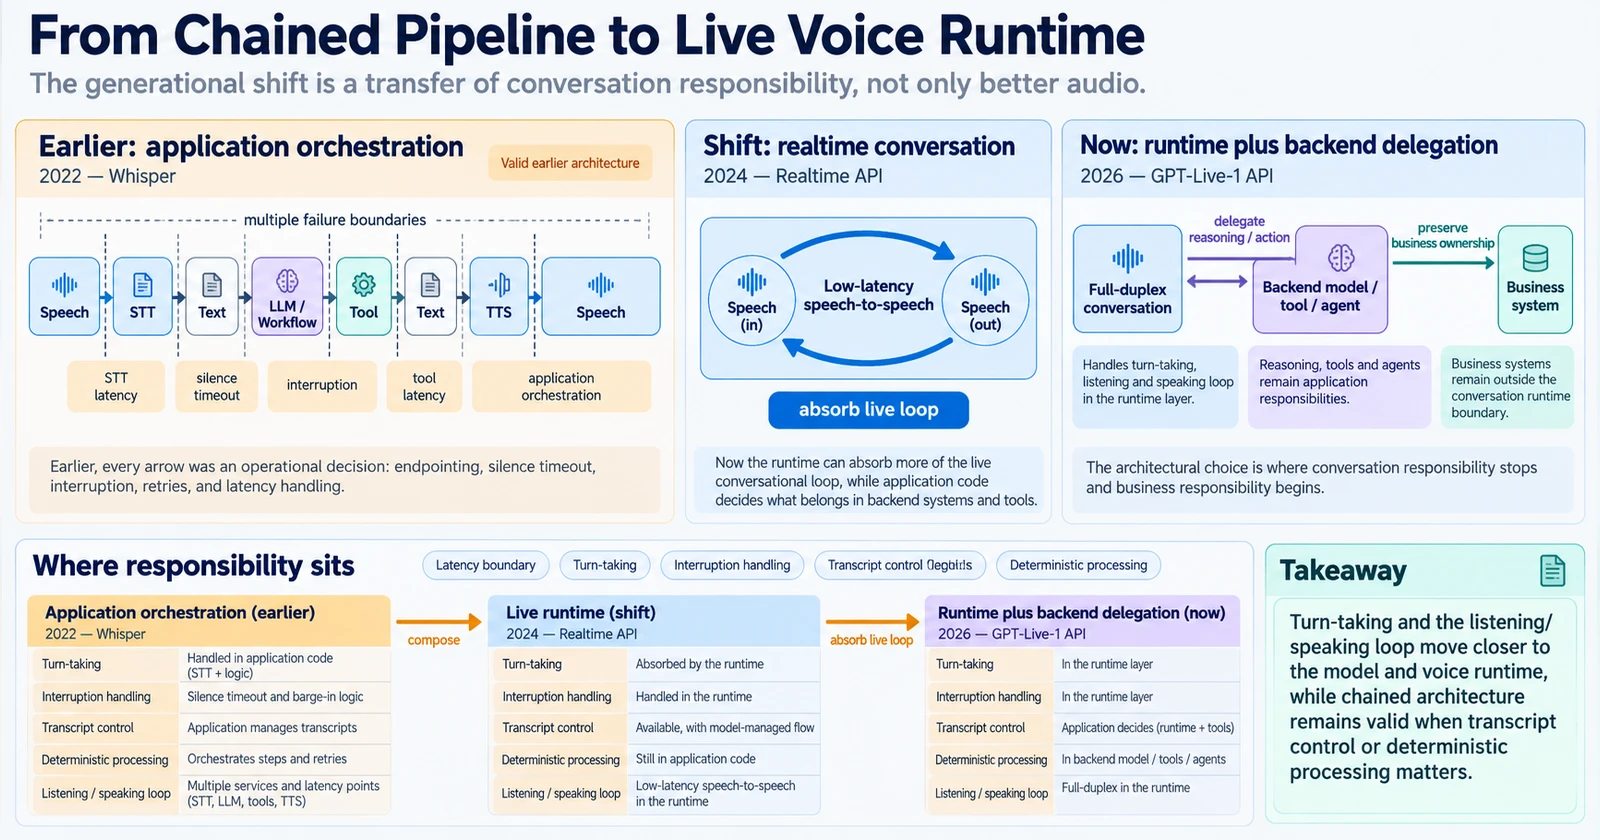
당시 내가 만들던 흐름을 단순화하면 이랬다.
Speech → STT → Text → LLM/Workflow → Tool → Text → TTS → Speech
한 줄로 보면 간단하다. 운영 관점에서는 화살표 하나하나가 failure boundary였다.
STT가 늦으면 전체 응답이 늦어진다. Silence timeout을 짧게 잡으면 말을 끊고, 길게 잡으면 Agent가 답답해진다. LLM이 Tool을 호출하는 동안 사용자가 다시 말하면 turn state를 어떻게 처리할지도 정해야 한다. 각 서비스가 자기 latency와 error model을 갖고 있기 때문에 end-to-end 경험은 가장 느리거나 불안정한 구간의 영향을 받는다.
n8n을 쓴 이유도 여기에 있었다. 당시 내 목적은 Voice Model 자체를 만드는 것이 아니라 여러 서비스를 빠르게 조립해 “이 업무 흐름이 실제로 가능한가”를 확인하는 PoC였다. n8n의 Switch와 Webhook, API node는 이런 실험에 상당히 유용했다.
하지만 PoC가 동작할수록 오히려 한계도 잘 보였다.
대화의 turn-taking, interruption, endpointing까지 application orchestration이 많이 알고 있어야 했다. Voice UX가 좋아지려면 workflow가 음성이라는 modality의 특성까지 떠안아야 했다.
그래서 당시의 Voice Agent는 내게 AI application이면서 동시에 작은 realtime system이었다.
Realtime API와 GPT-Live는 무엇을 바꿨을까?
큰 변화는 음성 인식 정확도가 조금 더 좋아진 데 있지 않았다.
OpenAI는 2024년 10월 Realtime API를 공개하면서 여러 모델을 이어 붙이지 않고 low-latency speech-to-speech application을 만들 수 있는 경로를 제시했다. 그리고 2026년 9월 GPT-Live-1 API는 듣기와 말하기를 동시에 처리하는 full-duplex conversation과 interruption handling, 별도 backend model·tool·agent로 reasoning/action을 위임하는 구조를 제공하기 시작했다.
내가 체감하는 세대 차이는 이 문장에 가깝다.
예전에는 개발자가 대화를 조립했다. 이제는 모델과 Voice Runtime이 대화 자체를 운영하기 시작했다.
말을 언제 끝냈는지, 상대가 끼어들었는지, 잠깐 생각하고 있는지 같은 live conversation의 문제를 model/runtime layer가 더 많이 흡수한다.
물론 chained architecture가 사라진 것은 아니다. STT → LLM → TTS 구조는 여전히 transcript control, deterministic processing, 특정 모델 조합이 필요한 곳에서 유효하다. 중요한 것은 개발자가 선택할 수 있는 architecture가 달라졌다는 점이다.
예전에는 “어떤 STT와 TTS를 붙일까?”가 먼저였다면, 지금은 “live conversation을 어디까지 Voice Runtime에 맡기고, 어디서 backend Agent나 business system으로 넘길까?”가 더 중요한 질문이 됐다.
기업용 Voice Agent에서 진짜 어려운 것은 무엇일까?
Voice Model이 자연스럽게 말하기 시작하면 재미있는 일이 생긴다.
Speech 문제가 줄어든 자리에 Enterprise system 문제가 그대로 드러난다.
고객이 누구인지 알아야 한다. 현재 어떤 Case나 주문을 이야기하는지 알아야 한다. 본인 확인이 필요한 작업인지 판단해야 한다. Knowledge만 읽어주면 되는지, 실제 Tool을 실행해도 되는지 구분해야 한다. 통화를 사람이 이어받아야 할 때 context를 넘겨야 한다. 통화가 끝나면 결과를 CRM에 남겨야 한다.
Outbound라면 더 까다롭다. 지금 이 고객에게 전화를 걸어도 되는가, 이미 성공한 call을 다시 걸고 있지는 않은가, voicemail인지 짧은 human hangup인지 불명확할 때 retry해도 되는가 같은 문제가 생긴다.
이런 문제는 Voice Model이 자연스럽게 말한다고 해결되지 않는다.
Deloitte가 2026년 미국 은행 Contact Center 임원들을 조사했을 때 77%가 신규 기술을 기존 시스템·도구와 통합하는 것을 현대화의 주요 과제로 꼽았다. 금융업 한정 조사이므로 전체 산업의 수치로 확대하면 안 되지만, 실제 Enterprise Voice AI를 설계할 때 내가 체감한 문제와 방향은 잘 맞는다.
Conversation은 Voice Agent가 잘할 수 있다. Business lifecycle까지 넘겨줄 이유는 없다.
내가 Voice Agent architecture를 볼 때는 적어도 다음 책임을 따로 본다.
- Conversation — 듣고 말하고 interruption을 처리하는 live interaction
- Telephony — PSTN/SIP/phone number와 실제 call transport
- Business Context — CRM customer, Case, opportunity, campaign 같은 업무 context
- Tool Execution — 무엇을 조회하고 어떤 mutation을 허용할지
- Durable State — call 이후에도 남아야 할 canonical business state
- Authority — AI가 어디까지 스스로 처리하고 언제 사람이나 다른 system에 넘길지
이 경계를 한 제품이 모두 가져갈 수도 있고, 여러 시스템이 나눠 가질 수도 있다.
중요한 것은 먼저 그 사실을 알고 선택하는 것이다.
기업용 Voice Agent는 실제로 어디에 배치될까?
실무에서는 크게 세 가지 패턴으로 나눠보는 것이 편했다.
첫 번째는 Inbound self-service다. 고객이 전화를 걸고, Agent가 intent를 파악하고, 계정이나 주문 상태를 조회하거나 간단한 업무를 처리한다. 해결할 수 없거나 권한이 부족하면 Human Agent로 넘긴다.
두 번째는 Outbound engagement다. CRM이나 campaign signal이 call을 시작하고, Voice Agent가 고객에게 연락한다. Lead qualification, appointment confirmation, reminder, follow-up 같은 업무가 여기에 들어간다.
세 번째는 Human Agent Assist다. 고객과 실제 상담원이 통화하고, AI는 뒤에서 transcription, knowledge retrieval, suggested answer, next-best action, summary를 제공한다.
같은 Voice Model이 세 곳에 모두 들어갈 수 있다.
그렇다고 운영 계약까지 같은 것은 아니다.
Inbound에서는 authentication과 human escalation이 중요할 수 있다. Outbound에서는 누가 전화를 받을 자격이 있는지, 언제 다시 걸 수 있는지, 어떤 결과를 CRM에 기록할지가 더 중요해진다. Agent Assist에서는 최종 발화와 business decision의 authority가 사람에게 남는다.
같은 Voice AI라도 business authority 구조는 전혀 다를 수 있다.
CRM, CCaaS, CPaaS, Realtime API는 어떻게 다를까?
Voice Agent 시장을 보다 보면 제품 기능표가 금방 길어진다.
나는 어느 제품이 기능이 더 많은지를 비교하기보다 어느 layer까지 vendor에게 맡기려는 제품인가를 먼저 보는 편이 더 유용했다.
CRM-native 접근은 customer context와 business action 가까이에서 출발한다. 이미 CRM이 고객 identity와 workflow의 중심이라면 자연스럽다.
CCaaS는 queue, routing, recording, workforce, analytics, human agent desktop까지 Contact Center 전체를 하나의 platform에서 운영하려는 경우 강점이 있다.
CPaaS는 phone number, call control, media transport 같은 communications primitive를 개발자가 세밀하게 조립할 수 있게 한다.
Realtime Model API는 대화 intelligence와 realtime audio capability를 application이 직접 구성할 자유도가 크다. 그만큼 session lifecycle, telephony, backend state를 application이 더 많이 소유하게 된다.
그리고 Ultravox 같은 specialist Voice Runtime은 그 사이에 있다. full CCaaS를 도입하지 않고도 voice-first agent runtime과 telephony integration, Tool/RAG 같은 primitive를 사용하려는 접근이다.
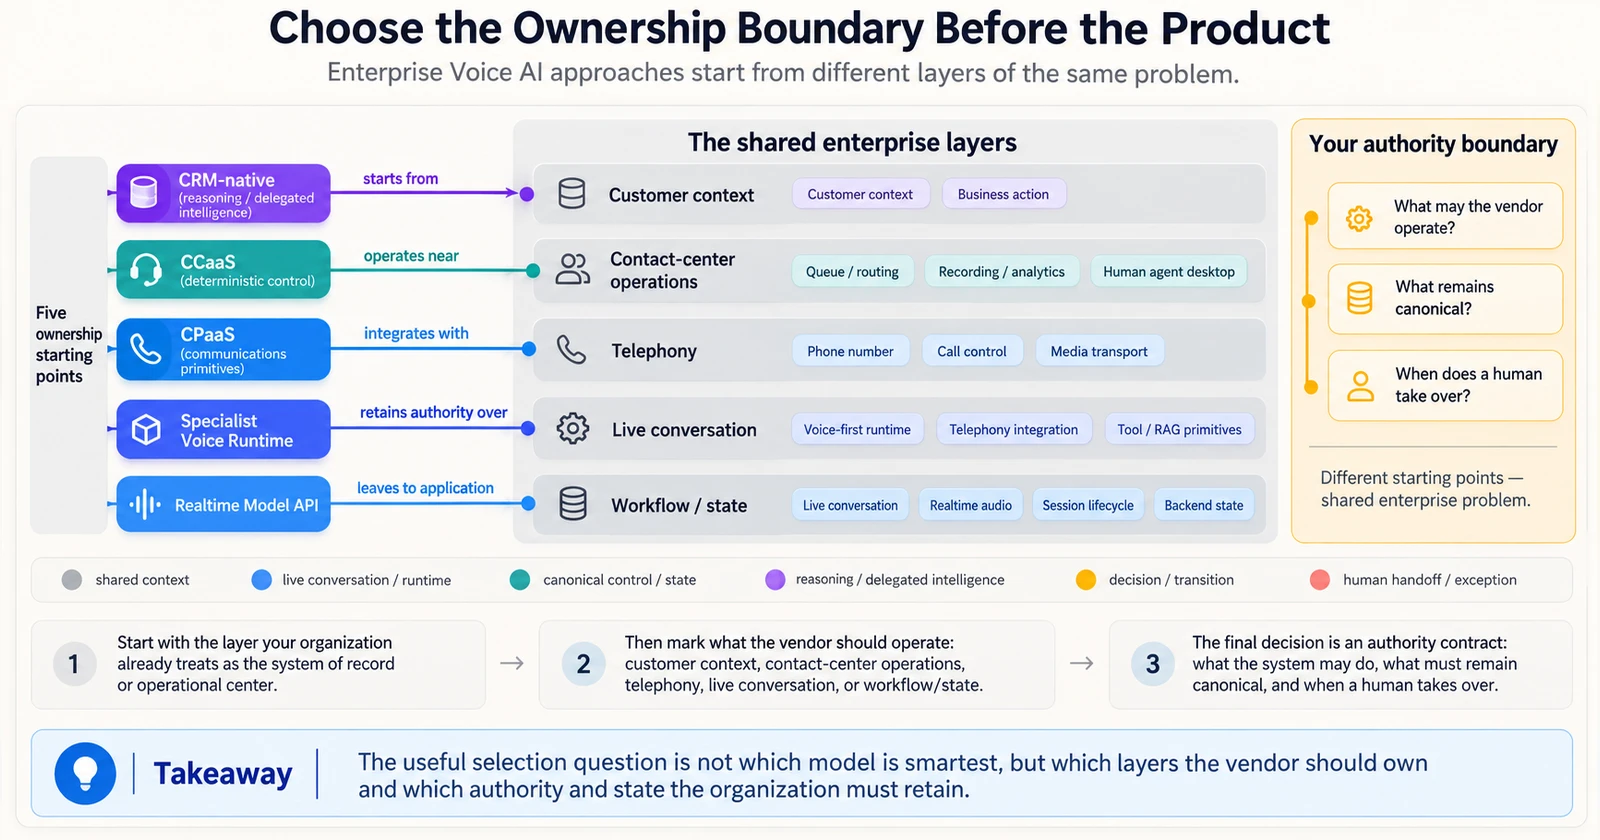
여기서 좋은 질문은 “어느 제품이 최고인가?”가 아니다.
우리 조직은 어느 layer까지 vendor에게 맡기고, 어느 authority와 state를 직접 가지고 있어야 하는가?
이 질문에 답하면 제품 선택은 오히려 단순해진다.
내가 Ultravox를 흥미롭게 본 이유
내가 Ultravox를 테스트하게 된 이유도 “가장 좋은 Voice AI를 찾겠다”는 생각과는 조금 달랐다.
이미 Salesforce가 있었다. Salesforce는 customer와 campaign의 business state를 가지고 있었다. Telephony provider도 별도로 선택할 수 있었다. 이 구조를 모두 갈아엎고 싶었던 것이 아니었다.
바꾸고 싶었던 것은 그 사이의 Voice Runtime이었다.
Ultravox는 공식 문서에서 BYOT, Bring Your Own Telephony를 표방하고 Twilio, Telnyx, Plivo, Exotel과 SIP 연결을 지원한다. Inbound와 Outbound call, transfer, DTMF 같은 voice-specific primitive도 제공한다.
내가 매력을 느낀 부분은 이것이었다.
CRM은 CRM로 남고, Telephony는 Telephony로 남은 채, 대화를 처리하는 layer만 교체하거나 삽입할 수 있었다.
실제 outbound pilot을 설계하면서도 이 원칙을 유지하려고 했다. Salesforce가 누가 call 대상인지와 업무 상태를 소유하고, Voice Runtime은 live conversation에 집중하며, telephony provider는 실제 call transport를 맡는 식이다.
여기서 특정 provider나 object 구조까지 들어가면 이 글의 범위를 벗어난다. 중요한 것은 구성요소 이름이 아니라 responsibility boundary다.
이 구조는 Ultravox에만 가능한 정답도 아니다. Realtime API를 직접 감싸도 되고, CRM-native 또는 CCaaS 쪽으로 더 많은 책임을 넘겨도 된다.
다만 내가 이미 가진 시스템을 보존하면서 voice layer를 빠르게 바꿔보고 싶었던 상황에서는 specialist runtime이 꽤 실용적인 선택이었다.
Human handoff는 Voice Agent의 실패일까?
Voice Agent 데모를 만들면 자연스럽게 “사람 없이 어디까지 되나”를 보여주고 싶어진다.
Production에서는 조금 다르게 봐야 한다.
2026년 Gartner 조사에서는 GenAI 고객 서비스를 제공하는 기업이 Human Agent로 연결되는 선택지를 제공하는 것이 필수라고 답한 고객이 87%였다.
이 역시 특정 조사 결과를 모든 고객에게 일반화할 수는 없다. 하지만 architecture 차원에서는 중요한 신호다.
AI가 사람에게 넘기는 것을 failure path로 설계하면 시스템은 필요 이상으로 일을 붙잡는다.
반대로 정상 state transition으로 보면 설계가 달라진다.
Voice Agent가 충분한 context와 authority를 가지고 있으면 처리한다. Identity 확인이 필요하거나, 예외가 생기거나, 감정적 대응이 필요하거나, business consequence가 큰 판단이라면 사람에게 넘긴다. 그리고 그때까지 수집한 context를 같이 전달한다.
좋은 자동화는 모든 일을 혼자 처리하는 자동화가 아니다. 자기가 처리할 수 없는 상태를 알고 다음 authority에 넘길 수 있는 자동화다.
이건 Voice Agent라고 특별히 다른 원칙은 아니다.
다만 전화는 실시간이다. 그래서 실패한 interaction을 나중에 조용히 고치는 것이 어렵고, Human handoff가 더 눈에 띈다.
Voice는 조금 이상한 인터페이스다
GPT-Live 같은 기술을 보면 재미있는 부분이 있다.
최신 Voice Model이 해결하려고 애쓰는 문제를 하나씩 보면 대부분 인간 대화의 특성이다.
사람은 중간에 끼어든다. 잠깐 생각한다. “음…” 하고 시간을 번다. 상대가 말을 끝내기 전에 반응하기도 한다. 너무 빨리 대답하면 무례하게 느끼고, 너무 늦으면 연결이 끊긴 것처럼 느낀다. 말의 내용뿐 아니라 tone과 cadence에도 의미를 싣는다.
AI가 더 자연스럽게 통화하려면 이 인간적인 불완전함을 더 잘 이해해야 한다.
API에는 이런 문제가 별로 없다.
API는 상대가 숨을 고르고 있는지 기다리지 않는다. JSON payload가 민망해서 머뭇거리거나, 다른 endpoint의 말을 중간에 끊지도 않는다.
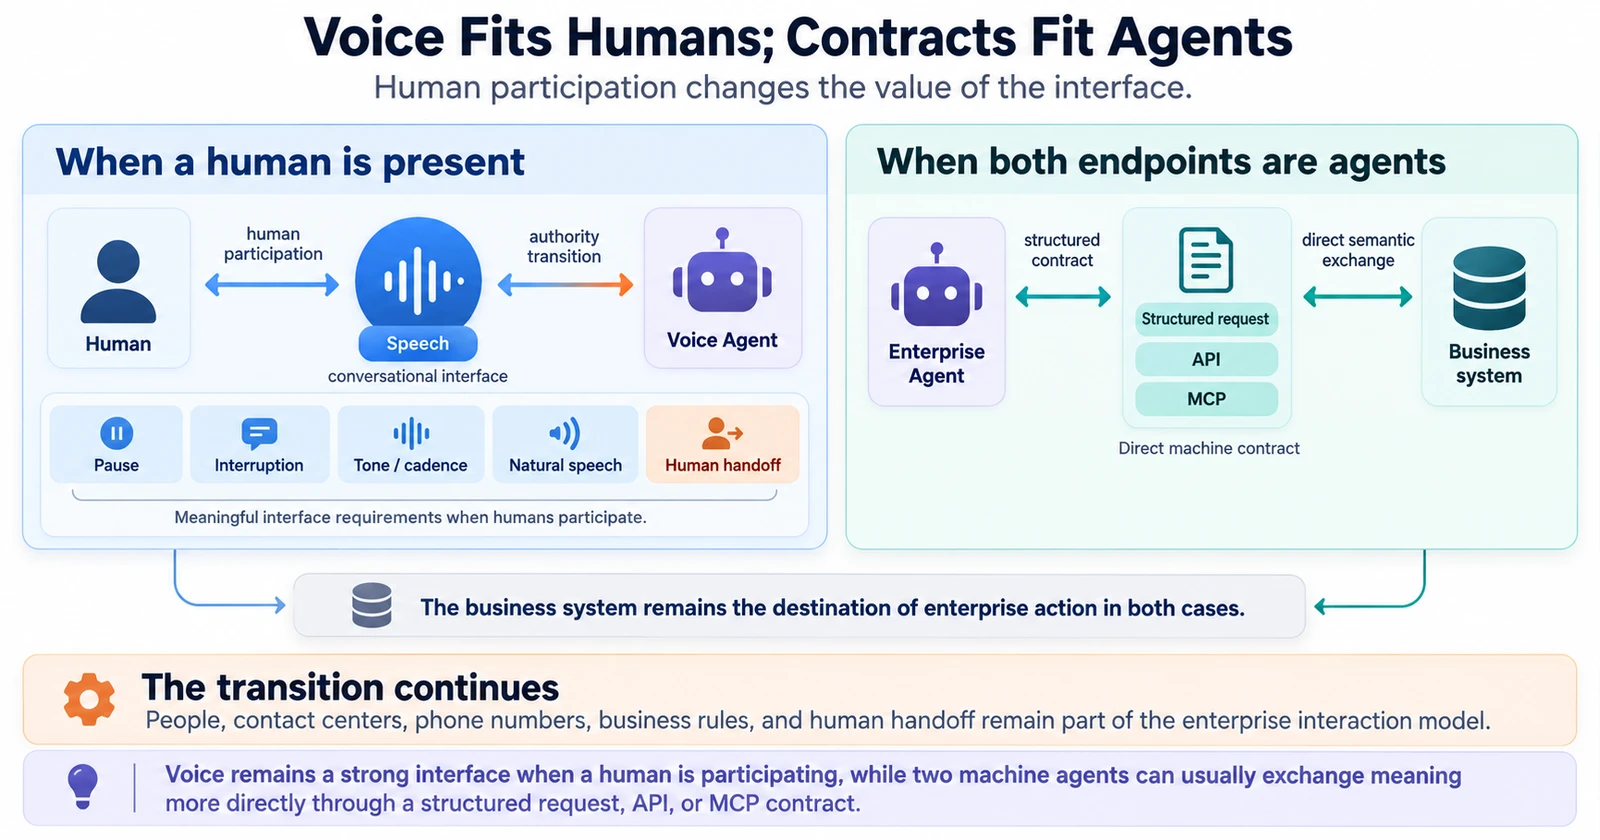
Voice Agent는 상당히 미래적인 기술처럼 보이지만, 역설적으로 상대편에 인간이 있다는 전제를 아주 강하게 가진 기술이기도 하다.
Agent끼리 통화한다면 Voice가 필요할까?
여기까지 만들고 나면 약간 냉소적인 질문이 하나 남는다.
지금 우리가 만드는 Voice Agent의 기본 그림은 대체로 이렇다.
AI Agent → Voice/Phone → Human
조금 더 시간이 지나면 사람도 자기 Agent를 앞에 세울 수 있다.
Human → Personal Agent → Voice/Phone → Enterprise Agent → Business System
그런데 양쪽 끝의 실제 대화 주체가 모두 Agent가 되는 순간은 어떨까?
그때도 한쪽 AI가 문장을 만들고, 음성을 합성하고, 전화망으로 전송하고, 다른 쪽 AI가 다시 음성을 인식하고 의미를 복원해야 할까?
둘 다 machine이라면 structured request나 API, MCP 같은 contract로 이야기하는 편이 더 빠르고 정확할 수 있다.
물론 전화가 곧 사라진다는 이야기는 아니다.
전화번호와 Contact Center, CRM, 업무 규정, 고객 습관은 오랫동안 남는다. 무엇보다 당분간 전화의 한쪽에는 계속 사람이 있을 것이다.
그래서 나는 오히려 Voice Agent를 인간이 사라진 이후의 기술보다 인간과 AI가 함께 일하는 긴 전환기의 기술로 보는 편이 더 자연스럽다고 생각한다.
2년 전에는 여러 API를 붙여 AI가 사람처럼 대화하게 만드는 것 자체가 PoC의 핵심이었다.
지금은 그 대화가 놀랄 만큼 자연스러워졌고, 개발자의 관심은 그 바깥의 identity, authority, state, integration으로 이동하고 있다.
그리고 어느 순간 전화 양쪽에 모두 Agent가 앉게 된다면, 그때부터는 “얼마나 사람처럼 통화하느냐”보다 다른 질문이 더 재미있어질 것이다.
둘 다 Agent인데, 왜 굳이 전화를 하고 있지?