
같은 API 방식을 붙였는데, 첫 테스트에서 기대한 답과 일치한 이메일은 17건 중 10건이었다. 처음에는 모델 차이를 의심했다. 코드를 열어보니 내가 만든 질문 어댑터에도 문제가 있었다. 그것을 고친 뒤에는 업무 경계를 다시 읽어야 했다.
Azure에 Decision Model이 들어왔다는 소식이 반가웠다
JEV로 이메일 분류를 만들어본 뒤, 이런 모델이 기업 업무에 잘 맞겠다는 생각을 했다. 고객에게 보낼 문장을 생성할 필요는 없었다. 정해진 업무 범위 안에서 어느 부서가 처리해야 하는지, 지금 요청한 일이 무엇인지 판단하면 됐다.
다만 기업 환경에 적용하는 문제는 조금 달랐다. 고객 이메일을 외부 모델 서비스로 보내는 경로를 새로 설명하고 보안 검토를 받아야 한다는 점이 마음에 걸렸다. JEV의 보안성에 결함이 있다는 판단은 아니다. 내가 검토하던 환경에서 새로운 서비스의 데이터 처리 조건과 도입 경로를 확인해야 하는 부담이 있었다.
그래서 Luna 기반으로 소개된 OpenAI의 Decisions API를 기다리고 있었다. OpenAI의 발표는 미리 정한 질문과 유한한 답에 Luna의 판단을 집중시키는 방식으로 설명했다. 그 와중에 Microsoft Decision-1이 Azure Foundry에 나왔다는 소식을 봤다.
이미 Azure를 사용하는 기업에서 검토할 선택지가 하나 생겼다는 점이 반가웠다. Azure에 있다는 이유로 보안 검토가 끝나는 것은 아니다. 서비스의 데이터 처리 조건, 배포 유형, 접근 통제는 따로 확인해야 한다. 그래도 프로젝트에 가져갈 수 있을지 검토하는 출발점은 달라졌다.
Microsoft의 공식 소개와 Foundry 개발 문서를 읽고 기존 JEV 워크플로를 옮겨보기로 했다. 여기까지는 모델 선택에 관한 일이었다. 실제로 붙이고 나니 질문을 설계하는 일이 다시 시작됐다.
업무 기준은 유지했고, 질문을 전달하는 쪽을 바꿨다
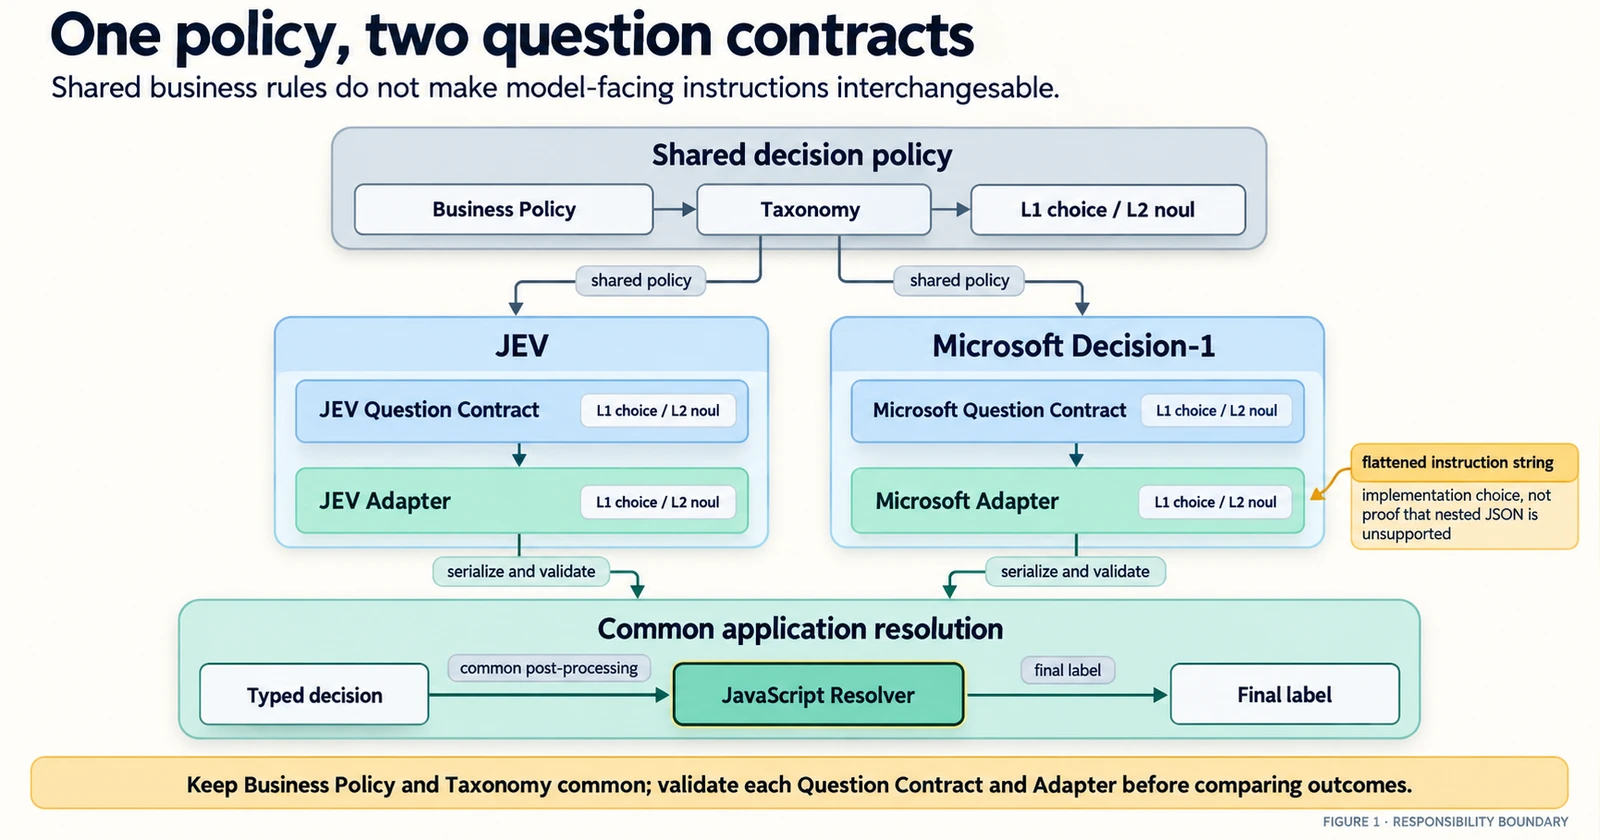
기존 n8n 워크플로는 먼저 큰 업무 영역을 고르고, 그 안에서 세부 요청을 판단했다. L1은 Engineering, Sales, Post Sales, Training, Other의 다섯 영역이었다. L2는 선택된 영역에서 부품 처리, 기술지원, 시운전, 수리 같은 행동을 판정했다. 최종 레이블은 JavaScript resolver가 확정했다.
JEV는 jev-1.13.0을 사용했다. Microsoft 쪽에서도 같은 업무 정책과 Taxonomy, 같은 두 단계 흐름과 후처리를 유지했다. 달라진 것은 모델과 질문을 전달하는 어댑터였다.
제목의 ‘같은 Decision API’는 공통된 방식의 typed decision을 뜻한다. 두 제품의 API 구현이나 내부 모델이 같다는 뜻은 아니다. 이번 워크플로에서는 업무 영역을 고르는 choice와 세부 조건을 판단하는 noul을 사용했다. Microsoft는 score 유형도 제공하지만 이번 비교의 중심은 아니었다.
JEV 원본의 instructions는 task, decision_rule, thread_rule 같은 구조화된 필드를 사용했다. Microsoft 어댑터에서는 이를 문장 문자열로 변환했다. 아래는 전체 API 요청이 아니라 대표 필드 구조를 축약한 비교다.
{
  "jev_excerpt": {
    "instructions": {
      "task": "Select exactly one Level 1 business domain...",
      "decision_rule": "Classify the action the sender expects...",
      "thread_rule": [
        "Prioritize the newest sender-authored message",
        "Use quoted history for unresolved follow-ups"
      ]
    }
  },
  "microsoft_adapter_excerpt": {
    "instructions": "Select exactly one Level 1 business domain...\nClassify the action the sender expects...\nPrioritize the newest sender-authored message\nUse quoted history for unresolved follow-ups"
  }
}
이 변환은 우리의 구현 선택이었다. Microsoft가 중첩 JSON 질문을 이해하지 못한다거나 반드시 긴 자연어가 필요하다는 검증은 하지 않았다. state에 JSON을 사용할 수 있다는 공식 지원과, JEV의 중첩 질문 형식이 그대로 호환되는지는 다른 문제다.
첫 결과를 보고 모델부터 평가할 뻔했다
첫 17건 테스트에서 기존 기대 레이블과 일치한 것은 10건이었다. ‘이 모델은 이 업무에 덜 맞나?’라는 생각이 들었다. 하지만 모델 응답을 평가하기 전에 실제로 무엇을 보냈는지부터 확인했다.
초기 통합에서도 시행착오가 있었다. 모델 카탈로그 이름을 배포명으로 넣어 호출이 실패했고, 이를 고친 뒤에는 Google Sheets의 시트 지정 방식 때문에 결과 저장이 실패했다. 단건으로 호출과 저장을 확인한 후에야 17건 비교를 시작했다. API가 성공했다는 사실과 분류가 맞았다는 사실은 따로 확인해야 했다.
질문 변환 코드를 검토하다가 L2의 thread_rule 처리에서 결함을 발견했다. 원본 값은 문자열인데, 어댑터가 배열인 것처럼 전개하고 있었다.
// Broken: a string is spread into individual characters.
const brokenRules = [...(i.thread_rule || [])];

// Fixed: preserve a string as one rule.
const rules = Array.isArray(i.thread_rule)
  ? i.thread_rule
  : (typeof i.thread_rule === "string" ? [i.thread_rule] : []);

q.instructions = [i.task, i.decision_rule, ...rules]
  .filter(Boolean)
  .join("\n");
첫 실행에서 부품 처리 질문의 instructions는 156줄이었다. 그중 154줄이 한 글자였다. 고친 뒤에는 정상적인 3줄로 돌아왔다. 모델이 내가 작성한 지침을 읽고 있다고 생각했는데, 그 전에 어댑터가 문장을 망가뜨린 것이다.
그런데 2차 결과는 11/17이었다. 버그 하나로 전체 실패를 설명할 수는 없었다. 이 결함은 L2에 있었고, 여전히 큰 업무 영역을 잘못 고르는 L1 사례가 남았다.
더구나 바꾸지 않은 L1 질문에서도 이전 부품 주문·배송에 대한 짧은 후속 메일의 판단이 달라졌다. 따라서 10에서 11로 오른 한 건을 전부 버그 수정 효과라고 읽을 수도 없었다. 구현 결함과 실행 간 변동이 함께 관찰된 상태였다.
‘견적’과 ‘교체’의 경계를 더 직접적으로 썼다
설치된 장비의 모터나 PCB 견적을 요청한 이메일이 일반 영업 견적으로 분류됐다. 이전 예비 부품 견적의 최신 가격을 확인한 메일도 비슷했다. 둘 다 가격을 물었지만, 업무상으로는 이미 설치된 장비의 부품 처리에 해당했다.
기존 JEV 정책에도 예비 부품 견적을 일반 영업에서 제외하는 규칙은 있었다. Microsoft용 질문에서는 충돌할 때 어느 기준을 먼저 적용해야 하는지 더 직접적으로 적었다. 설치 장비의 부품 견적은 price, offer, quotation이라는 표현이 있어도 Post Sales라는 문장을 보강했다.
또 다른 이메일은 두 제품 모델의 교체 호환성을 확인하는 요청이었다. Microsoft는 이를 수리 쪽으로 보냈다. 하지만 현재 상대에게 요구한 일은 수리 수행이 아니라 기술적 확인이었다. 호환성이나 상호 교체 가능성을 확인하는 질문은 Engineering에 해당한다는 경계를 강조했다.
업무 정책을 모델마다 다르게 만든 것은 아니었다. 같은 정책의 충돌 지점을 더 분명히 표현했다. Microsoft Learn의 권고 역시 state, instructions, 선택지 설명을 실제 업무 데이터에 맞춰 조정하고 레이블로 평가하는 방식이다. 다만 이 권고가 어느 모델에 어떤 문구가 더 잘 맞는지까지 대신 알려주지는 않는다.
세 건을 고쳤더니, 맞던 한 건이 틀렸다
3차에서 최종 일치는 13/17로 올랐다. 부품 견적과 호환성 사례가 개선됐다. 그런데 처음에는 맞았던 시운전 일정 조정 요청이 Other로 밀려났다. 일부 경계를 보강하는 동안 다른 경계가 흔들린 것이다.
같은 질문 설정으로 4차를 반복했더니 결과는 12/17이었다. 이전 부품 주문·배송 스레드에 대한 후속 요청이 다시 달라졌다. 질문을 바꿔 발생한 회귀와, 질문을 바꾸지 않았는데 생긴 결과 변동은 구분해야 했다. 원인을 확인하지 않은 채 모델의 난수성이나 서비스 변경 때문이라고 단정하지도 않았다.
| 테스트 | 변경 또는 확인 | 업무 영역 일치 | 최종 레이블 일치 |
|---|---|---|---|
| 1차 | 초기 어댑터 | 13/17 | 10/17 |
| 2차 | L2 문자열 직렬화 수정 | 14/17 | 11/17 |
| 3차 | 부품 견적·호환성 경계 보강 | 16/17 | 13/17 |
| 4차 | 같은 질문 설정 반복 | 15/17 | 12/17 |
| 5차 | 시운전·일정 조정 경계 보강 | 17/17 | 14/17 |
| 6차 | 부품 공급과 수리 서비스 구분 | 17/17 | 15/17 |
| 7차 | 최종 질문 설정 반복 | 17/17 | 15/17 |
표는 기존 expected label에 대한 일치다. 각 차수는 같은 17건을 사용했다. 4차는 3차와, 7차는 6차와 같은 질문 설정을 반복했다.
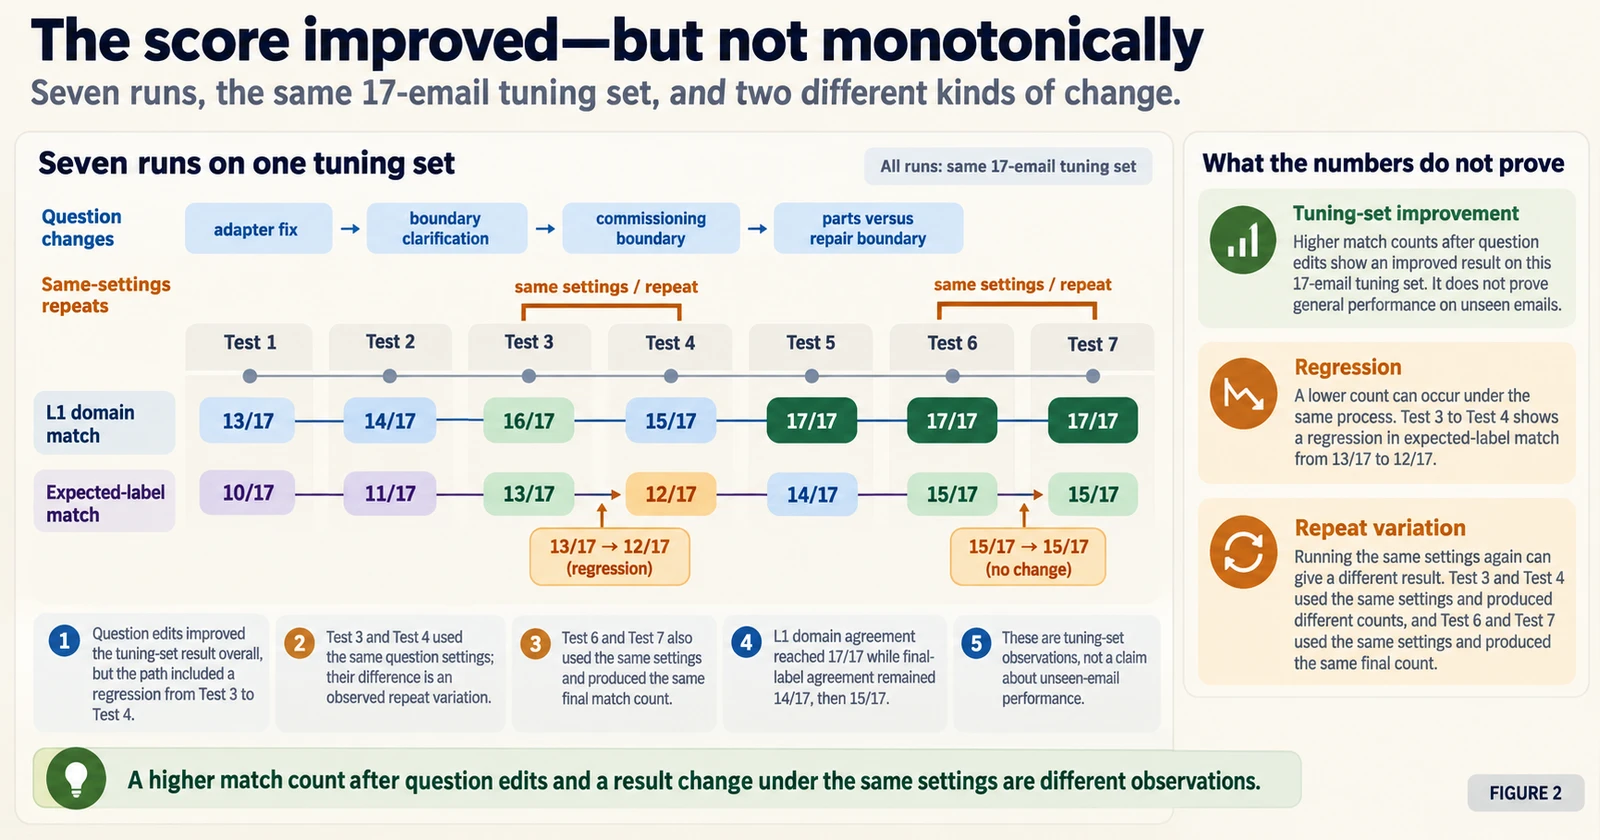
5차에서는 초기 시운전과 일정 재조정이 Post Sales에 해당한다는 경계를 명시했다. 큰 업무 영역은 17건 모두 기대와 일치했다. 그래도 최종 레이블은 14/17이었다. 이제 남은 문제는 세부 요청 쪽에 있었다.
수리에 쓸 부품을 달라는 것과 수리를 해달라는 것은 달랐다
가장 오래 들여다본 사례는 진단 후 모터와 PCB를 공급해달라는 이메일이었다. 큰 업무 영역은 맞았지만, 세부 판단은 Repair였다.
고객의 최종 목적은 장비를 고치는 것이었다. 하지만 이 이메일을 받은 사람이 당장 해야 할 일은 부품을 보내는 것이었다. 수리 서비스의 수행 주체와 현재 요청의 수신자를 구분해야 했다.
L2에는 다음 경계를 보강했다. 아래는 연구 노트에 기록한 실제 지침의 핵심 발췌다.
SPARE_PART_HANDLING: If technicians recommended replacing parts
and the sender now asks to RECEIVE THE PARTS, treat the current
requested outcome as Spare Part Handling, not repair service.

REPAIR_RMA: Only mark repair when the recipient is expected
to perform repair/RMA/service replacement. Shipping recommended
components for someone else to install is not the repair service.
이후 해당 이메일은 Spare Parts로 바뀌었다. 6차는 15/17이었고, 7차에서도 최종 레이블 17개가 모두 6차와 같았다.
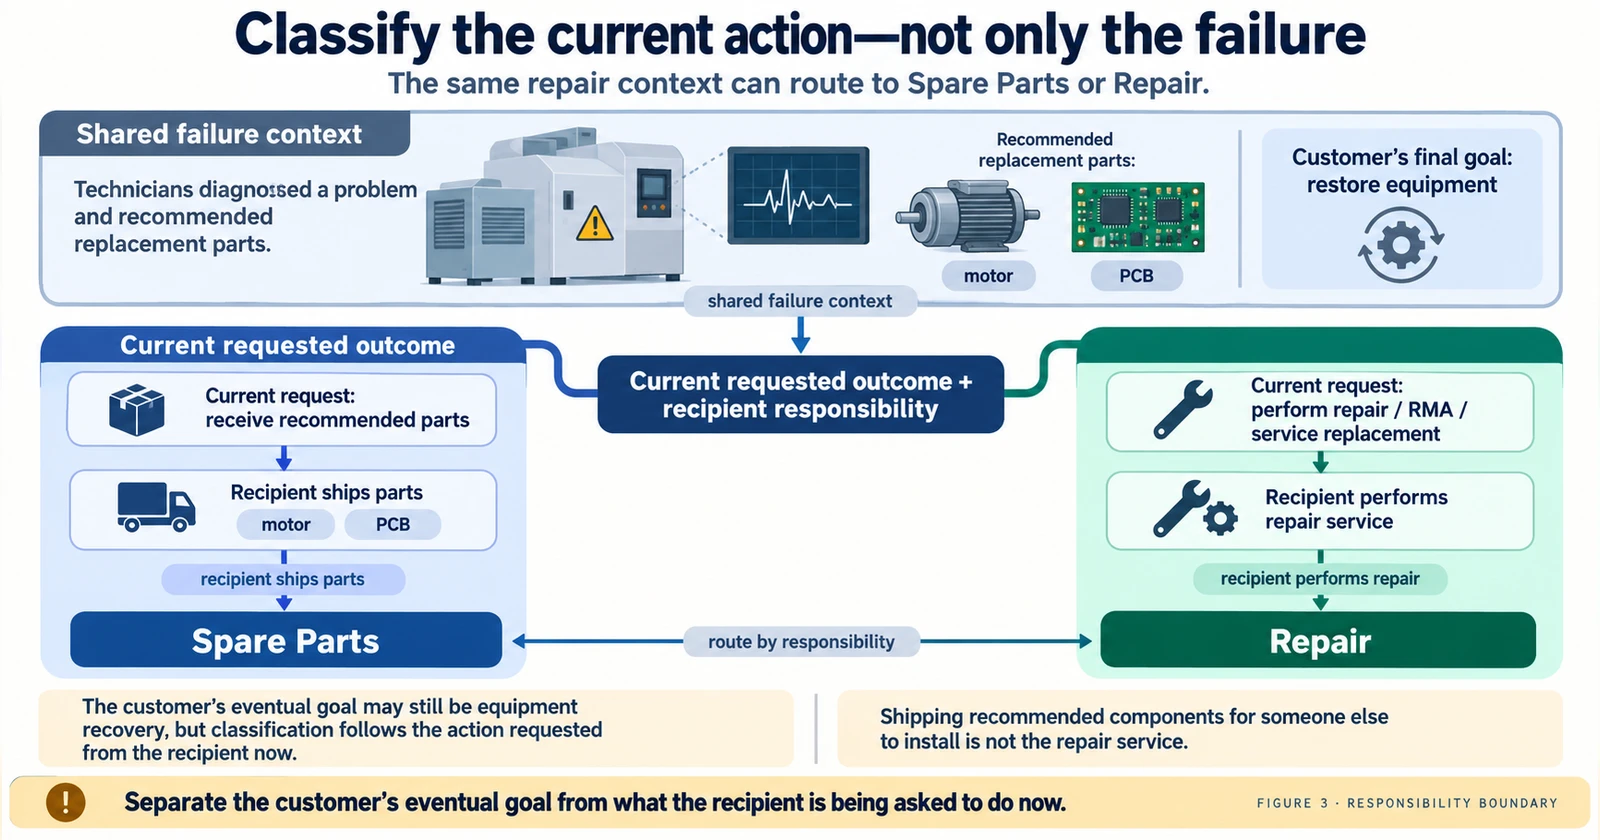
질문을 길게 쓴 덕분이라고 결론내릴 근거는 없다. 이번 샘플에서는 ‘누가 무엇을 해야 하는가’를 더 구체적으로 표현한 뒤 결과가 개선됐다. 길이 자체의 효과와 경계 설명의 효과는 따로 실험해야 한다.
15/17을 100%라고 부르지 않은 이유
기존 레이블과 다른 두 건은 현장 방문과 수리의 경계 사례였다. 앞선 JEV와 GPT-6 Luna 비교 글에서도 사람 레이블을 다시 검토할 필요가 있다고 다뤘다.
두 건을 보류하면 나머지 15건은 모두 일치했다. 그렇다고 사람 레이블이 틀렸다고 확정한 것은 아니다. 한 사례에서는 최종 Microsoft가 현장 지원을, JEV가 수리를 선택했다. 전체 Microsoft와 JEV 결과는 16/17 일치했고, 완전히 같지는 않았다.
더 중요한 한계는 이 17건이 질문을 고치는 데도 쓰였다는 점이다. 최종 15/17은 튜닝에 사용한 데이터 안에서의 적합도다. 새로운 이메일에 대한 일반화 정확도가 아니다. 두 번 같은 결과를 얻은 것도 반복 안정성의 예비 관찰이며, 항상 같은 결과가 나온다는 보증은 아니다.
비용과 속도도 같은 범위에서 읽었다.
| 항목 | JEV 기존 실행 | Microsoft 최종 실행 |
|---|---|---|
| 입력 토큰, 17건 합계 | 94,996 | 89,802 |
| 출력 토큰, 17건 합계 | 4,060 | 149 |
| 공개 단가 기준 추정 API 비용 | USD 0.003989832 | USD 0.003771684 |
| 기존 기대 레이블 일치 | 15/17 | 15/17 |
비용은 입력 100만 토큰당 USD 0.042, 출력 무료라는 공개 단가를 사용한 계산이다. Microsoft 단가는 2026년 10월 12일 확인했고, JEV 값은 기존 연구의 공개 단가 계산을 유지했다. 실제 청구·할인·재시도·개발 및 검수 시간을 포함하지 않는다. 출력이 짧다는 사실도 무료 출력 조건에서는 비용 절감의 직접 근거가 아니다.
Microsoft 7회 실행의 17건 E2E 시간은 2.926~4.353초였다. 기존 JEV와 동일 환경·계측으로 동시 비교한 결과가 아니므로 속도 순위를 만들지 않았다.
초기 부품 견적 사례에서는 잘못된 Sales 판단에도 0.9627, 0.9521의 선택 확률이 붙었다. 95%를 넘는 점수만 보고 자동 배정했다면 자신 있게 잘못 보내는 자동화가 됐을 것이다. 점수와 자동 실행 권한의 관계는 이번에도 애플리케이션에서 검증할 문제로 남았다.
모델을 바꿔도 업무 정책은 하나여야 한다
이번 경험을 기업 프로젝트에 가져간다면, 업무 기준과 모델별 질문 표현을 함께 관리하겠다. 거대한 라우터를 먼저 만들 필요는 없다. 질문 버전과 실제 송신 요청을 코드와 함께 남기는 것부터 시작할 수 있다.
| 관리 대상 | 소유할 책임 |
|---|---|
| Business Policy와 Taxonomy | 업무 담당자가 확정하는 공통 분류 기준 |
| 모델별 Question Contract | 같은 기준을 모델에 전달하는 표현과 경계 |
| Adapter | 직렬화, API 요청과 typed 응답 검증 |
| 평가 기록 | 질문 버전별 결과, 회귀, 반복 변동 |
| 실행 정책 | 자동 처리·검토·보류와 실제 업무 변경 |
다음 실험에서는 질문을 고정하고, 아직 사용하지 않은 이메일을 업무 담당자가 독립 판정한 Holdout으로 비교하려 한다. 같은 스레드가 두 데이터셋에 들어가지 않도록 하고, 부품·수리·호환성·시운전처럼 자주 충돌한 경계를 포함해야 한다. 질문 표현만 바꾸는 실험도 필요하다. 그래야 어댑터 표현과 경계 보강의 영향을 조금 더 구분할 수 있다.
반복 실행의 decision flip과 높은 점수의 오분류를 기록하고 Calibration을 확인하는 일도 남았다. 최종 경제성은 토큰 비용보다 사람의 수정과 검수까지 포함한 Human Accepted Outcome 한 건당 비용으로 봐야 한다. 이 검증들은 아직 완료하지 않았다.
Azure에서 검토할 수 있는 Decision Model이 생겼다는 소식은 여전히 반갑다. 다만 API 연결 뒤에도 개발자의 일이 남았다. 질문이 온전히 전달됐는지, 같은 업무 기준을 읽고 있는지, 한쪽을 고치면서 다른 쪽을 흔들지는 않았는지 확인해야 했다.
Question Engineering의 가치는 그 과정에 있었다. 현업이 정한 기준을 모델이 소비하는 질문으로 만들고, 그 기준이 실제 판단으로 이어졌는지 확인하는 일이다. 이번에는 익숙한 17건에서 질문을 다듬었다. 다음에는 질문을 고정한 채 처음 보는 이메일에 물어볼 차례다.