
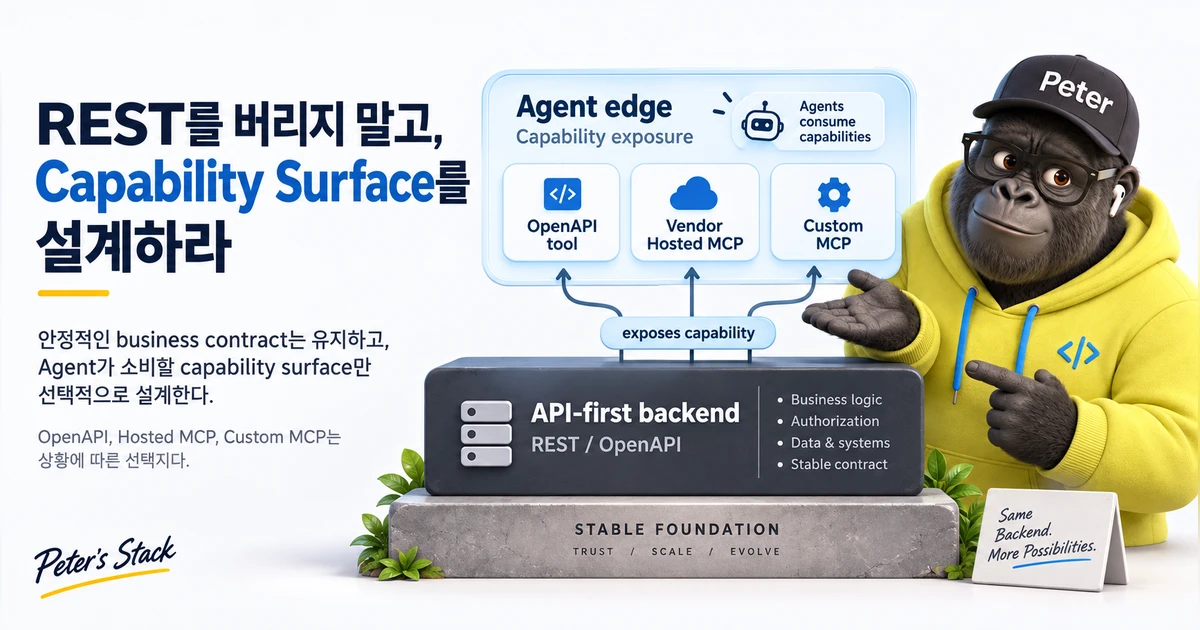
MCP가 빠르게 확산되면서 Enterprise AI 설계에서도 비슷한 질문을 자주 듣게 된다. “앞으로 Agent가 시스템을 호출하는 표준이 MCP라면, 지금까지 만든 REST API와 API Gateway도 결국 MCP로 바꿔야 하는 것 아닌가?”
내 생각은 반대에 가깝다. MCP를 도입한다고 안정적인 backend integration을 다시 만들 이유는 없다. 이미 업무 규칙과 보안, transaction, audit을 책임지는 API가 있다면 그 기반은 그대로 두는 편이 낫다. 새롭게 설계해야 하는 것은 backend 자체가 아니라 Agent가 어떤 capability를 발견하고, 어떤 계약으로 사용하며, 어디까지 접근할 수 있게 할 것인가다.
기존 API-first backend 위에서 어떤 capability를 어떤 Agent-facing surface로 노출할 것인가?
이 글에서는 MCP를 새로운 만능 integration layer로 보지 않는다. 기존 OpenAPI, vendor가 제공하는 Hosted MCP, 직접 만드는 Custom MCP를 어떤 기준으로 조합할지 Enterprise 아키텍처 관점에서 정리해보려 한다.
REST와 MCP는 같은 자리를 놓고 경쟁하지 않는다
REST API는 애플리케이션끼리 데이터를 주고받고 업무 기능을 실행하기 위한 일반적인 integration contract다. URL, HTTP method, request/response schema, authentication, error semantics를 기반으로 안정적인 system-to-system boundary를 만든다.
MCP가 해결하려는 문제는 조금 다르다. Agent 또는 AI client가 외부 capability를 발견하고 이해하고 호출할 수 있는 공통 interface를 제공한다. 중요한 차이는 호출 대상이 단순한 endpoint가 아니라 “모델이 선택할 수 있는 capability”라는 점이다.
예를 들어 내부에 이미 다음과 같은 API가 있다고 해보자.
POST /salesforce/cases
GET  /customer/360
POST /erp/orders
GET  /documents/search
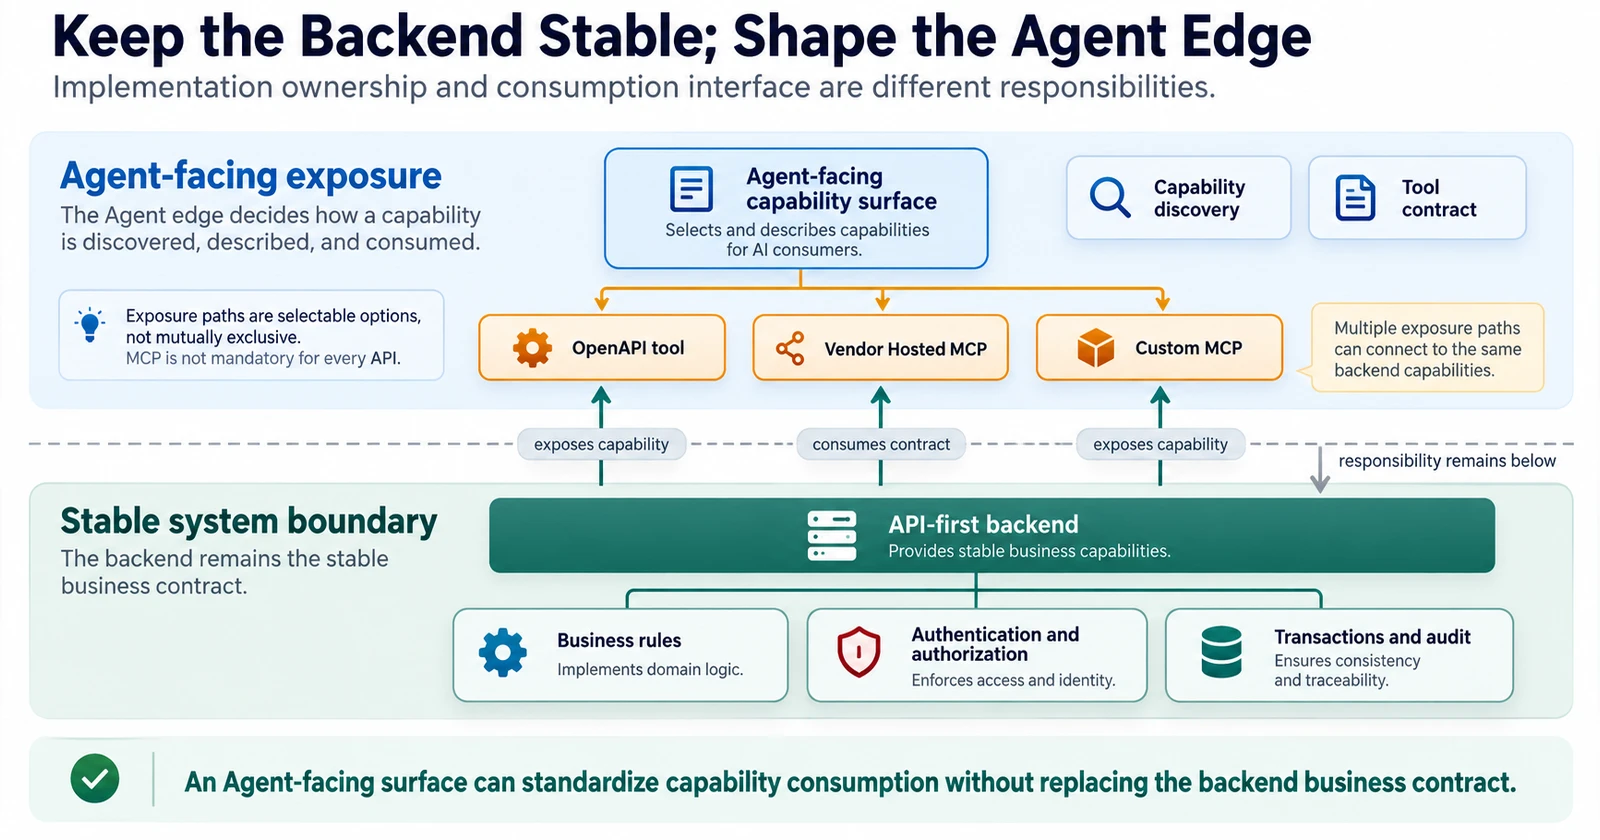
이 API들이 안정적으로 운영되고 있다면 Agent를 붙인다는 이유로 전부 다시 구현할 필요가 없다. 어떤 것은 OpenAPI 기반 tool로 그대로 사용할 수 있고, 어떤 것은 vendor Hosted MCP를 통해 노출할 수 있으며, 여러 Agent와 client에서 반복적으로 재사용해야 하는 capability만 별도의 MCP surface로 승격할 수도 있다.
여기서 중요한 것은 implementation을 교체하는 것과 consumption interface를 표준화하는 것은 다른 문제라는 점이다.
MCP 2026-07-28 방향도 이런 운영 관점과 잘 맞는다. 최신 specification은 remote transport에서 protocol-level session 의존을 줄이고 self-contained HTTP request 중심으로 이동했다. 분산 추적을 위한 OpenTelemetry trace context 규칙도 명시되면서, MCP server를 특별한 장기 연결 시스템이라기보다 기존 HTTP infrastructure에서 운영 가능한 workload로 다루는 방향이 더 분명해졌다.
즉 “MCP를 쓰면 새로운 integration stack을 하나 더 만든다”기보다, 기존 운영 체계 위에서 Agent가 소비할 capability contract를 표준화한다고 보는 편이 정확하다.
실제 선택지는 세 가지에 가깝다
Enterprise 환경에서 모든 capability를 한 방식으로 노출할 필요는 없다. 실무적으로는 대략 세 가지 선택지를 조합하게 된다.
1. Existing OpenAPI를 그대로 사용한다
이미 잘 정의된 REST/OpenAPI가 있고 consumer가 특정 Agent runtime에 한정되어 있다면 가장 단순한 선택이다.
- schema와 error contract가 안정적이다.
- 인증과 authorization이 기존 API Gateway에서 관리된다.
- 호출하는 Agent가 한두 개뿐이다.
- dynamic discovery나 cross-client reuse 요구가 크지 않다.
이 경우 별도의 MCP server를 만드는 것은 capability를 늘리는 일이 아니라 adapter와 운영 책임을 하나 더 추가하는 일이 될 수 있다. MCP가 유행한다는 이유만으로 wrapper를 만드는 것은 architecture modernization이 아니다. 기존 boundary가 이미 충분하다면 유지하는 것이 더 단순하다.
2. Vendor Hosted MCP를 사용한다
반대로 vendor가 자신의 product capability를 Hosted MCP로 제공한다면 이야기가 달라진다.
Salesforce Hosted MCP Servers는 표준 server와 custom server를 제공하고, authenticated user의 권한 모델을 기반으로 Salesforce capability를 MCP client에 노출한다. Headless 360 MCP Server Beta는 수많은 Salesforce operation을 개별 tool로 전부 노출하는 대신 Discover, Describe, Dispatch 계열의 작은 surface 뒤에 배치한다.
이 구조의 장점은 단순히 “REST API를 직접 호출하지 않아도 된다”가 아니다. vendor가 자신이 가장 잘 아는 identity, permission, audit, capability catalog의 경계를 관리한다는 데 있다.
Microsoft Foundry도 비슷한 방향을 보여준다. Toolbox와 private tool catalog는 MCP, OpenAPI 등 여러 tool source를 중앙에서 관리하고, tool search를 통해 필요한 도구만 runtime에 드러내는 패턴을 제공한다.
이런 vendor-native capability라면 “직접 integration을 만들 것인가?”보다 vendor가 제공하는 governed surface를 우선 소비할 수 있는가?를 먼저 검토하는 편이 합리적이다.
3. Custom MCP를 만든다
Custom MCP는 모든 사내 API의 기본 목적지가 아니다. 재사용성과 governance의 가치가 추가 운영 복잡성을 넘어설 때 의미가 커진다.
예를 들어 처음에는 하나의 Azure Agent만 customer/360 API를 호출했다고 하자. 그때는 OpenAPI tool이면 충분할 수 있다. 그런데 시간이 지나 Microsoft Foundry Agent, ChatGPT, Salesforce-side Agent, Internal Copilot, n8n Agent workflow, Custom CLI agent가 같은 capability를 요구한다면 비용 구조가 달라진다.
각 consumer마다 schema mapping, auth 연결, tool description, versioning 규칙을 따로 유지하기 시작하면 MCP는 backend를 재작성하는 수단이 아니라 여러 AI consumer가 공유하는 capability contract로서 가치가 생긴다.
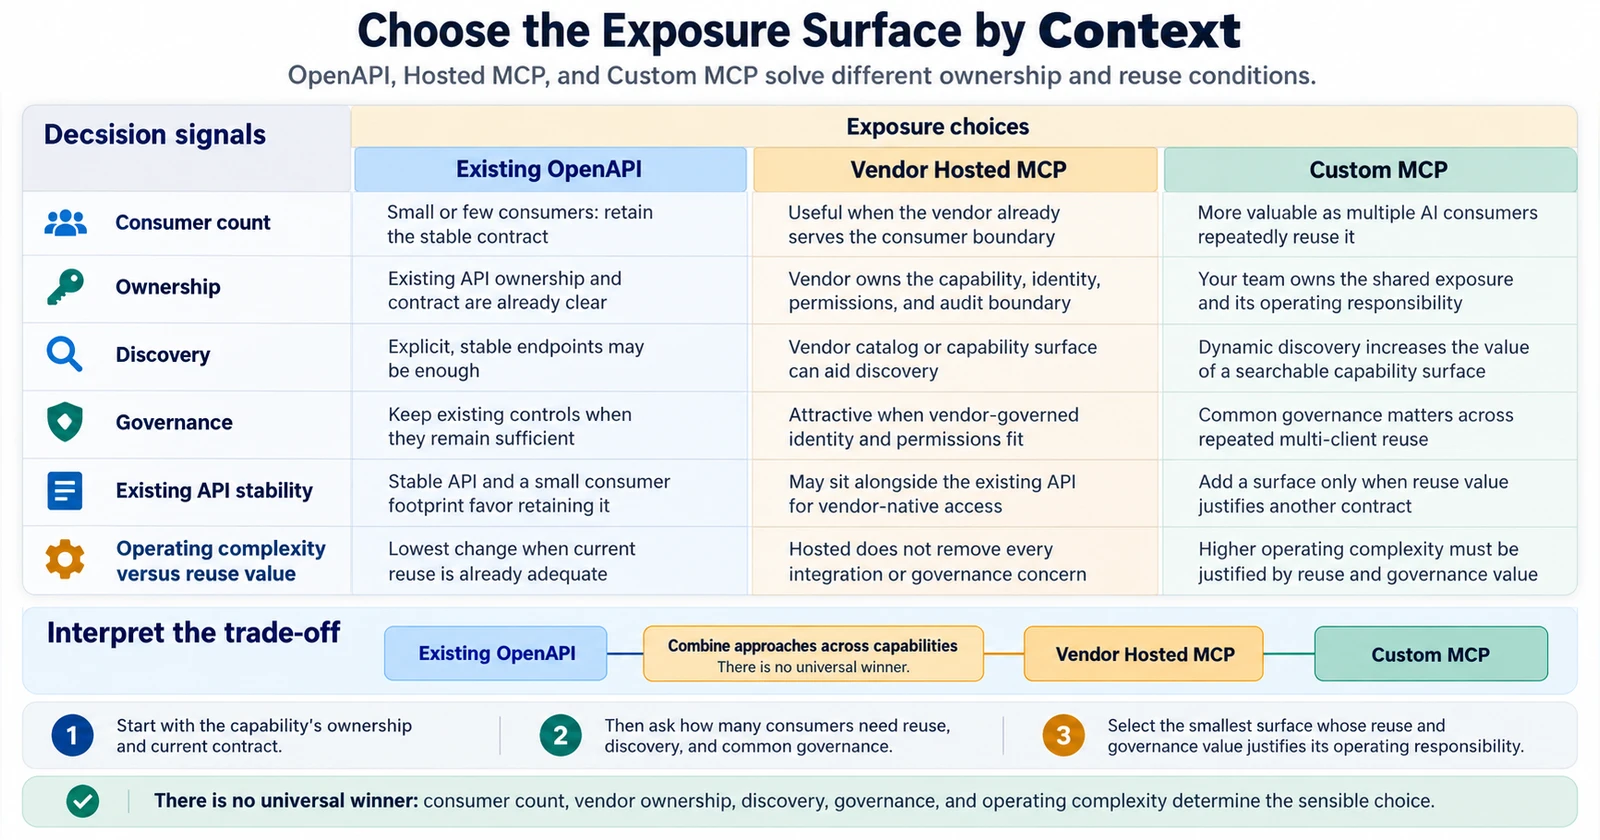
핵심은 “Custom MCP가 더 현대적이니까”가 아니다. 같은 capability를 여러 Agent와 client가 소비하면서 중복 integration 비용과 governance 비용이 커졌는가?가 판단 기준이다.
Tool이 많아지면 문제는 연결보다 선택이 된다
Capability를 연결하는 초기 단계에서는 tool 하나를 추가하는 일이 단순해 보인다. 하지만 Enterprise 환경에서는 tool 수가 곧 늘어난다.
CRM, ERP, 문서 검색, 데이터 플랫폼, ticketing, provisioning, analytics, deployment capability가 모두 Agent에게 연결되면 “호출할 수 있느냐”보다 현재 작업에 어떤 capability만 보여줄 것인가가 더 어려운 문제가 된다.
모델 context에 수백 개의 tool schema를 한꺼번에 넣는 방식은 비용뿐 아니라 selection quality 측면에서도 좋지 않다. Salesforce의 Headless 360이 수많은 operation 앞에 Discover/Describe/Dispatch라는 작은 surface를 두는 이유, Foundry Toolbox가 tool search를 통해 필요한 tool만 찾도록 하는 이유도 같은 문제를 가리킨다.
Discovery는 “무엇을 볼 것인가”의 문제다.
Authorization은 “무엇을 실제로 해도 되는가”의 문제다.
Tool search가 관련 capability를 잘 찾았다고 해서 그 실행이 곧 허용되는 것은 아니다. 반대로 사용자에게 권한이 있다고 해서 모든 tool을 항상 모델 context에 노출해야 하는 것도 아니다. 그래서 Enterprise Agent의 tool surface는 무제한 discovery보다 Curated Discovery에 가까워야 한다.
Enterprise capabilities
        ↓
Capability catalog
        ↓
Task / identity / context
        ↓
Relevant capability retrieval
        ↓
Bounded tool surface
        ↓
Agent planning
        ↓
Runtime authorization / policy
        ↓
Controlled execution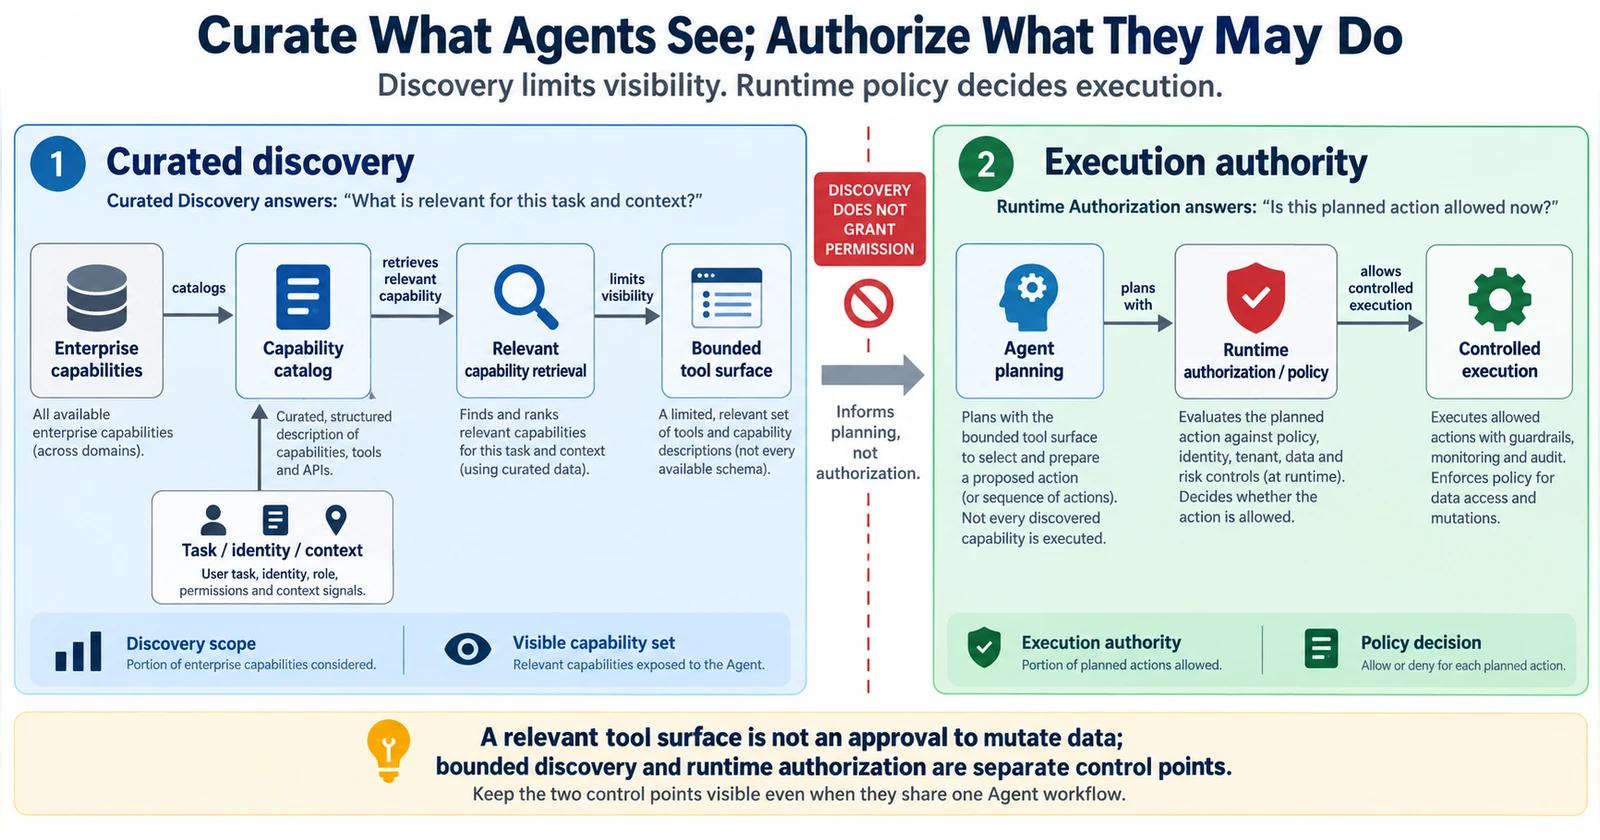
이 지점에서 이전에 다뤘던 “can call과 may execute는 다르다”는 원칙이 다시 연결된다. 다만 이번 글의 초점은 execution authority 자체가 아니다. 그 이전에 Agent가 무엇을 발견하고 선택할 수 있도록 설계할 것인가가 핵심이다.
Identity와 observability도 MCP라는 이름만으로 해결되지 않는다
MCP를 도입하면 interoperability는 좋아질 수 있다. 그렇다고 Enterprise security와 governance가 자동으로 완성되는 것은 아니다.
- tool call은 누구의 identity로 실행되는가?
- end-user identity가 backend까지 전달되는가, 아니면 shared service identity를 사용하는가?
- tenant와 record scope는 어디에서 검증되는가?
- destructive action은 어떤 approval policy를 거치는가?
- tool call과 downstream API call을 하나의 trace로 연결할 수 있는가?
- capability contract가 변경되었을 때 어떤 versioning과 regression test를 수행하는가?
Salesforce Hosted MCP처럼 vendor가 per-user permission과 audit 경계를 제공하는 경우도 있다. Microsoft Foundry처럼 Entra identity나 OAuth passthrough를 구성할 수 있는 환경도 있다. 하지만 이것은 각 구현이 제공하는 security contract이지 “MCP를 사용했다”는 사실 자체가 주는 보장은 아니다.
특히 기존 사내 API를 Custom MCP로 감쌀 때 이 차이를 놓치기 쉽다. MCP server에서 tool schema를 제공했다고 해서 underlying API의 business authorization을 없앨 수는 없다. 기존 API Gateway와 domain service가 책임지던 권한 검증과 mutation policy는 여전히 그 자리에 남아 있어야 한다.
내가 보는 Custom MCP의 손익분기점
그래서 새로운 Enterprise 프로젝트에서 처음부터 “MCP 전환 계획”을 만들지는 않을 것 같다. 대신 capability별로 다음 질문을 던질 것이다.
| 판단 질문 | 낮으면 | 높으면 |
|---|---|---|
| AI consumer 수 | 기존 OpenAPI 유지 | 공통 MCP surface 검토 |
| Vendor-native capability 비중 | 기존 integration 활용 | Hosted MCP 우선 검토 |
| Dynamic discovery 필요 | 고정 tool binding | catalog / tool search 검토 |
| 공통 governance 필요 | runtime별 설정 가능 | 중앙 capability surface 가치 상승 |
| 기존 API 안정성 | backend 개선 우선 | backend는 유지하고 exposure layer만 추가 |
즉 Custom MCP의 손익분기점은 endpoint 개수가 아니다. 여러 AI consumer 사이에서 같은 capability를 반복해서 연결하고 관리하는 비용이 얼마나 커졌는가에 있다.
Backend는 API-first, Agent edge는 Capability-first
Enterprise 시스템은 유행이 바뀔 때마다 backend를 다시 만들 수 없다. 오늘의 Agent runtime이 Microsoft Foundry일 수 있고, 내일은 다른 managed agent platform일 수 있다. ChatGPT, Salesforce, 내부 Copilot, n8n 같은 consumer가 동시에 존재할 수도 있다.
이 변화에 대응하려면 backend의 business contract는 안정적으로 유지하고 Agent-facing integration만 교체 가능하게 만드는 편이 낫다.
Backend는 API-first로 안정화하고, Agent edge에서는 Capability-first로 노출한다. MCP는 재사용·상호운용·governance의 가치가 추가 운영 복잡성을 넘는 지점부터 적용한다.
MCP가 REST를 없애는 미래보다, REST/OpenAPI와 MCP가 서로 다른 역할을 맡는 구조가 더 현실적이다. REST는 여전히 시스템의 안정적인 business contract로 남을 수 있다. MCP는 그 capability를 여러 Agent와 AI client가 발견하고 사용할 수 있게 만드는 공통 surface가 될 수 있다. Hosted MCP는 vendor-native 영역의 운영 부담을 줄일 수 있고, Custom MCP는 multi-consumer reuse가 충분히 커질 때 의미가 생긴다.
결국 중요한 것은 프로토콜 선택이 아니다. 어떤 capability를 누구에게, 어떤 context에서, 어떤 권한으로, 어떤 계약을 통해 노출할 것인가. Enterprise에서 MCP를 도입한다면, 나는 그 질문부터 시작할 것이다.