Web Search가 시장조사에서 전략 검증으로 바뀌는 순간: Market Lens로 RFP를 핀포인팅하는 법
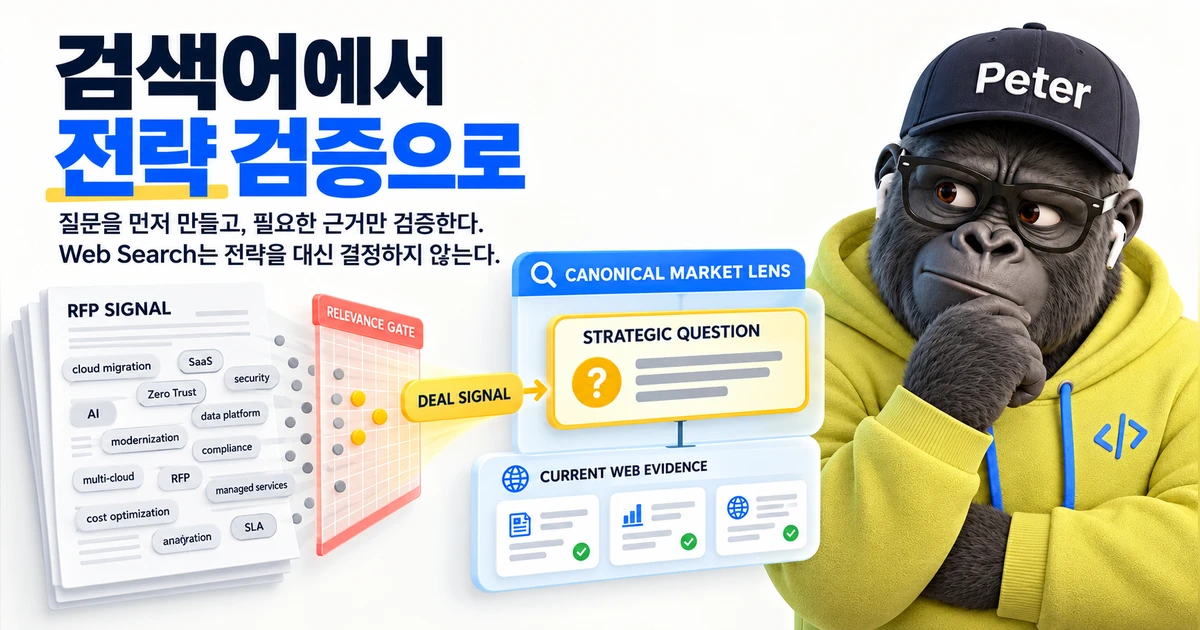
RFP의 키워드를 그대로 검색하는 대신 Deal Signal과 Canonical Market Lens를 교차해 전략 가설을 만들고, 필요한 evidence만 핀포인팅해 검증하는 Enterprise Web Search 구조를 살펴본다.

 Peter
RFP의 키워드를 그대로 검색하는 대신 Deal Signal과 Canonical Market Lens를 교차해 전략 가설을 만들고, 필요한 evidence만 핀포인팅해 검증하는 Enterprise Web Search 구조를 살펴본다.
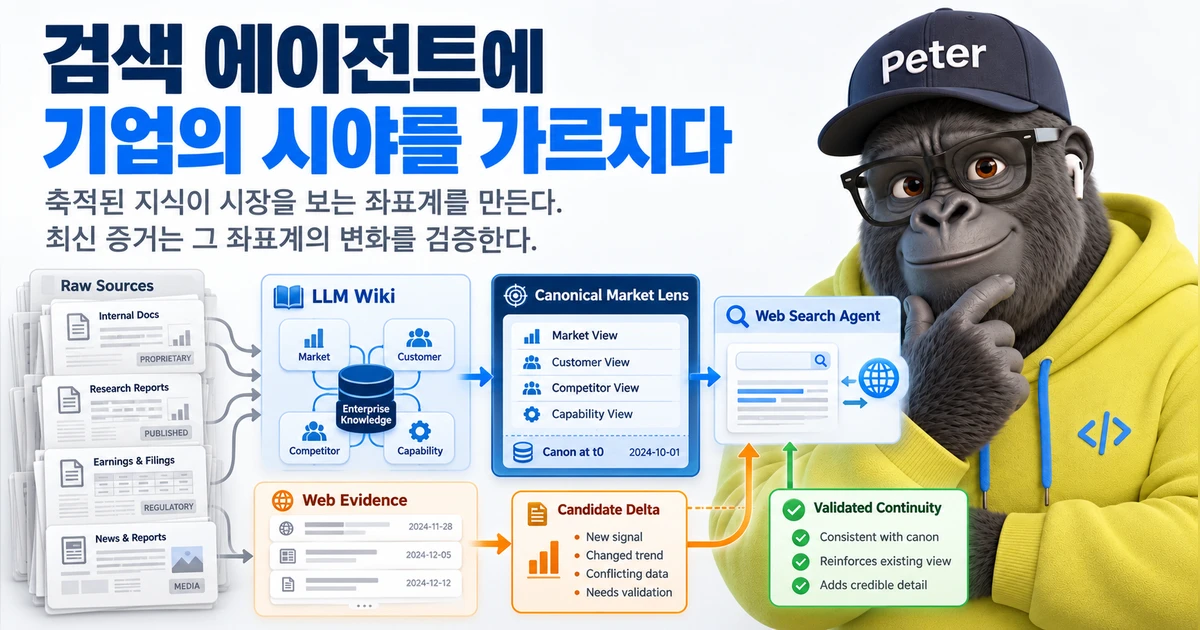
기업의 MI·경쟁사·고객·자사 역량을 매 요청마다 다시 넣는 대신 LLM Wiki로 지속적으로 LINT하고, Web Search Agent가 재사용할 Canonical Market Lens Skill로 만드는 방법을 살펴본다.
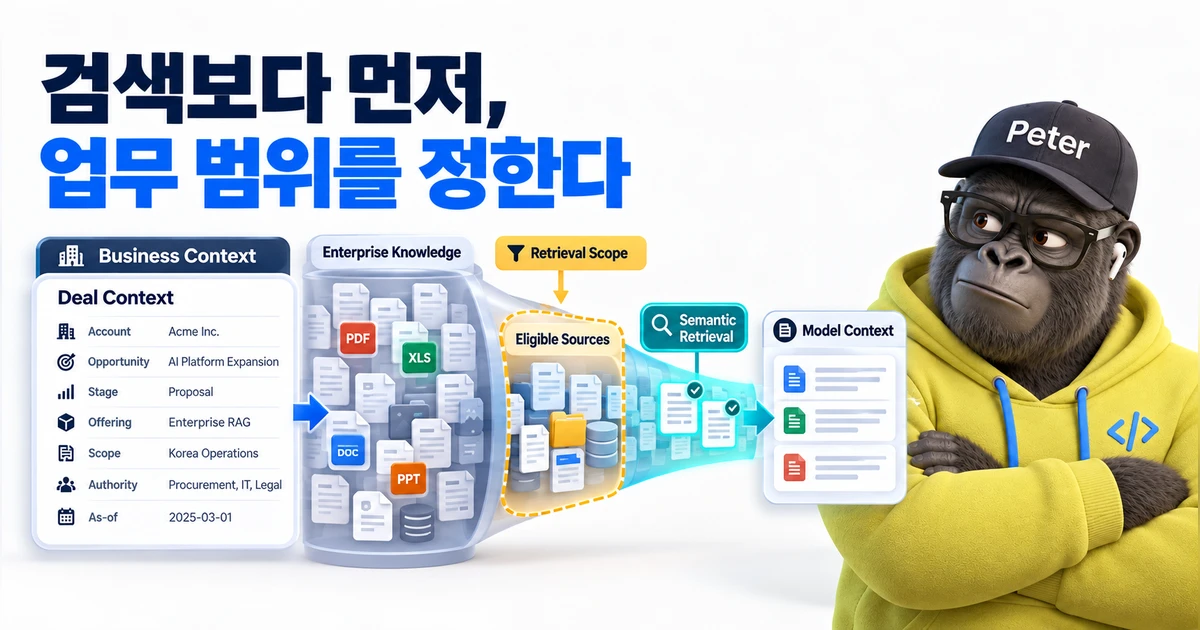
Enterprise RAG에서 semantic search보다 먼저 필요한 것은 현재 업무에 검색할 자격이 있는 데이터 범위를 정하는 일이다. Deal Context와 Retrieval Scope Contract로 candidate corpus를 제한한 실무 경험을 정리한다.
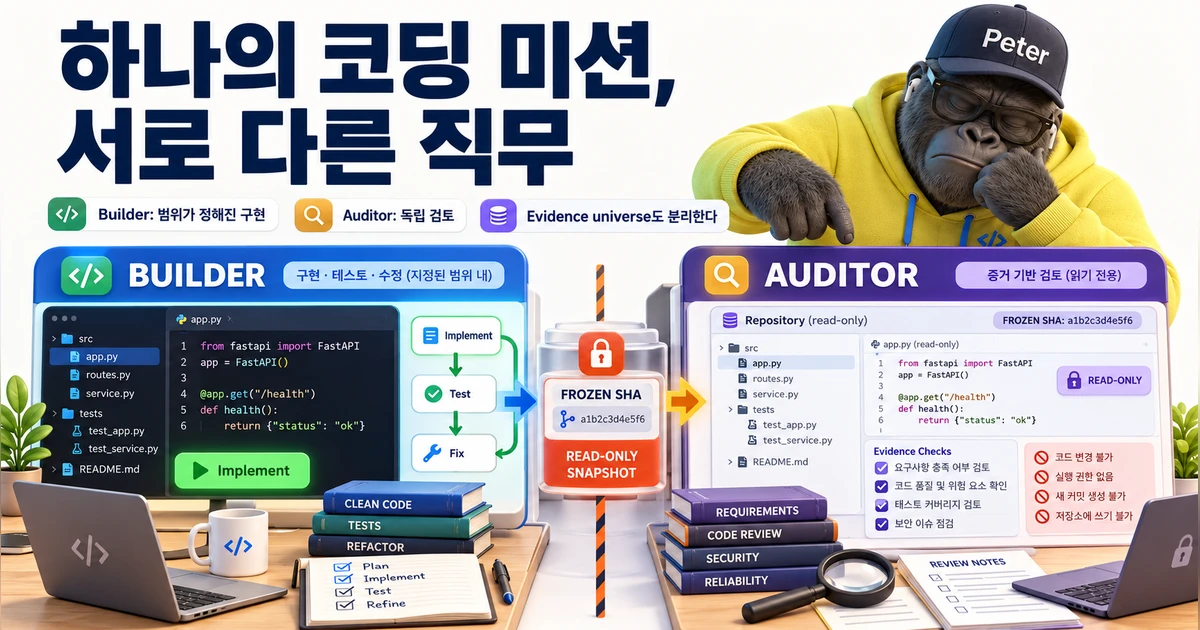
Codex가 구현하고 Antigravity가 독립 audit한 경험에서 출발해, 하나의 코딩 미션을 Builder·Investigator·Auditor·Verifier로 나누고 비용과 품질을 함께 최적화하는 Multi-Model Coding Harness를 정리합니다.
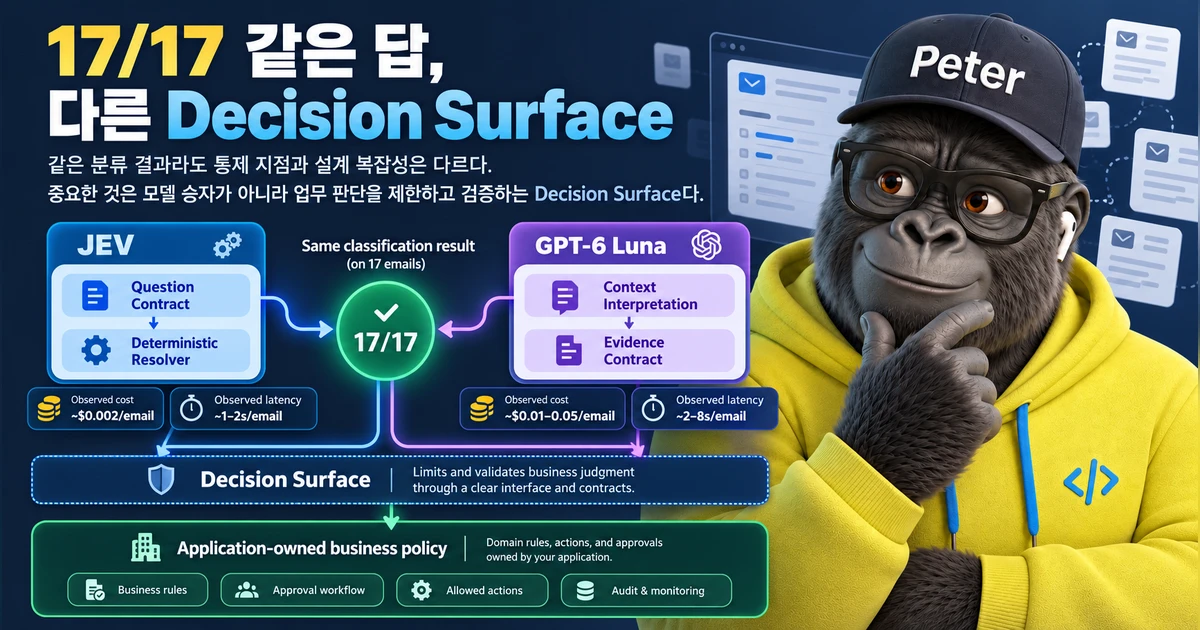
같은 17개 Email-to-Case를 JEV와 GPT-6 Luna로 분류했더니 결과는 모두 같았습니다. 실제 비용·latency·ground truth 사례를 바탕으로 두 방식의 설계 차이와 OpenAI Decisions API가 흥미로운 이유를 정리합니다.
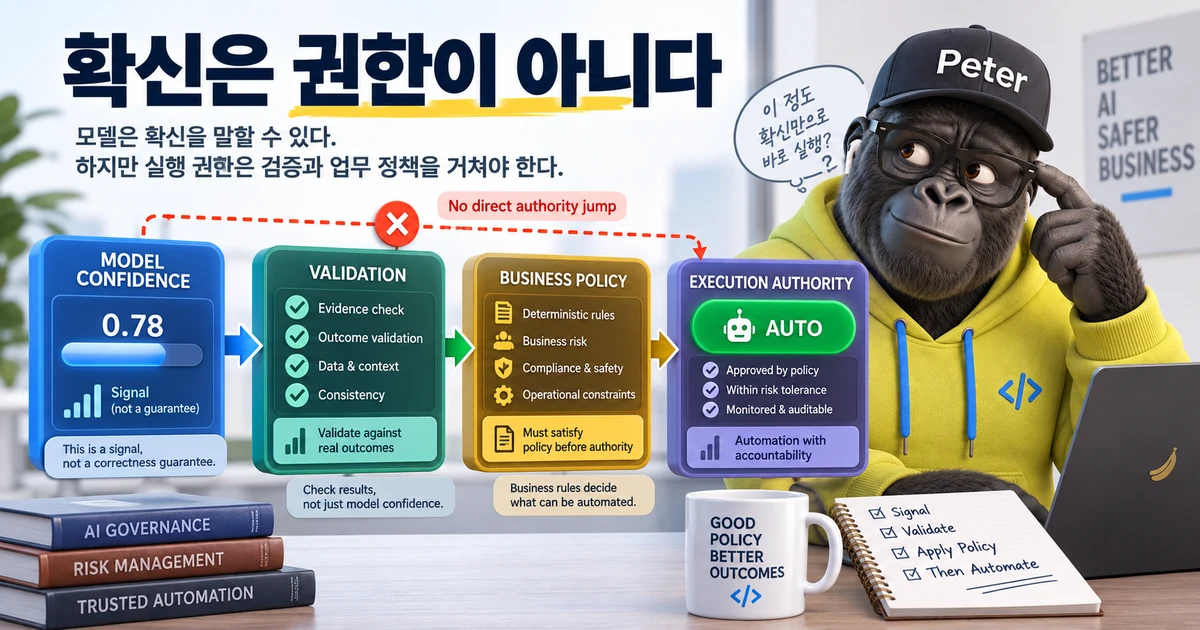
AI 분류 모델의 confidence를 곧바로 자동화 기준으로 써도 될까? JEV 이메일 분류 PoC 경험을 바탕으로 calibration, risk-coverage, AUTO·VERIFY·REVIEW 정책과 Human-in-the-loop를 실무 관점에서 설명합니다.
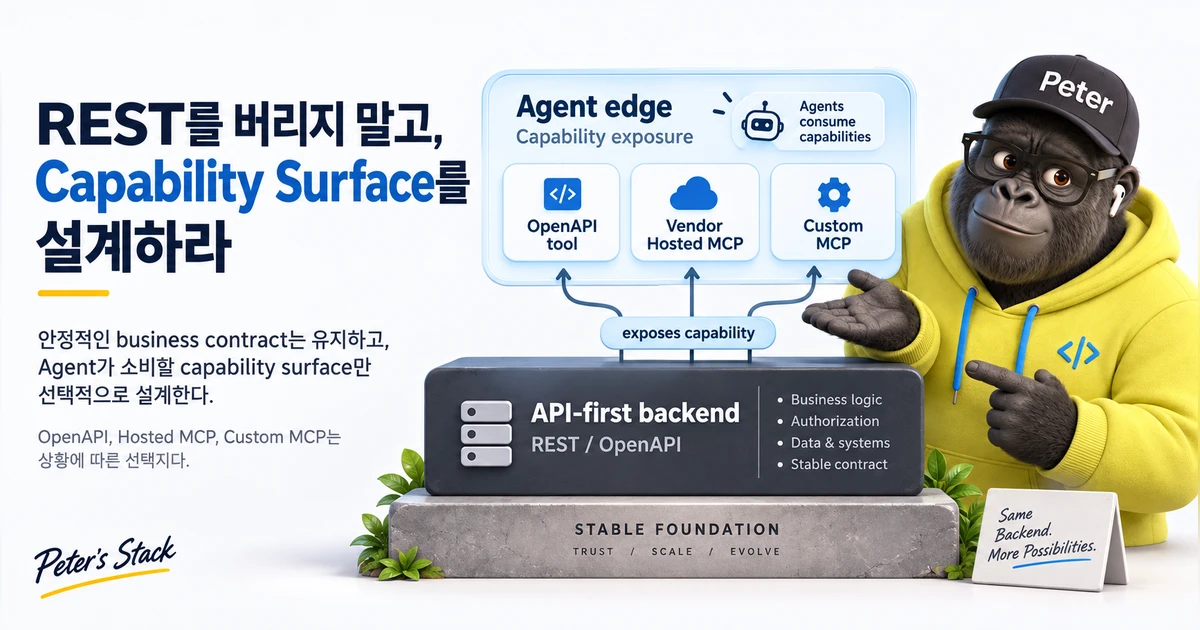
MCP가 확산된다고 기존 REST API를 모두 다시 만들 필요는 없다. OpenAPI, Hosted MCP, Custom MCP를 어떤 기준으로 조합할지 Enterprise Agent의 capability exposure 관점에서 정리한다.
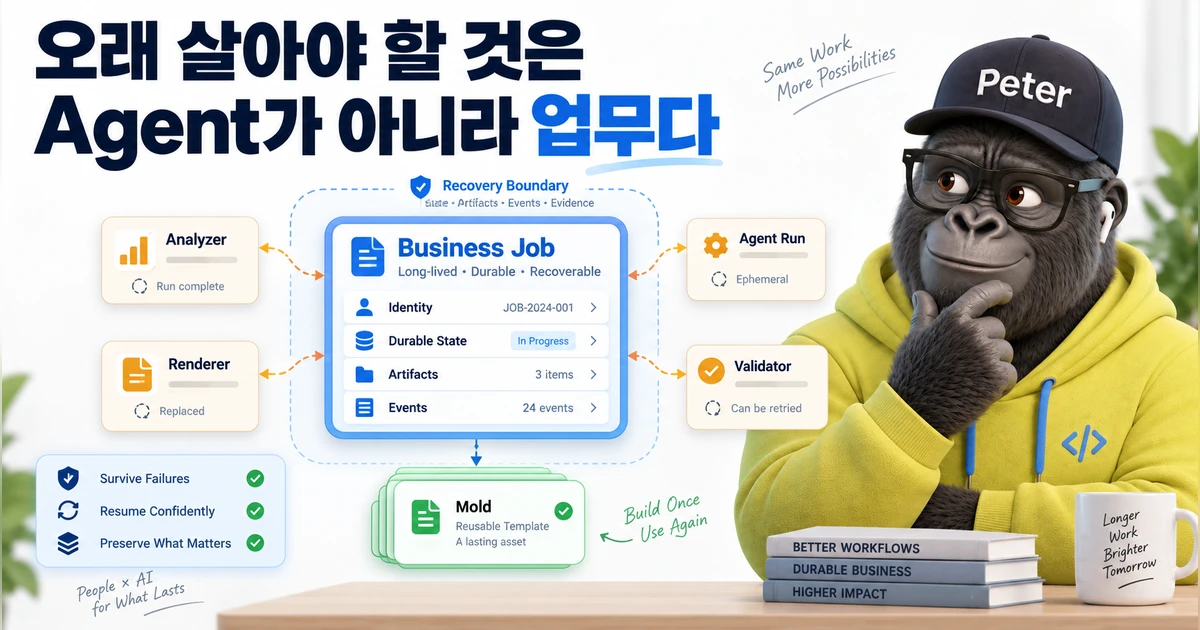
기업 PowerPoint 템플릿을 reusable mold로 만드는 관리자용 long-running 작업을 사례로, Agent Run과 Business Job을 분리하고 State·Retry·Resume·Replay·Idempotency를 설계하는 이유를 설명합니다.
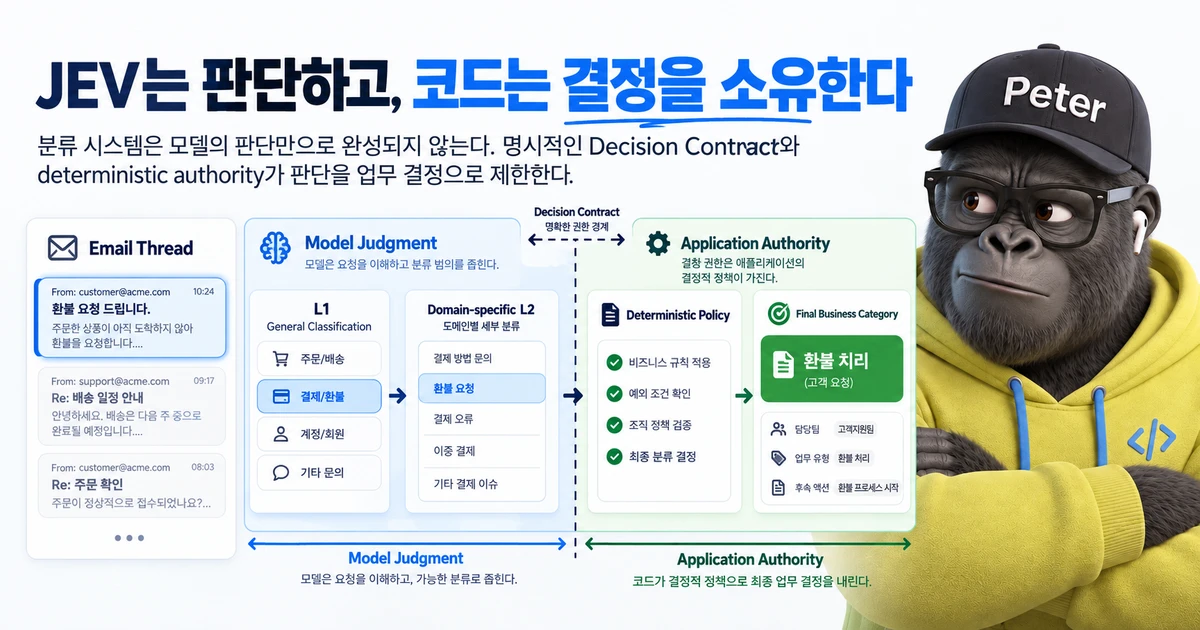
JEV와 n8n으로 이메일 분류 PoC를 직접 만들며 확인한 것은 모델 성능보다 Decision Contract의 중요성이었다. L1/L2, score·margin, deterministic resolver와 AUTO/REVIEW 경계를 실제 코드로 풀어본다.
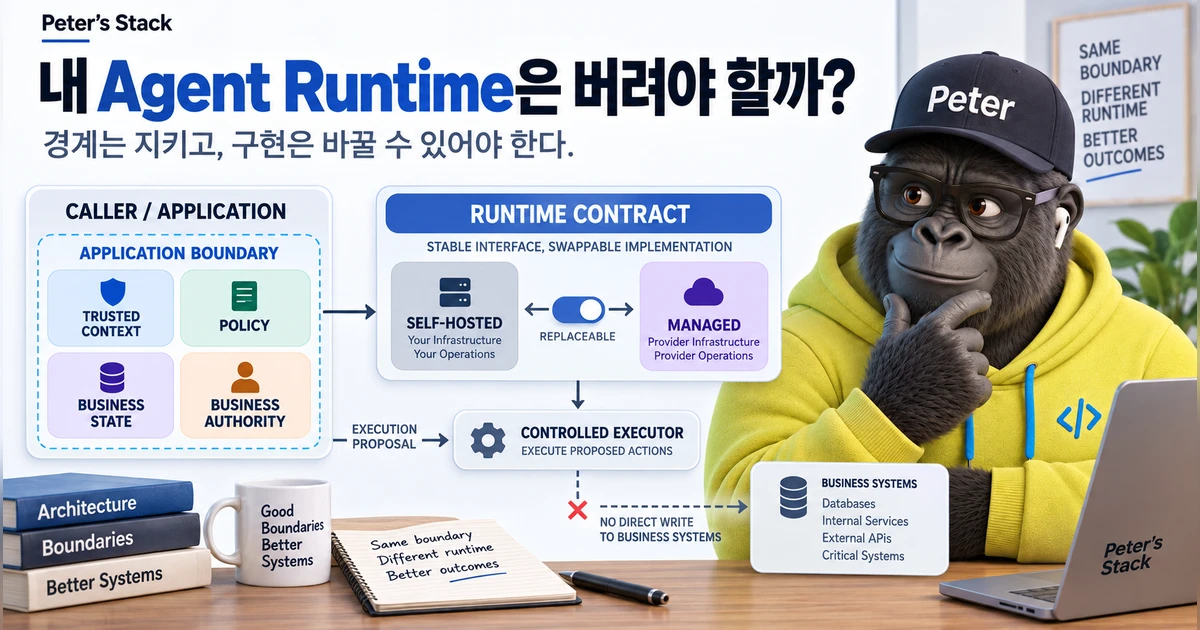
OpenAI Agents API가 managed Codex harness를 제공하기 시작했다. 직접 만든 self-hosted Agent Runtime에서 무엇을 버릴 수 있고, 어떤 application 책임은 끝까지 남겨야 하는지 교체 가능한 contract 관점에서 정리한다.